5.1 优化的目的与分类
5.1 优化的目的与分类
本节摘要:优化在语义不变的约束下降低程序的时间与空间代价,按作用范围分局部、循环、全局、过程间四档,按手段分改写、删除、重排三大类。本节建立优化 pass 的组织框架,算清收益与编译时间的经济账,并预告主线语句在本章的三次变身。
阅读完本节,你应当能够:
- 按作用范围与手段两个维度给任一优化归类
- 说明"语义不变"约束的具体含义与典型违例
- 解释优化分档(O0 到 O3)背后的经济逻辑
- 数出主线语句在本章将经历的三次改写
优化改的是什么
优化不改程序"算什么",只改"怎么算"。准确说,观察等价:对一切合法输入,程序产出的可观察行为(输出、退出码、可观察的副作用)完全一致。这个约束比"结果一样"严格——把除法挪到分支里提前执行,即使分支原本不会走到它,也可能触发本不会发生的除零崩溃,这就是改变可观察行为。
主线语句在本章的三次变身,先睹为快:
原始(中端交接): t1 = cvt_float(qty) ;qty 恒为 2 时 t2 = price * t1 t3 = t2 - discount ;discount 恒为 0.0 时 total = t3 变身一(常量折叠 + 强度削弱,5.2 节): t1 = 2.0 ;qty 是常量,转换可折 t3 = price + price ;乘 2.0 改加法;减 0.0 折掉 total = t3 变身二(临时变量消除,5.2 节死代码删除): total = price + price ;t1、t3 无人再用,坍缩成一条 变身三(进循环后,5.3 节): 若整句位于循环内且 price、qty 循环不变: 外提 t1 = 2.0 到循环入口,循环体只剩 total 的累加式改写
四条变一条,循环里再省一次转换——语义没动,代价肉眼可见地缩水。
两个分类维度
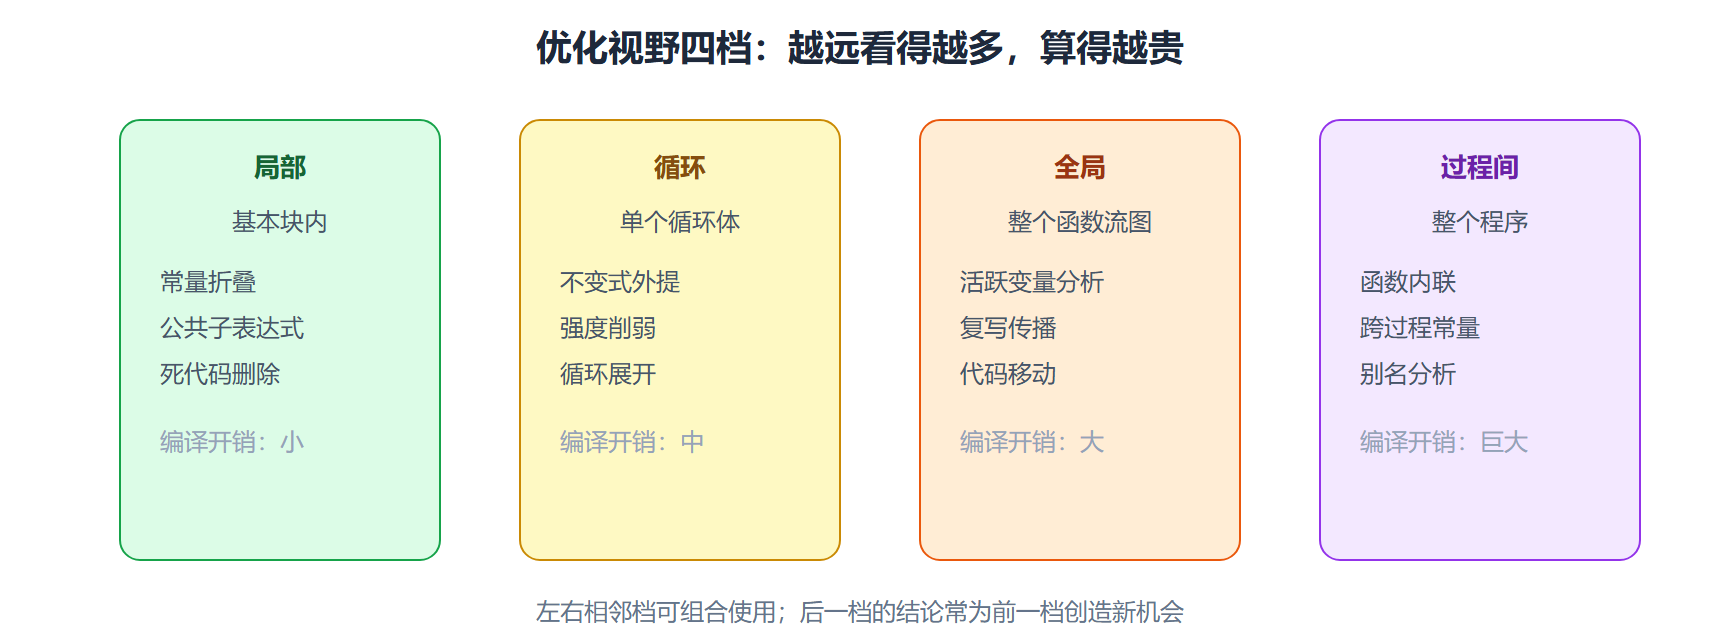
按作用范围,从近到远四档:
| 档位 | 视野 | 代表优化 | 本文章节 |
|---|---|---|---|
| 局部 | 一个基本块内 | 常量折叠、公共子表达式消除、死代码删除 | 5.2 |
| 循环 | 一个循环体 | 不变式外提、强度削弱、归纳变量替换 | 5.3 |
| 全局 | 整个函数(流图上) | 跨块的活跃变量、复写传播 | 5.4 |
| 过程间 | 整个程序 | 内联、跨过程常量传播 | 第 8 章 |
按手段三类:改写(把贵指令换便宜指令,如乘换加)、删除(把无用指令直接去掉)、重排(把指令挪到更划算的位置,如外提与调度)。任何一本编译器优化清单都能拆进这两个维度的矩阵里。
图 优化 pass 的组织:按视野分层装备
经济账:优化不是免费午餐
每条优化规则都要跑分析、做判定,都花编译时间。函数级的活跃变量分析要迭代到不动点,过程间的别名分析在大项目上可能让链接期优化拖上几分钟。所以优化分档出售:
O0:不优化。编译最快,变量位置稳定,调试器的单步与变量查看最友好 O1:轻量局部优化。编译稍慢,代码质量明显改善 O2:全局优化开满。多数项目的发布档位 O3:激进档。循环向量化、更狠的内联,可能反而伤性能(指令缓存压力) Os:以体积为目标的优化。嵌入式场景
旋钮的存在本身说明:没有全局最优的优化组合,程序特征决定哪个组合划算。矩阵乘法吃向量化,分支密集的解析器吃内联与跳转优化,同一档位收益天差地别。性能关键项目要做的事是实测,不是盲信档位。
⚠️ 常见误区:"编译器很聪明,我不用管算法。"再强的优化也改不动 O(n²) 到 O(n log n) 的算法差距——优化改善常数因子,算法决定量级。反过来,算法换好了之后,优化器在常数因子上的回报依然真实存在。两层各管各的。
💡 关键直觉:把优化器想成一组"外科医生团队",每人只会一种手术(一条规则),巡回病房(pass 序列)逐个找病人。手术顺序影响战果——删除死代码后可能暴露新的可折叠常量,所以 pass 常循环跑到不动点,或按经验手工排序。
分类之外的实战场
问:开了 O3 反而变慢是怎么回事? 三种常见机理。指令体积膨胀压垮指令缓存;激进内联改变代码布局破坏分支预测的局部性;向量化对访存密集循环徒增开销。优化器优化的是它建模的世界(指令数、依赖),真实芯片还有缓存、预取、功耗这些它看不见或只能近似建模的维度——模型与现实的裂缝,就是档位旋钮存在的原因。
问:调试版和发布版的行为差异全来自优化吗? 主体是。变量被折叠、语句被删除、浮点运算被重排(严格模式除外),断点与单步都会错位。另有一小部分来自内存布局差异:未初始化变量在两版里的垃圾值不同,把只在某版本复现的 bug 称为海森 bug——它在加观测时消失,根源常是未定义行为被不同优化档位放大。
问:优化器会不会改错程序? 理论上不允许,实践中的 bug 多出在两处:别名信息判断错误(把实际别名当无别名,删除了必要的重载)、浮点恒等变换越过语言模式约束。这正是各编译器优化 bug 报告的主力来源,也是阅读第 5.4 节保守原则时的现实注脚。
补一问:优化能不能自动发现程序里的算法 bug? 不能,但常能暴露。优化按语义等价变换,逻辑错误会原样保留甚至被放大呈现(死代码删除把从未执行的分支清掉,阅读汇编时错误逻辑一目了然)。有经验的工程师读优化后的汇编找逻辑漏洞,正是利用了优化器把源码意图压到最简的特性——它是放大镜,不是探测器。
再补一问:优化 pass 的顺序谁说了算? 编译器开发者定,不是自动求解。经验排序的原则是:便宜的先跑(局部手术给贵的分析创造更小的输入)、暴露机会的先跑(传播喂折叠)、收敛型的循环跑到不动点。这个顺序本身就是各编译器的经验结晶,改 pass 顺序做性能实验,是编译器团队的日常功课。
本节要点回顾
- 定义:观察等价约束下降低时间空间代价,语义红线不可越
- 范围四档:局部、循环、全局、过程间,视野换开销
- 手段三类:改写、删除、重排,一切优化可归入
- 经济账:O0 到 O3 分档出售,没有全局最优组合,实测为王
- 主线预告:四条指令在本章经历折叠、削弱、消除、外提四度瘦身
分类框架立好,下一节进手术室:基本块内的局部手术,四条指令先瘦成一条。