1.1 Julia简介与安装
1.1 Julia 简介与安装
Julia 是为科学计算设计的动态语言:写法接近 Python,运行速度接近 C,靠的是即时编译(JIT)与类型推断。本节从零开始装好环境,并在 REPL 里验证第一个程序。
动手装:三种方式选一种
我建议初学者直接用官方安装包,别在包管理器上浪费时间。三种方式怎么选:
安装方式决策图
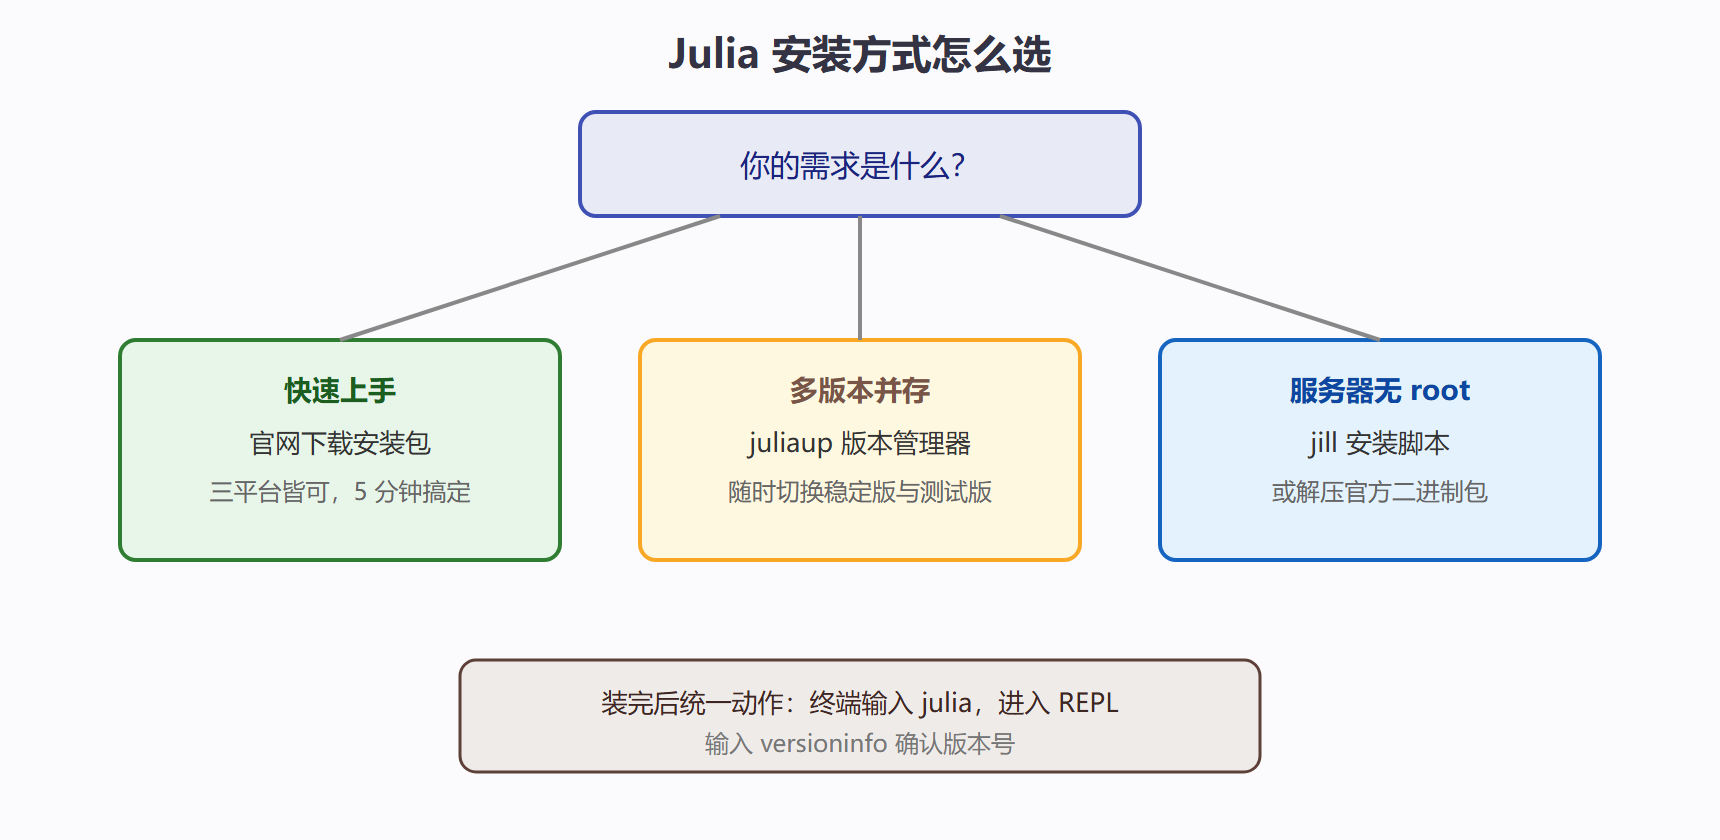
以官方安装包为例:打开 Julia 官网,下载当前稳定版(1.10 系列以上),Windows 双击安装、macOS 拖入应用程序、Linux 解压后把可执行文件链接到路径里即可。
第一次启动 REPL
在终端输入 julia 回车,会看到一只欢迎横幅和提示符:
julia>
先敲这三行,确认一切正常:
versioninfo() # 查看版本与系统信息 2 + 2 # 应输出 4 println("你好 Julia") # 应打印出中文
REPL 有几个模式值得现在就记住:按 ] 进入包管理模式(底部提示符变蓝),按 ; 进入 shell 模式,按退格键回到普通模式。第一次装包可以顺手做:
] add Plots
装完按退格返回,using Plots 就能用。
它凭什么快:一分钟版本
Julia 的速度不是玄学。一段 Julia 代码在运行前会经过:解析成表达式 → 类型推断 → 即时编译成机器码 → 缓存复用。第一次调用一个函数慢(在编译),第二次开始就是原生速度:
mysum(v) = (s = 0.0; for x in v; s += x; end; s) v = rand(10^6) @time mysum(v) # 第一次:编译开销计入 @time mysum(v) # 第二次:毫秒级,接近 C
⚠️ 常见坑:拿第一次
@time的结果评价 Julia 性能,会得出"Julia 很慢"的错误结论。测速永远测第二次以后。
Julia、Python、MATLAB 定位对比
| 维度 | Julia | Python | MATLAB |
|---|---|---|---|
| 运行速度 | 接近 C | 关键路径需 C 扩展 | 向量化后较快 |
| 语法负担 | 低 | 低 | 极低 |
| 生态广度 | 科学计算强 | 全领域最广 | 工程领域 |
| 商业授权 | 免费开源 | 免费开源 | 收费 |
我的判断:如果你的工作 80% 是数值计算、建模、仿真,Julia 值得投入;如果偏 Web、爬虫、运维脚本,Python 仍是更合理的选择。
装不上怎么办:三个高频故障的现场处理
新手在这一节翻车的地方高度集中,我按出现频率排一下。
第一个是 Windows 上装完双击没反应或闪退。多数是解压版没装依赖,改用官方安装包(.exe)重装基本能解决;装完在 PowerShell 里敲 julia 提示找不到命令,说明没加进 PATH,手动把安装目录加进系统环境变量即可。第二个是公司内网或代理环境下 ] add Plots 卡在下载。Julia 的包都放在 GitHub 上,代理要在进入 REPL 之前设好环境变量:
# 然后 julia 启动,再 ] add Plots
第三个是磁盘空间:默认包仓库在用户目录的 .julia 文件夹,C 盘紧张时可以用环境变量 JULIA_DEPOT_PATH 指到别的盘。这三件事处理完,90% 的安装问题就见底了。
用一个真实计算验证:手搓 vs 内置
光看 2 + 2 不过瘾,做一个稍微像样的小实验——对比自己写的循环求和与内置 sum 的差距,顺便体会"写法朴素但速度不亏"这个卖点:
mysum(v) = (s = 0.0; for x in v; s += x; end; s) v = rand(10^7) @time mysum(v) # 第一次含编译,约 0.2 秒 @time mysum(v) # 第二次约 0.01 秒 @time sum(v) # 内置版本,与手写同量级
关键解读:手写的 for 循环和官方 sum 速度在同一量级。这在纯 Python 里是不可想象的——Python 的循环比 NumPy 的向量化慢一两个数量级,所以 Python 用户被迫学向量化技巧;Julia 里循环就是一等公民,照着数学公式直译反而最快。这个认识会影响你后面所有的写码习惯:见到向量化先问"是为了清晰还是为了快"。
边界情况:版本与长期支持
Julia 的版本策略值得花两分钟了解。官方每隔约一年发布一个长期支持版(如 1.6、1.10),中途的小版本(1.11、1.12)更激进。我的建议是生产环境固定在 LTS 版,学习用最新稳定版即可——语法层面 1.6 之后的代码基本不需要改动。多版本共存交给 juliaup 管,一条 juliaup add 1.10 就能并存多个版本并随时 juliaup default 1.10 切换。还有一点:Julia 2.0 已在规划中,官方承诺大版本间通过 Compat 包做迁移提示,现在学的代码不至于作废,但读第三方包源码时留意它锁定的 Julia 版本区间,能省去不少"为什么报错"的排查时间。
验收脚本:一份可以留存的环境体检单
把安装验收固化成一段脚本,是老手的习惯——日后环境一旦出问题,先跑它就能快速定位。把下面这段存成文件,每次 include 进 REPL 执行:
function env_check() v = VERSION println("Julia 版本: ", v) threads = Threads.nthreads() println("线程数: ", threads, threads == 1 ? " (默认单线程,并行需 -t 启动)" : "") # 逐项检查包仓库是否可用 depots = Base.DEPOT_PATH println("包仓库位置: ", first(depots)) println("体检完成,环境可用") end env_check() # 体检完成,环境可用
这份体检单的价值在于把"环境好着吗"从感觉变成事实。比如包仓库被指到了网络盘,add 就会莫名变慢;线程数显示 1 却疑惑多线程代码不加速,都是日后真实会遇到的场景,届时回头跑一遍 env_check 往往一眼看穿。
Julia 能解决而脚本语言难受的典型场景
选型不能只看跑分,看场景更准。三种典型处境里 Julia 的优势最明显。其一,算法核心是自己写的循环与递归,例如蒙特卡洛模拟、格子玻尔兹曼方法:这类代码没法靠调用 NumPy 的 C 内核加速,Python 里只能忍受慢或改写 C,Julia 里直接就是原生速度。其二,需要交互式探索又能直接上生产:Julia 的 REPL 里验证的函数,放进包里编译后就是生产代码,没有"探索版"和"发布版"两套实现。其三,教学与科研代码要长期复现:Julia 的 Manifest 文件精确锁住每个依赖版本,五年后重跑仍能复原环境。反过来,如果你的场景是写网站后台、做运维胶水脚本,生态更厚 Python 明显合适——承认边界与宣传优势同样重要。
本节要点回顾
- 安装三选一:新手官网安装包,多版本用 juliaup,服务器用 jill 或解压二进制。
- 验证三件套:
versioninfo、算术、println,全通过即环境可用。 ]进包管理、;进 shell,退格返回,这两个快捷键天天用。- JIT 意味着首次调用慢,测性能看第二次。
- 选型判断:数值密集场景 Julia 优势最大。