7.1 运行时环境与存储布局
7.1 运行时环境与存储布局
本节摘要:程序运行时的内存分为代码区、静态数据区、栈区、堆区四大块:代码区装指令、只读;静态区装全局变量与常量,生命周期等于进程;栈区随函数调用自动进退;堆区由程序显式管理、生命周期自由。本节逐区拆解职责与代价,并为主线语句的变量指认住址。
阅读完本节,你应当能够:
- 画出四大区的布局并说明各区的读写权限与管理者
- 说明变量按声明方式落入哪一区,为主线语句四个变量定位
- 解释栈的自动回收与堆的手动或回收器管理的对比
- 描述静态分配、栈式分配、堆式分配三种策略的适用场景
进程内存的四张地契
操作系统加载一个可执行文件时,给进程的虚拟地址空间划出几块辖区。从低地址到高地址的典型布局:
高地址 ┌──────────────────────┐ │ 栈区 向下增长 │ 局部变量、活动记录 │ ↓ │ 自动管理,随调用进退 ├──────────────────────┤ │ 共享库等映射区 │ ├──────────────────────┤ │ ↑ │ │ 堆区 向上增长 │ 动态分配,显式申请释放 ├──────────────────────┤ │ 静态数据区 │ 全局变量、静态变量、常量 │ 已初始化 / 未初始化 │ 编译期就定好大小 ├──────────────────────┤ │ 代码区 只读 │ 机器指令、字面量 低地址 └──────────────────────┘
四区的关键属性对照:
| 区域 | 装什么 | 谁分配 | 何时生灭 | 大小 |
|---|---|---|---|---|
| 代码区 | 机器指令 | 编译链接期定死 | 进程生灭 | 定长 |
| 静态区 | 全局与静态变量 | 编译期定死 | 进程生灭 | 编译期可算 |
| 栈区 | 局部变量、帧 | 运行时自动 | 随函数调用返回 | 有限上限(常几兆) |
| 堆区 | 动态对象 | 程序显式申请 | 申请到释放 | 上限接近内存 |
主线语句的住址登记
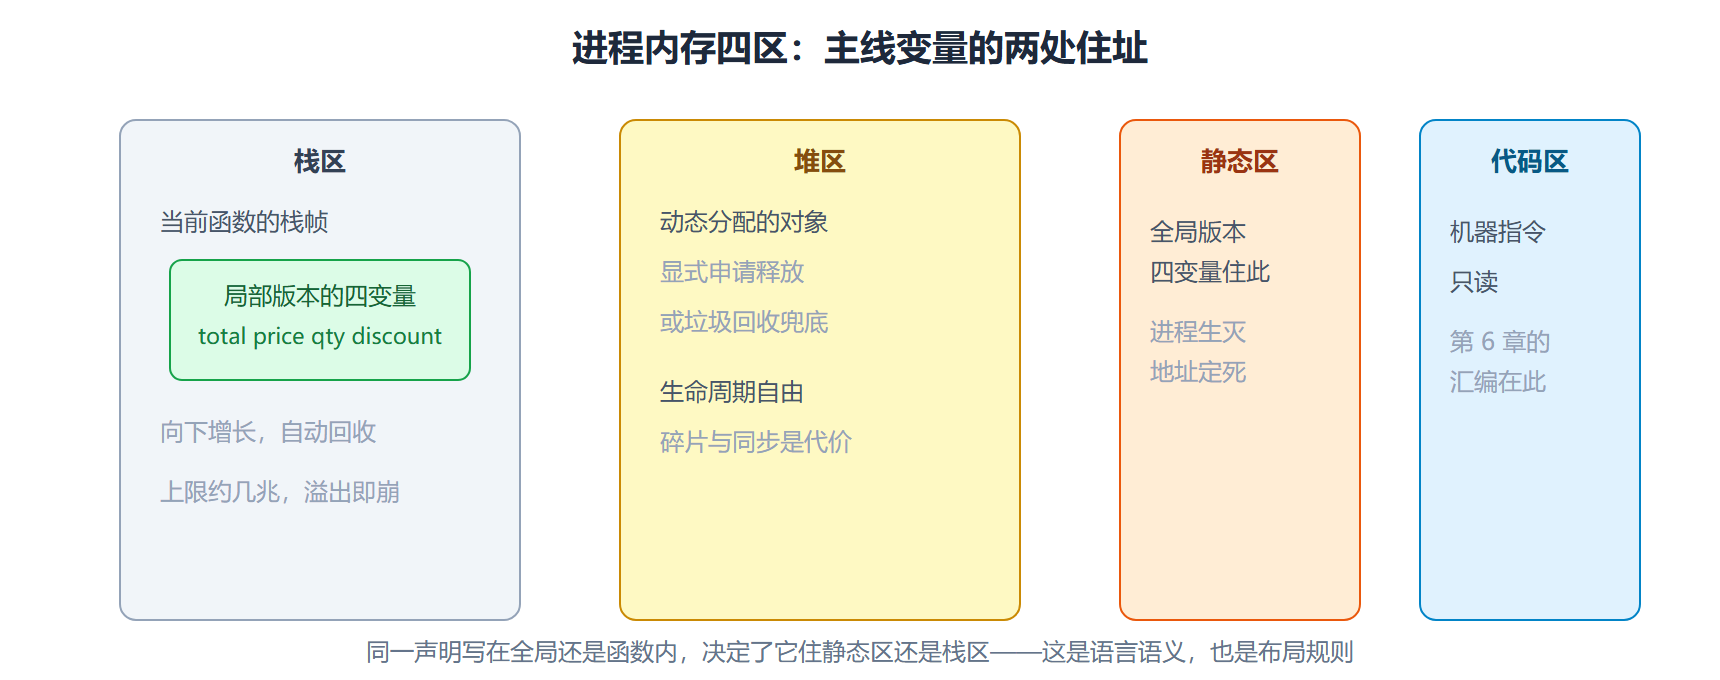
主线语句的四个变量按声明方式分住两区:
全局声明:float total, price, discount; int qty = 2; → 四个都在静态数据区:qty 在已初始化段(有初值 2), 其余在未初始化段(运行前清零)——编译期为每个变量定好固定地址 函数内声明(另一种情形):四个都进栈区 → 每次函数被调用,栈帧里给它们开槽,函数返回即销毁 → 第 6 章汇编里的 fp 减 12 之类偏移,就是相对帧基址的槽位号 动态分配(第三种情形):指向它们的指针在栈,对象本体在堆 → 申请即生、释放即死,生命周期与调用结构脱钩
三种策略各司其职:静态分配最快(地址编译期定死,指令直接写死地址)但最死板(递归不可用——同一变量只有一份);栈式分配几乎零成本(一条减法指令开帧)且天然支持递归;堆式分配最自由也最贵(分配器要找空位、考虑碎片、可能上锁)。
图 四大区布局与主线变量的住址
栈与堆:两种管理哲学的代价
栈像酒店的钟点房:进门登记(帧指针定位)、出门退房(栈指针一退),房间复用极快,但只能"后进先出"地用。堆像长租公寓:随时入住随时退租,自由但需要物业(分配器)——要记录哪些房间空着、退租后要考虑合并碎片、多线程要加锁或分区。代价对比落到数字上:栈上开一个变量几乎免费(帧开辟指令本来就有一条),堆上一次分配通常几十到几百个周期。这也解释了一条经典工程准则:能用栈不用堆,能用对象池不直接堆分配。
栈的纪律还有安全面:缓冲区溢出攻击正是向栈帧里的数组越界写,覆写返回地址劫持控制流——现代系统的栈保护(金丝雀值)、不可执行栈等防御,全在与栈的"后进先出但可越界"的弱点周旋。
⚠️ 常见坑:返回指向栈上局部变量的指针。函数一返回帧就销毁,指针指向的内存立刻可被下一次调用覆写——读到的值是垃圾。C 与 C++ 里这是未定义行为;有垃圾回收的语言靠"逃逸分析"把这类变量自动搬家到堆上,编译器替你付堆的代价。
💡 关键直觉:四大区的划分本质是按"生命周期的规律性"分拣——最规律的(指令、全局)放定长区,与调用同呼吸的放栈,完全自由的放堆。生命周期越有规律,管理成本越低;自由是有价格的。
布局的现场问答
问:栈的大小谁来定? 可以由链接脚本、编译选项、线程创建参数指定,操作系统只给默认值与上限。调大栈治标不治本:深递归该改成显式栈的迭代,才是根除。观察栈用量的朴素办法是把栈内存填成特征字节再跑一遍看未被覆盖的深度——嵌入式调试的经典土法,比任何工具都直观。
问:为什么堆和栈要相向生长? 让两者共享同一块剩余空间:任意时刻谁需要多少谁多占,不必预先分割边界。这是虚拟内存时代最优雅的布局遗产。当然代价也存在:两者相撞即内存耗尽,栈撞堆与堆撞栈的报错方式常常令人迷惑。
补一问:程序能自己感知这些布局吗? 有限地能。取局部变量地址得到栈区地址、取函数名地址得到代码区地址,两者对比即可大致推断布局;链接脚本与映射工具能给出精确地图。运行时利用布局信息的实例不少:地址随机化防御(打乱各基址)、栈地址探测、按地址做缓存对齐——布局不是抽象概念,是可观测的物理事实。
再补一问:垃圾回收的堆和手写管理的堆布局一样吗? 底层内存区块相同(都向系统批发页再零售),上层组织不同:回收器要按对象组织(带头部、按代分区域、卡表记录跨代指针),手写管理按分配块组织(空闲链表或尺寸桶)。所以有回收的语言里对象头与分代结构,就是堆布局里多出来的一层家具。
看懂这层家具的差异,遇到堆布局相关的性能问题就能先问一句:这里的堆归谁管、按什么组织。另外,多线程程序每条线程有独立栈(布局同构、大小独立),堆则全进程共享——这也是线程崩溃常表现为栈溢出、而内存泄漏总在堆里的结构原因。
本节要点回顾
- 四区分工:代码只读、静态定死、栈随调用进退、堆显式管理
- 三种分配策略:静态最快最死、栈近乎免费支持递归、堆自由而贵
- 住址规则:声明位置决定落区,同一名字全局与局部分住两区
- 栈堆对比:钟点房对长租公寓,自由换管理成本
- 安全联动:缓冲区溢出攻击栈结构,防御机制围绕栈弱点设计
住址定了,下一节看函数调用时的交接仪式:参数传递的四种方式,同一个调用能推出四种不同结果。