7.3 过程调用与活动记录
7.3 过程调用与活动记录
本节摘要:每次函数调用在栈上创建一张活动记录(栈帧),装着返回地址、保存的寄存器、参数、局部变量与临时值;调用序列与返回序列这对镜像指令流负责帧的搭与拆。本节拆解栈帧六件组成、写出完整的调用返回指令序列,并用递归验证"每层一帧"的机制,最终把主线语句放回它的帧里跑完全程。
阅读完本节,你应当能够:
- 画出活动记录的完整布局并说明每件的用途
- 写出调用序列与返回序列的指令流
- 解释递归为何无需特殊机制、爆栈的成因
- 把主线语句的四条汇编放回栈帧语境,讲出完整执行过程
栈帧六件套
活动记录从高地址到低地址的典型布局(以帧指针 fp 定位):
高地址 ┌──────────────────────┐ │ 实参区(或寄存器溢出区)│ fp+16 起(由调用方或被调方放) ├──────────────────────┤ │ 返回地址 │ fp+12:call 指令自动压入 ├──────────────────────┤ │ 旧的 fp(控制链接) │ fp+8:用于返回时恢复调用方帧 ├──────────────────────┤ │ 保存的寄存器 │ fp+4:被调方要用的保留寄存器先存 ├──────────────────────┤ fp → │ 局部变量与临时值 │ fp 减偏移:price 在 fp-12, │ │ qty 在 fp-16,total 在 fp-4 ... │ 帧内总大小编译期定死 │ 低地址 └──────────────────────┘ sp 指向帧底
六件各有来历:参数区按调用约定放(前几参数走寄存器,多余的进栈);返回地址由 call 指令自动压入;旧 fp 由被调方第一条指令保存——这是帧链的关节,调试器的调用栈回溯就沿着这条链走;保存寄存器区放被调方"借用"的保留寄存器原值;局部变量区就是主线语句四个名字的家(若声明在函数内);临时值区放第 4 章发号的 t1、t2 们(若没分到寄存器)。
调用序列与返回序列
搭帧与拆帧是一对镜像。以 ARM 风格写一个最小完整例:
调用方(call 序列): mov r0, price值 ;前几个参数进约定寄存器 mov r1, qty值 bl compute_total ;跳转并自动把返回地址存入 lr 链接寄存器 被调方开头(prologue,搭帧): push {fp, lr} ;保存旧帧指针与返回地址(一步两件) mov fp, sp ;锁定本帧基址 sub sp, sp, 24 ;给局部变量开 24 字字节槽位 push {r4, r5} ;借用保留寄存器前先存 被调方主体: ldr r2, [fp, #-12] ;载入 price——主线语句上场 vadd.f32 s0, s2, s2 ;浮点自加(或整型 add r3, r2, r2) str r3, [fp, #-4] ;total 存回自己的槽 被调方结尾(epilogue,拆帧): pop {r4, r5} ;恢复借用的寄存器 mov sp, fp ;栈指针一退,局部区整体销毁 pop {fp, pc} ;恢复旧帧指针,返回地址直接进 pc 完成返回
三个细节。sub sp, sp, 24 一条指令开出整个局部区——空间"分配"的成本是一减法。mov sp, fp 一条指令销毁它——不是逐变量清理,是整帧消失。pop {fp, pc} 把返回地址弹进程序计数器,返回与恢复一气呵成。帧的生命周期 = 两条指令之间,这个极简设计是栈式管理的全部秘密。
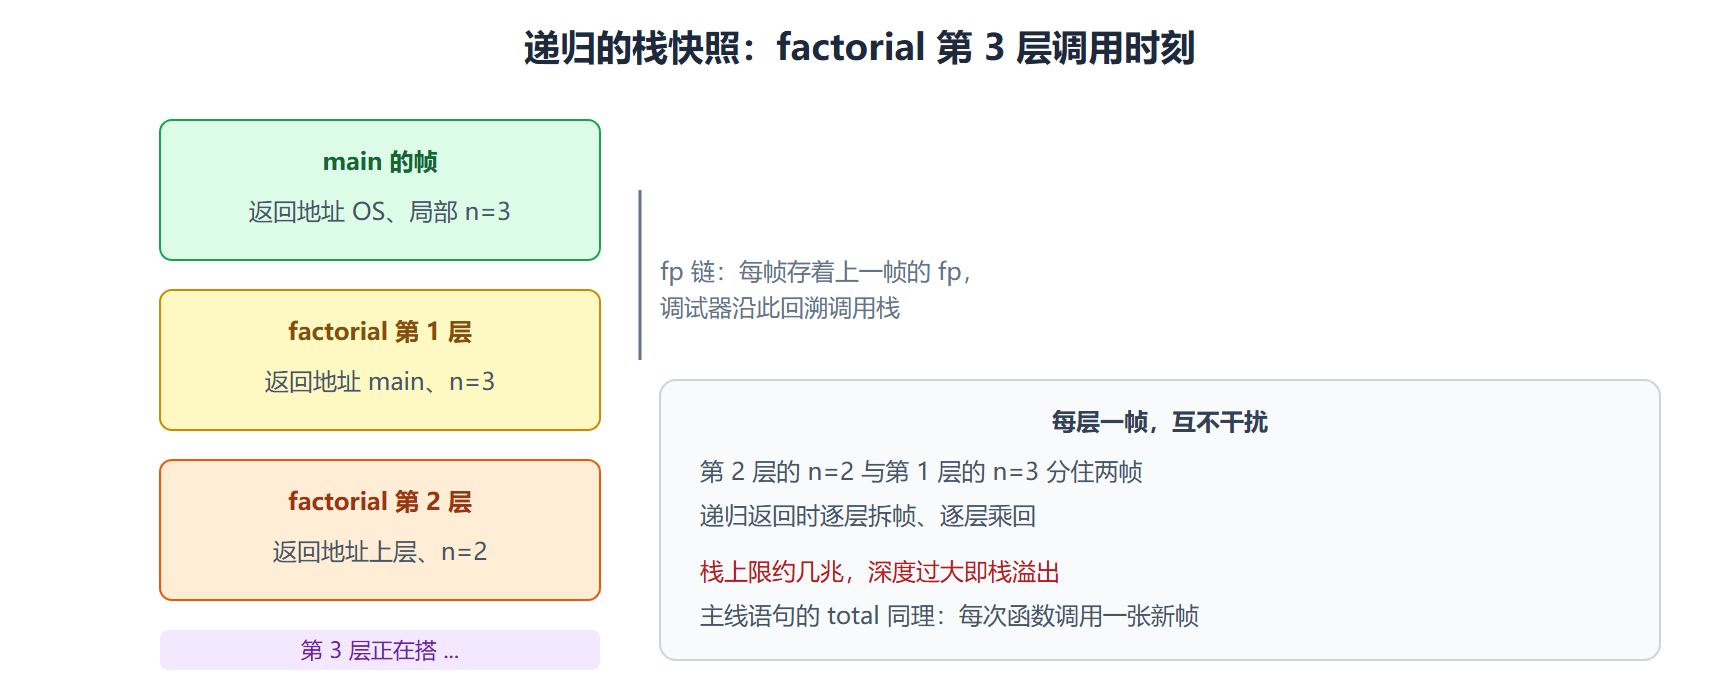
图 栈帧进退:递归三层的快照
主线语句的最后一幕
把全书主线放回帧里,完整走一遍:函数被调用,prologue 搭帧;price 从 fp-12 载入寄存器;add 完成加法;结果存回 fp-4 的 total 槽;epilogue 拆帧,若 total 是返回值则已按约定放进 r0,随 pop pc 回到调用方。至此,这行源代码完成了从字符到值的全部旅程——七个章节前它是 33 个字符,此刻它是一个躺在栈帧里、即将随返回值流向下一层调用的浮点数。
递归与爆栈
递归不需要任何特殊机制:每层调用照常执行调用序列,栈上多一张帧,各层的 n 各住各的槽。返回时逐层拆帧、逐层合并结果。唯一的代价是空间——每层一张帧,深度一万层的递归要一万张帧,栈上限(典型一到八兆字节)触顶即栈溢出。尾递归是例外中的机会:若递归调用是函数最后一个动作,编译器可以把它改成跳转(复用当前帧),深度不再受限——函数式语言的循环就靠这个变换实现。
⚠️ 常见坑:以为局部变量"便宜"就随意在函数里开大数组。几十万的整型数组直接把帧撑爆。栈适合小对象,大块数据走堆——帧大小在编译期定死,超大帧是设计缺陷,编译器也会对超大栈帧发警告。
💡 关键直觉:调用序列与返回序列是编译器和硬件的"交接仪式",约定(调用约定)写明谁压参数、谁清栈、哪些寄存器要保存——正是这个约定让分开编译的模块能互相调用。跨语言调用(C 与汇编互调、外部函数接口)的全部复杂性,就在于两套约定要对齐。
帧外的最后一问
问:调试器怎么知道调用栈长什么样? 三条线索。帧指针链(每帧存的旧 fp)串起所有帧;返回地址列表给出每层调用的位置;调试信息(符号表子集)把地址翻译回函数名与行号。栈回溯功能就是沿 fp 链走一遍、逐帧查表。优化档位一开,帧指针可能被省掉(腾出寄存器),调试器只能靠更复杂的栈展开信息还原——你调试时看到的调用栈,本身就是运行时环境设计的直接展示。
补一问:尾调用优化和尾递归优化是一回事吗? 尾调用是泛称:函数最后一个动作是调用别的函数,理论上都可以改成跳转复用当前帧;尾递归是特例(调的是自己)。前者还附带跨函数的好处(互相递归的状态机不再叠栈)。语言层面显式保证尾调用优化的不多,工程上递归改循环仍是稳妥选择。
本节要点回顾
- 六件套:参数区、返回地址、旧 fp、保存寄存器、局部变量、临时值
- 一对镜像:prologue 两条指令搭帧,epilogue 两条指令拆帧,帧一生只在两条指令之间
- 帧链:旧 fp 串成链,调试器沿链回溯调用栈
- 递归机制:每层一帧天然隔离,代价是栈深,尾递归可优化为跳转
- 主线终点:total 在帧里得值,随返回序列交还调用方——旅程闭环
单条语句的旅程到此圆满。最后一章拉远镜头:过程间优化、并行编译与 JIT,看编译技术的更远处。