2.3 常用数据结构
2.3 常用数据结构
选容器就是选性能特征:数组是 Julia 的一等公民、连续内存、可广播;元组编译期定形零开销;字典与集合是哈希表,查询快但无序。本节把四类容器的创建、访问、变更一次练完。
数组:从创建到视图
zeros(3) # [0.0, 0.0, 0.0] zeros(Int8, 2, 2) # 指定类型与维度 ones(2, 3) rand(4) # 均匀随机 randn(3, 3) # 标准正态矩阵 collect(1:5) # 范围转数组 [1 2; 3 4] # 字面量矩阵 reshape(1:6, 2, 3) # 重排形状,不复制
高维索引、切片、拼接:
M = [1 2 3; 4 5 6] M[2, 3] # 6 M[end, :] # 最后一行 M[1:2, 1:2] # 左上角块(复制) @view M[1:2, 1:2] # 视图(不复制,大数组上省内存) vcat([1,2], [3,4]) # 纵向拼接 hcat([1 2], [3 4]) # 横向拼接
💡 关键直觉:科学计算里 90% 的性能问题出在"该用视图时用了切片"。切片每次都拷贝;循环里反复
M[:, j]等于反复分配内存。加@view一个宏就能救回来。
元组:零成本的固定组合
t = (1, "a", 3.14) # 位置访问 t[1] # 1,注意元组也从 1 开始 nt = (name="Julia", year=2012) nt.name # 具名元组,字段访问 function minmax(v) (minimum(v), maximum(v)) # 返回多个值其实就是返回元组 end lo, hi = minmax([3,1,4,1,5])
元组不可变、长度和类型编译期已知,函数传参、返回多值都靠它,没有运行时开销。
字典与集合:哈希双雄
d = Dict("a" => 1, "b" => 2) d["c"] = 3 # 新增 d["a"] # 读取,键不存在会抛 KeyError get(d, "z", 0) # 带默认值的读取 delete!(d, "b") for (k, v) in d println("$k -> $v") end s = Set([1, 2, 2, 3]) # {1,2,3} push!(s, 4) in(3, s) # true,O(1) union(s, Set([4, 5])) # 并 intersect(s, Set([2, 4])) # 交 setdiff(s, Set([1])) # 差
⚠️ 常见坑:需要计数统计时,别用
Dict{String,Int}手动维护,标准库的StatsBase.countmap或count函数一行搞定且更快。
四类容器多维对比矩阵
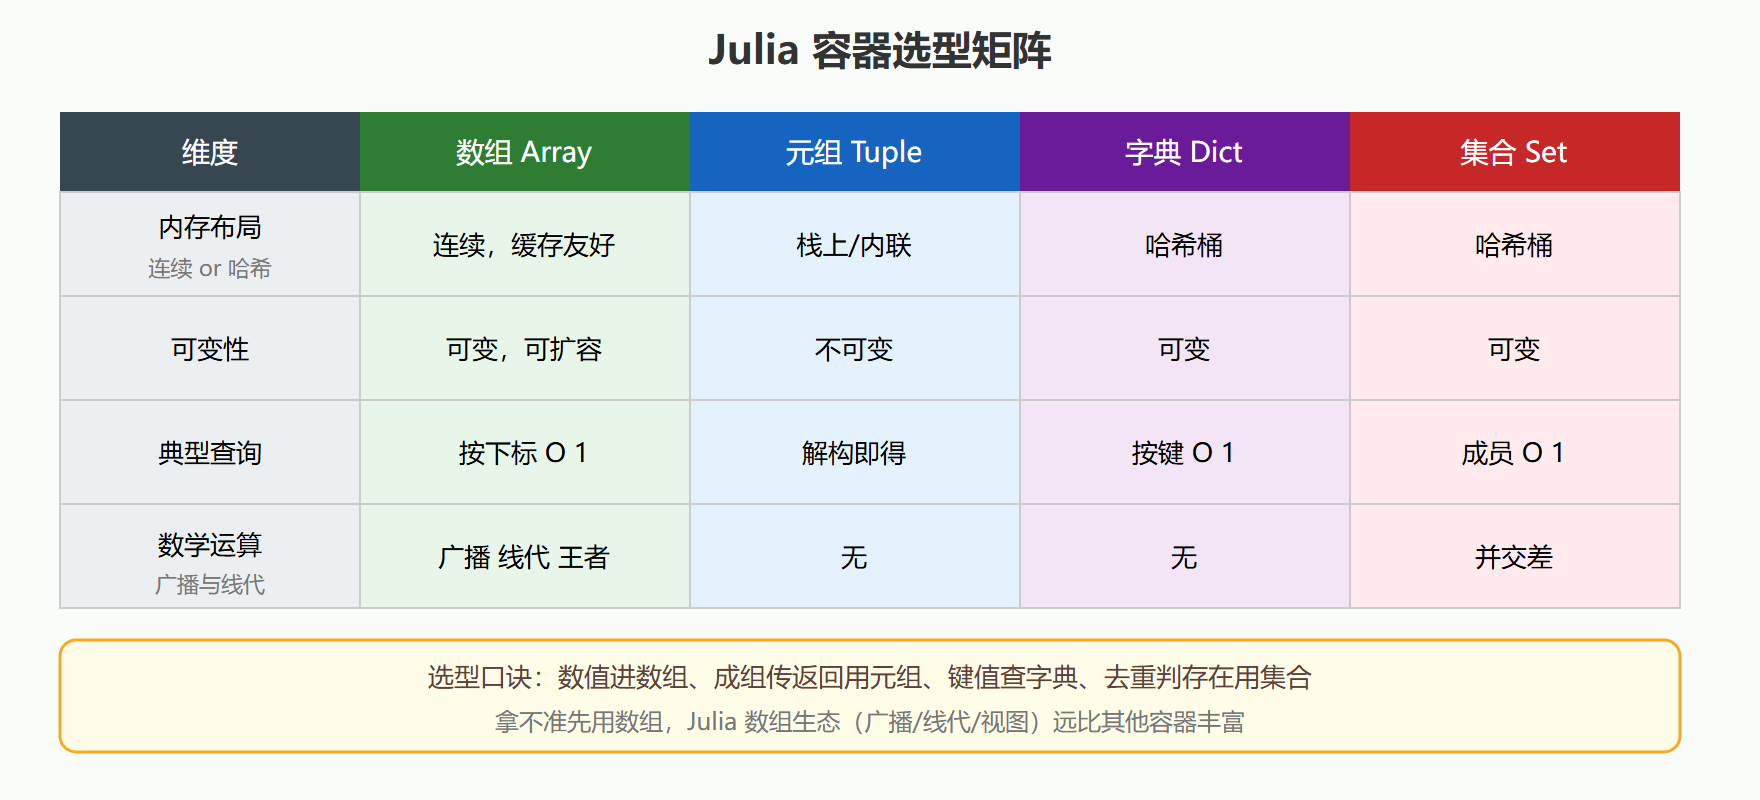
当栈和队列用:数组的两端操作
Julia 没有独立的栈和队列类型,数组加几个函数就够。栈操作用 push! 与 pop!(都在尾部,O(1) 均摊);队列用 push! 进、popfirst! 出(注意 popfirst! 是 O(n),小规模无所谓,大规模要换思路):
stack = Int[] # 空的整数数组 push!(stack, 1); push!(stack, 2) pop!(stack) # 2,后进先出 queue = String[] push!(queue, "a"); push!(queue, "b") popfirst!(queue) # "a",先进先出
函数名带感叹号是 Julia 的约定:修改参数的函数以 ! 结尾,看到感叹号就要想到"我的数据会被改"。这个约定贯穿整个生态,读别人代码时能少一半疑惑。
一个易踩的坑:数组别名
a = [1, 2, 3] b = a # 没有复制,b 和 a 指向同一块内存 push!(b, 4) a # [1, 2, 3, 4]——a 也"被"改了 c = copy(a) # 真复制 d = deepcopy([1, [2, 3]]) # 嵌套结构要 deepcopy 才彻底
赋值传递的是引用,这和 Python 一致,但 MATLAB 用户几乎必踩——MATLAB 的数组赋值是值语义。函数间传大数组时这个语义反而是优点(零拷贝),只要警惕"函数内部修改了入参"的副作用即可。
容器操作的性能直觉
| 操作 | 复杂度 | 说明 |
|---|---|---|
| v[i] 数组按下标 | O(1) | 连续内存,缓存友好 |
| push!(v, x) 尾部追加 | O(1) 均摊 | 容量按倍数扩张 |
| d[k] 字典取值 | O(1) 均摊 | 哈希表 |
| in(x, v) 数组成员判断 | O(n) | 要线性扫 |
| in(x, s) 集合成判断 | O(1) | 哈希表 |
| v[1:end-1] 切片 | O(n) | 复制了数据 |
一个真实教训:判断"某个 ID 在不在一万个元素的列表里"写成了对数组的 in,外面还套了循环,整体退化成千万次比较;把列表先转成 Set,同样的代码立刻快了三个数量级。选容器的本质就是选这张表。
案例:词频统计的三种写法与取舍
拿一个真实任务把容器选型落地:统计一段文本的词频。背景是这活儿看似简单,容器选错则代码又慢又绕。第一种写法用数组与 filter 逐词查表,O(n²),词表一大就卡死。第二种用字典按惯例手写:
text = "to be or not to be" counts = Dict{String,Int}() for w in split(text) counts[w] = get(counts, w, 0) + 1 # 不存在则从 0 起计 end counts # Dict("to"=>2, "be"=>2, "or"=>1, "not"=>1)
操作要点在 get 带默认值那一行,它把"键不存在"的分支压成了一次调用,避免了 try/catch 或 haskey 预检查的啰嗦。第三种是结果排序展示:
sorted = sort(collect(counts); by = p -> -p[2]) # 2 元素数组:["to"=>2, "be"=>2, ...],按频次降序 for (w, c) in sorted[1:min(3, end)] println(rpad(w, 8), c) end
解读与变式:collect 把字典变成「键值对数组」才能排序,因为字典本身无序;若数据来自十万个文档,改用 StatsBase.countmap 一步到位。这个案例里数组、字典、元组各就其位——统计靠字典、排序靠数组、遍历产出元组,正对应开篇那句"选容器就是选性能特征"。
本节要点回顾
- 数组创建记住
zeros / ones / rand / randn / reshape五件套; - 切片复制、视图不复制,循环内优先
@view; - 元组用于多返回值与编译期常量组合,零开销;
- 字典用
get带默认值,避开KeyError; - 集合做去重与成员判断,O(1) 且语义清晰。