3.3 元编程
3.3 元编程
元编程 = 把代码当数据操作。Julia 程序在执行前先被表示为表达式(
Expr),宏在这层表达式上做变换,再交给编译器。你已经用过的@time、@threads、@view全是宏——本节搞懂它们的原理,并写出一个自己的宏。
表达式:代码的另一种形态
在任意表达式前加冒号,得到的不是结果而是代码本身:
expr = :(a + b * c) # 代码对象 typeof(expr) # Expr expr.args # [:a, :b, :c] 之类的符号与子表达式
用引用块看更大的例子:
quote x = 1 x + 2 end
也可以手工构造表达式再求值,这能直观感受"代码即数据":
e = Expr(:call, :+, 1, 2) # 手工拼一个"调用 + 函数"的表达式 eval(e) # 3
从源码到机器码的变换链
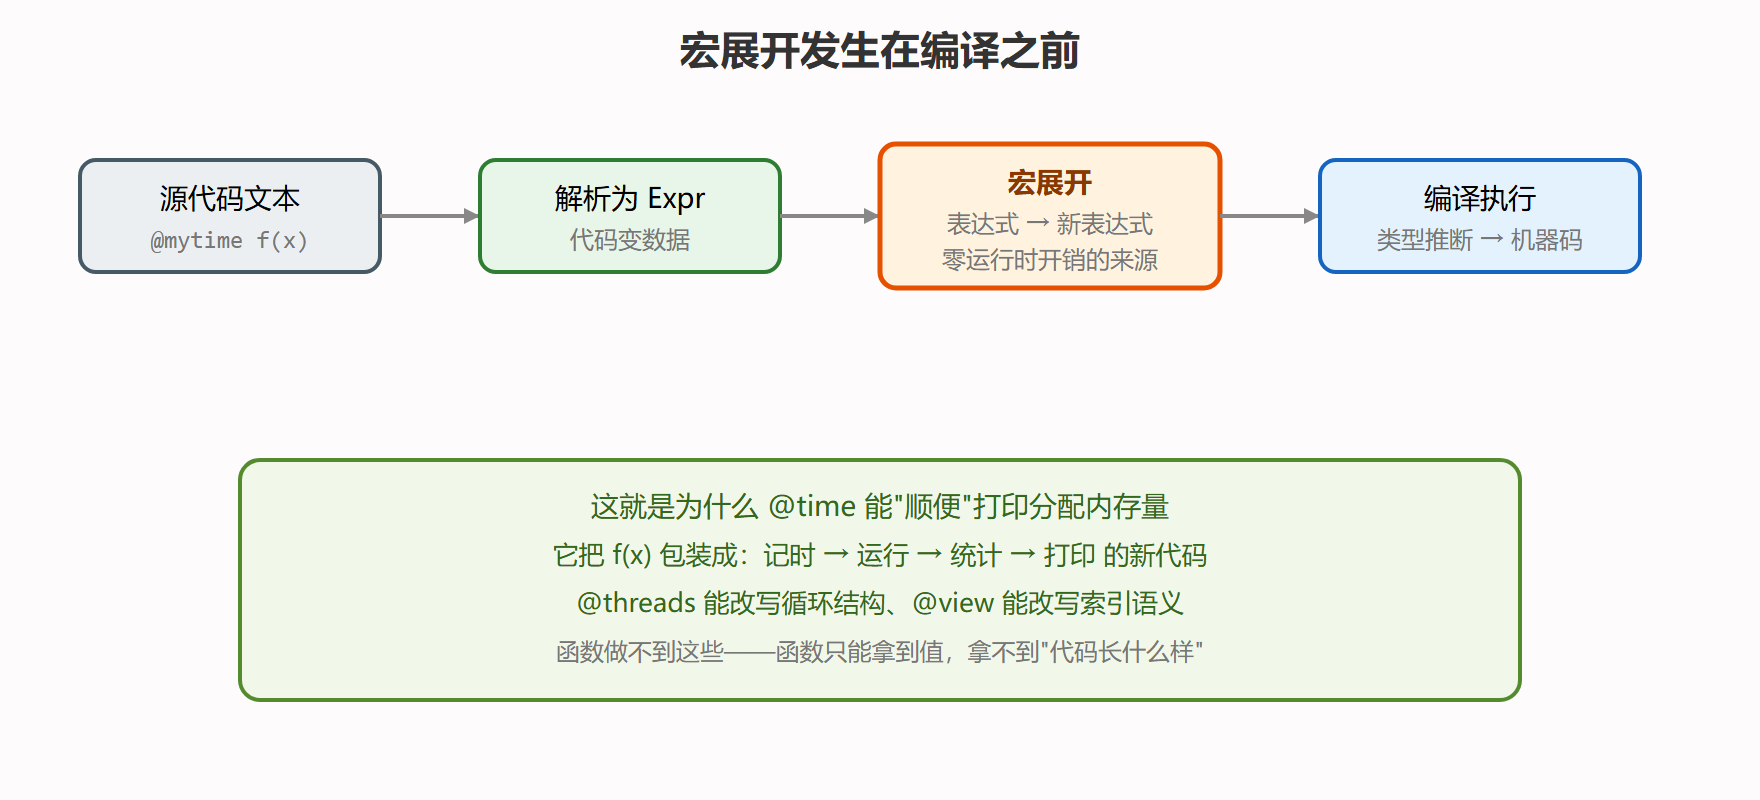
动手写第一个宏
目标:@unless cond body,条件不成立时才执行。先写函数版感受局限,再上宏:
macro unless(cond, body) quote if !$(esc(cond)) $(esc(body)) end end end @unless 1 > 2 begin println("条件不成立,所以我执行了") end
两个必备动作:quote ... end 构造返回的表达式;esc(...) 告诉展开器"这里面的名字在调用处解析",不加 esc,宏里的变量会被当成宏定义处的作用域,产生神秘 bug。
调试宏的利器是看展开结果:
@macroexpand @unless 1 > 2 println("hi")
⚠️ 常见坑:宏接收的是"未求值的表达式",不是值。
@mytime sleep(1)里宏拿到的是sleep(1)这段代码而不是睡眠结果——想通这一点,宏就从玄学变成普通工具。
什么时候用宏,什么时候不用
| 场景 | 用宏? | 理由 |
|---|---|---|
| 改变代码结构(改写循环/索引) | 是 | 只有宏看得到结构 |
| 需要编译期信息(类型、表达式) | 是 | 函数拿不到 |
| 只是"打包几步操作" | 否 | 普通函数更简单、可测试 |
| 想避免函数调用开销 | 通常否 | Julia 函数调用本来就被内联优化 |
案例:用表达式生成一批同构函数
背景:数值程序里常有"为每种算子生成一个求值函数"的需求,手写十个几乎一样的函数既枯燥又易错。用表达式生成一步到位。第一步,写出目标函数的样子(以两种范数为例):我们希望有 norm1(v) 与 norm2(v)。第二步,用代码生成:
for (name, p) in (:norm1 => 1, :norm2 => 2) @eval begin function $(name)(v::Vector{Float64}) # 向量 p-范数:sum(|x|^p)^(1/p) s = 0.0 for x in v s += abs(x)^$p # $p 把当前的 1 或 2 焊进代码 end s^(1.0/$p) end end end norm1([3.0, 4.0]) # 7.0,一范数 norm2([3.0, 4.0]) # 5.0,勾股定理
解读:@eval 在循环里执行"拼表达式 + 立刻定义"两步,$p 的插值把循环变量的值固化进函数体,因此生成的两个函数里没有循环痕迹,运行时零额外开销。变式:把幂次列表扩到 (1,2,4,8),一次循环得四个特化函数;再对照 2.2 会发现这是"多重派发之外另一种一对多"的手段——派发按运行类型分,生成按编译期参数分。
常见错误与排错
- 忘了
esc:宏内变量被错误地在宏定义处解析,症状是"明明调用处有这个变量却报未定义",修法是给用户传入的每个表达式包esc; - 宏名与变量名撞车:宏调用
@name x与表达式@name(x)等价,但写成x @name就不是调用了,熟悉函数写法的人容易在无括号场景翻车; - 在宏里做计算:宏展开发生在编译期,展开时做不了运行期才能确定的事(读文件、问用户输入),这类逻辑要留在展开后的代码里执行;
- 调试不展开:任何宏的怪异行为,第一步永远是
@macroexpand,看展开结果比盯宏定义快十倍。
代码生成的另一面:generated function 一瞥
比宏更进一步的还有"生成函数":函数签名前标 @generated,第一次调用时用参数类型信息现场生成函数体并缓存。标准库里矩阵乘法对特殊形状的特化就靠它。日常不建议自己写——难调试且易踩失效条件——但读核心库源码遇到 @generated 时知道它在做"按类型定制代码"的事即可,与本章主线一脉相承。
概念辨析:宏、函数、生成代码三者边界
三者容易糊成一团,用"拿到什么、返回什么"切干净。函数拿到的是值、返回的是值,一切发生在运行期;宏拿到的是表达式(代码本身)、返回的也是表达式,一切发生在展开期(编译前);@eval 生成代码则拿运行中的数据拼出表达式再定义,发生在"程序运行当中的某个时刻"。举例对照:sort(v) 是函数;@elapsed sort(v) 是宏(它要把 sort(v) 这段代码包进计时逻辑再展开);循环里按配置动态生成 norm4 是代码生成。选型时按这个顺序问:传值够不够?不够是因为要看代码结构吗?都不是、只是要按数据造定义,才轮到 @eval。把这条判断链走顺,本节的所有工具就都有了明确的使用理由,而不是"看起来都很炫"。
卫生宏与符号逃逸的另一面:gensym
esc 解决"调用处的名字在调用处解析",反向问题则是宏展开时生成的临时变量可能与调用处变量撞名——@unless 的 quote 里若引入 tmp 这类中间名,用户代码里恰好也有 tmp 就会被覆盖。解法是 gensym():生成一个保证不与任何源码符号冲突的新符号。标准做法是临时变量一律 local tmp = gensym() 再 $tmp 插值,展开后的代码里没有可预测的裸名字。数值库写宏时还会配合 Expr(:let, ...) 显式圈定作用域。判断是否踩了卫生坑的试金石:@macroexpand 打印展开结果,凡是没带模块前缀而裸用的名字都可能泄漏。
本节要点回顾
- 代码即数据:
:(...)与quote产出Expr,eval可执行; - 宏在编译前展开,变换代码零运行时成本;
esc保住调用处作用域,@macroexpand是调试眼睛;- 宏不是性能银弹,函数能做的事别用宏做;
- 标准库的
@time / @view / @threads从此可以"知其所以然"地用。