7.2 调用Python代码
7.2 调用Python代码
PyCall 让你在 Julia 会话里 import Python 库:类型自动映射、数组零拷贝传递。Python 生态里尚未有 Julia 对应物的库(某些深度学习框架、专用工具包),一行桥接直接用。
十分钟上手
] add PyCall using PyCall np = pyimport("numpy") a = np.random.randn(3, 3) # 拿到的是 Julia 可用的矩阵 np.linalg.eigvals(a) # 直接调 numpy 的特征值
数据双向流动不需要手动转换:
v = rand(5) np.mean(v) # Julia 数组直接传给 numpy pycall(np.mean, Float64, v) # 需要确保返回类型时用 pycall
PyCall 类型映射速查
| Python | Julia |
|---|---|
int / float |
Int / Float64 |
str |
String |
list / tuple |
Vector{Any} |
numpy.ndarray |
Array(零拷贝) |
dict |
PyDict |
实战场景:用 Python 库补生态缺口
假设训练可视化工具只有 Python 版,或需要一个只有 Python 绑定的模型服务,在 Julia 主流程里局部嵌入:
pd = pyimport("pandas") # Julia 字典 → Python DataFrame d = PyDict("a" => [1, 2, 3], "b" => [4.0, 5.0, 6.0]) pydf = pd.DataFrame(d) pydf.describe() # 直接用 pandas 的统计功能
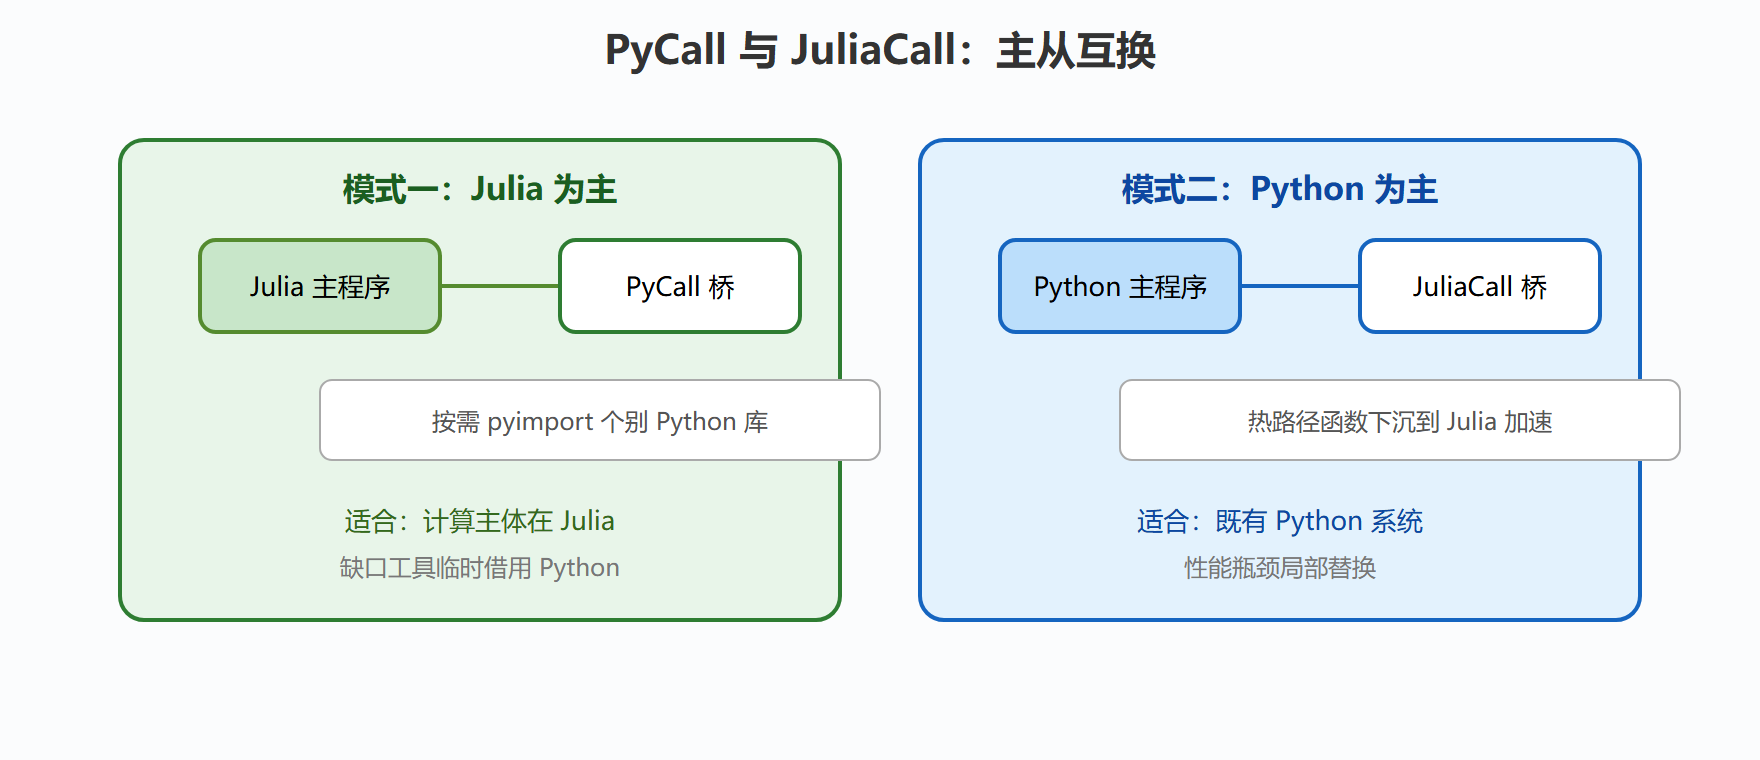
更深的混编用 JuliaCall 反向桥——在 Python 里 import julia,适合"主系统是 Python、个别热路径用 Julia 加速"的团队。
谁当主的两种模式
⚠️ 常见坑:PyCall 默认使用它自己安装的 Python 环境,系统里装的包可能"看不见"。首次配置时用环境变量指定目标 Python 的可执行文件,装齐依赖再启动 Julia。
💡 关键直觉:跨语言调用的成本不在调用本身,而在"数据搬家次数"。把一百万次小调用改成一次批量数组传递,混编程序常常快一个数量级。
完整案例:Julia 主流程 + Python 可视化组件
背景:一个 Julia 仿真程序,中间需要调用只有 Python 版实现的绘图服务(推送给内部平台的接口库),输出图件再回到 Julia 继续分析。这种"主从式"混编的完整骨架:
using PyCall # 启动阶段:一次性导入并初始化 const pyplt = pyimport("matplotlib.pyplot") pyplt.switch_backend("Agg") # 无显示环境(服务器)出图必选 function save_curve(xs, ys, path) fig, ax = pyplt.subplots() # 每张图新建画布,避免叠加 ax.plot(xs, ys, label="loss") ax.set_xlabel("epoch"); ax.set_ylabel("value") ax.legend() fig.savefig(path, dpi=150) pyplt.close(fig) # 显式关闭,长跑任务防句柄泄漏 return path end save_curve(1:100, exp.(-(1:100) ./ 30), "decay.png")
解读这段代码的工程细节:后端切到 Agg 因为服务器没有图形界面;每张图显式 close,跑几千次的批任务不会把内存耗在画布对象上;const 固定导入对象避免每次调用重新解析。变式:若 Python 组件返回的是复杂对象(如训练好的模型),用 pickle 存到文件、Julia 侧只传路径,比对象级互传稳得多——跨语言边界上,"传文件"常常优于"传对象"。
排错与性能边界
PyCall 的高频故障按频率排。第一位:Python 环境不对——pyimport 报模块不存在,实际是 PyCall 用了自己管理的 Python;在首次安装前设好环境变量指向目标解释器,或用 PyCall.py 查看当前指向。第二位:conda 依赖缺失——初始化时自动装了最小 conda,常用的库一个都没有,进入该环境装齐再重启 Julia。第三位:数组形状语义差——numpy 与 Julia 都是列主序互通,但 Python 生态的"样本 × 特征"惯例与 Julia 包相反,跨语言传矩阵前先 size 一下确认维度含义。性能边界要心里有数:单次跨语言调用有微秒级固定开销,热循环里逐元素调 Python 函数会把 Julia 的速度优势全部吐回去;原则是"跨语言按批、按文件、按会话"交流,循环体永远留在单语言内。理解这条边界后,混编架构的取舍就简单了——缺口用桥补,性能不跨桥。
概念辨析:PyCall、PythonCall 与选择
生态里现在有两代桥:老牌的 PyCall 与新生的 PythonCall。差异要点:PyCall 出现早、大量老项目依赖它,但它独占一个 Python 进程、与其他 PyCall 生态绑定深;PythonCall 设计更现代,支持与 Python 侧的 juliacall 双向协作更顺畅、对 conda 的处理更灵活、允许同一会话里更细的控制。选择原则很简单:跟随你要用的 Julia 包——它依赖哪个你就用哪个;自己新开项目则优先 PythonCall。两者 API 风格接近(pyimport 都存在),从一个迁到另一个的学习成本很低。辨析这一段的意义在于读别人的项目时不被两个相似的名字绕晕:看到依赖列表里的桥,就知道该按哪套文档查用法。
本节要点回顾
pyimport即得,Python 对象可像 Julia 对象一样用点号访问;- 类型自动映射,numpy 数组与 Julia 数组零拷贝互通;
- 主从两种模式:Julia 主用 PyCall,Python 主用 JuliaCall;
- 批量化跨语言调用,减少往返次数是混编性能第一定律。