9.2 数据科学案例:气象数据分析
9.2 数据科学案例:气象数据分析
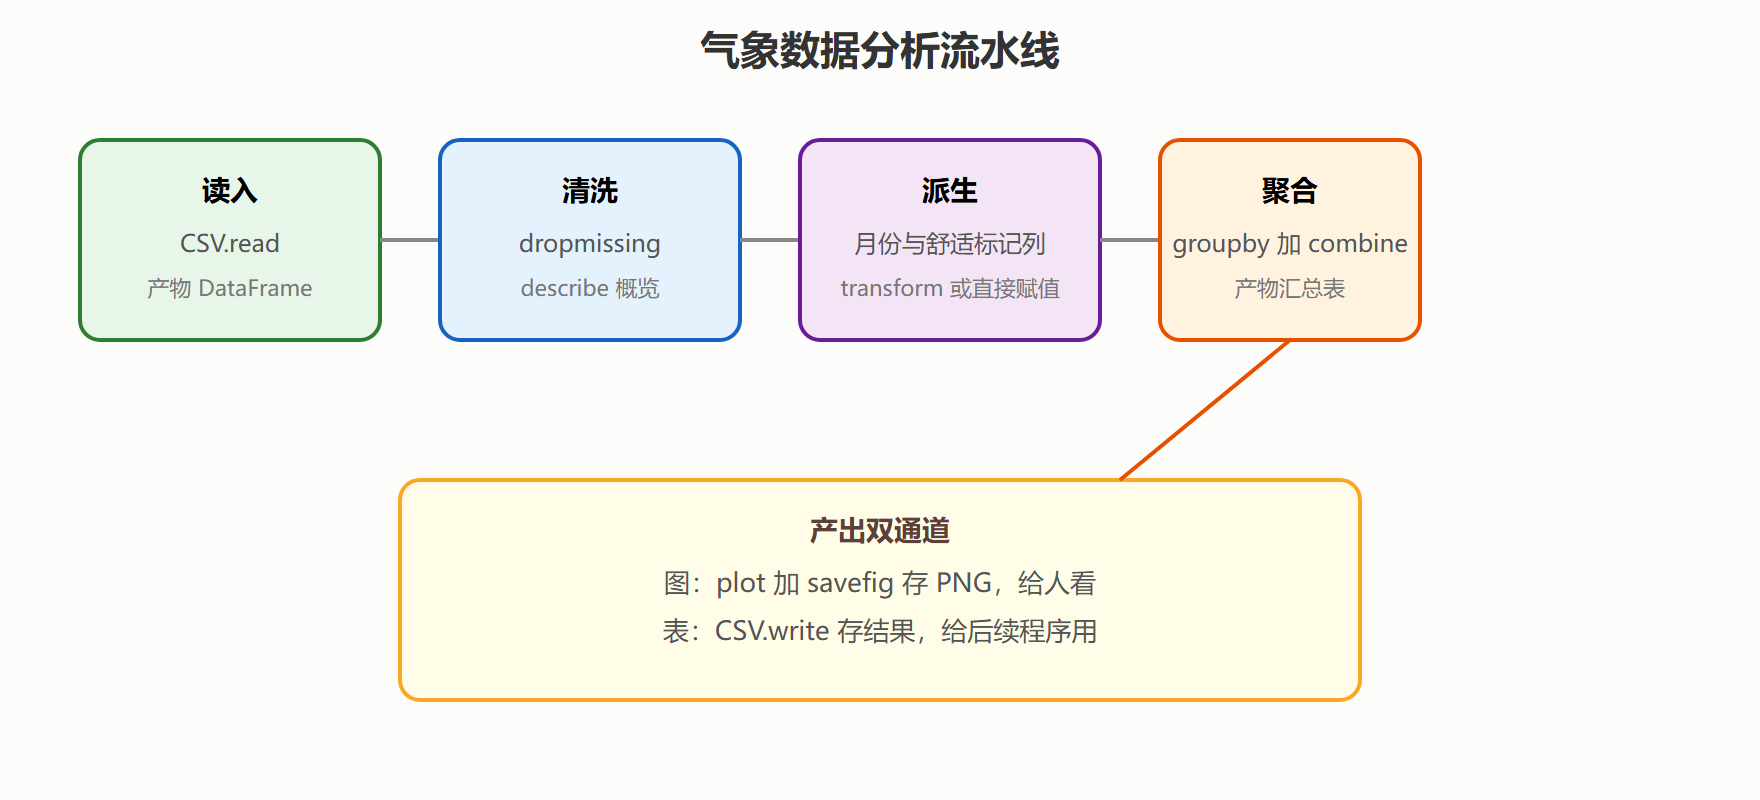
从 CSV 原始数据到分组统计与可视化报告,走一遍数据科学的完整流水线:读入 → 清洗 → 派生指标 → 分组聚合 → 出图存档。涉及第 4 章 IO 与第 6 章 DataFrames。
数据准备
模拟一份城市日均气温表(实际项目里换成你的 CSV):
using CSV, DataFrames, Statistics, Plots, Dates df = DataFrame( date = Date(2024,1,1) .+ Day.(0:364), city = rand(["北京", "上海", "广州"], 365), temp = 15 .+ 10 .* sin.(2π .* (0:364) ./ 365) .+ randn(365) .* 2, ) CSV.write("weather.csv", df) # 演示用:先落盘再读回,模拟真实流程 raw = CSV.read("weather.csv", DataFrame)
清洗与派生
dropmissing(raw) raw.month = month.(raw.date) # 派生列:月份 raw.comfort = raw.temp .> 15 # 派生列:舒适日标记 describe(raw) # 一眼看分布
分组聚合:回答三个业务问题
# 问题一:每城市年均温 combine(groupby(raw, :city), :temp => mean => :年均温) # 问题二:各城市月均温(透视形态) monthly = combine(groupby(raw, [:city, :month]), :temp => mean => :月均温) # 问题三:每城市舒适天数 combine(groupby(raw, :city), :comfort => sum => :舒适天数)
可视化与存档
bj = filter(:city => ==("北京"), monthly) p = plot(bj.month, bj.月均温, marker = :circle, title = "北京月均温", xlabel = "月", ylabel = "摄氏度") savefig(p, "beijing_monthly.png") CSV.write("monthly_summary.csv", monthly) # 结果表也存档
数据流水线各环节与产物
⚠️ 常见坑:
groupby之后原表顺序会重排,直接拿聚合结果与原表按行对齐会错位。需要回贴时用leftjoin按键合并,不要按位置。
💡 关键直觉:派生列在聚合前做。先把"舒适标记"算好再
sum,比在聚合表达式里写复杂逻辑更可读也更可测试。
结果解读与口径陷阱
聚合表出来后先别急着下结论,三个口径问题常让分析翻车。其一,样本不均:演示数据里城市是随机指派的,三城样本量几乎相等,聚合均值可比;真实数据往往北京 300 天、广州 65 天,直接比"年均温"就是拿不等精度的估计硬碰,应同时报告样本量列 nrow(groupby(...))。其二,缺失的时序性:按月聚合抹掉了月内波动,若要比较极端天气,得另算月内标准差列。其三,辛普森悖论的警觉:全表看广州舒适天数最多、分月看却可能输给北京(各月样本构成不同),交叉结论冲突时先查构成再解释。把这三问过一遍,同一张表才能从"数字"升格为"证据":
# 给聚合表补上样本量与离散度,结论更完整 combine(groupby(raw, [:city, :month]), :temp => mean => :月均温, :temp => std => :月波动, nrow => :样本数)
变式:把流水线包成可复用函数
一次性的分析脚本用完即弃,值得沉淀的分析要包成函数。把全流程收进一个带关键字参数的入口,输出统一存进带时间戳的目录:
function analyze(path; outdir = "results_" * Dates.format(now(), "yyyymmdd_HHMM")) mkpath(outdir) raw = CSV.read(path, DataFrame) dropmissing!(raw) raw.month = month.(raw.date) monthly = combine(groupby(raw, [:city, :month]), :temp => mean => :月均温) CSV.write(joinpath(outdir, "monthly.csv"), monthly) # 表存档 for city in unique(raw.city) # 每城一张图 sub = filter(:city => ==(city), monthly) savefig(plot(sub.month, sub.月均温, title = city), joinpath(outdir, city * ".png")) end monthly end analyze("weather.csv")
这个函数把 4.2 的目录操作、4.3 的存档纪律、6.2 的聚合三块知识装配成一个可交接的组件:换一份新数据,一行调用产出全套结果,且产物目录自带时间戳可追溯。第 3 章模块化的思想到了案例层就是这个形态——分析不再是"我跑过的一些代码",而是"一个有名字、有输入输出约定的工具"。
本节要点回顾
- CSV 进、DataFrames 洗、groupby 聚合、双通道出(图 + 表)是通用骨架;
- 派生列前置,聚合表达式保持简短;
- describe 先看、dropmissing 再算,顺序错了统计量会被污染;
- 结果表同样存档,分析要可复现;
- 口径三问(样本量、时序粒度、构成偏差)把数字变成证据;
- 函数化 + 时间戳目录,分析才能交接与复跑。
这五条里最容易被忽略的是"结果表存档":图好看但数字没归档的分析,两周后就变成"当时好像看到过某个趋势"的模糊记忆。表与图同产出、同目录、同命名,是分析可追溯的最低配置。
最后提醒一个演示数据与真实数据的落差:本例的气温由正弦加噪声生成,干净得过分;真实气象数据有仪器故障的连续缺失段、单位混用的历史遗留、站点改名等坑。流水线骨架不变,但清洗步骤会从三行膨胀到三十行——这也是为什么 9.2 把"清洗"单独列为一个环节,而不是假装它是读取的一行附注。