1.1 从一次点击开始认识数据包
1.1 从一次点击开始认识数据包
本节摘要:数据包是网络传输的基本单位,结构上就是"首部 + 载荷"——信封加信纸。本节用一个浏览器点击的完整案例,讲清分组交换、封装套娃、存储转发三个核心概念,并给出第一段抓包演示,为整册的"环球旅行"定下观察方法。
承接导读里的承诺,旅程从这里发车。本节不堆概念,只回答三个问题:货物长什么样、货物怎么走、货走丢了算谁的。它们分别对应分组交换、存储转发与尽最大努力交付,是后面所有章节的地基。
一、货物长什么样:首部加载荷
设想你在浏览器输入一个网址并回车。浏览器生成的其实是一段纯文本请求,几十到几百字节。这段文本要跨越半个地球到达服务器,靠的不是一次性的"长列车",而是被切成一个个独立的小包裹——数据包。每个包裹只做两件事:前面挂一块写满投递信息的首部(信封),后面跟着真正的数据(信纸)。
一个简化的数据包结构(自上而下是封装顺序): [ 以太网首部 14 字节 ] [ IP 首部 20 字节 ] [ TCP 首部 20 字节 ] [ HTTP 载荷 ... ] 目的 MAC 地址 目的 IP 地址 目的端口 80 GET 请求文本 源 MAC 地址 源 IP 地址 源端口 52738 类型 0x0800 生存时间 64 序号 校验和 整列车厢对交换机可见的只有最外层;每被一层设备处理,就拆掉一层信封。
关键直觉是"套娃":应用数据交给传输层,包上 TCP 首部;整个结果交给网络层,再包上 IP 首部;最后交给链路层,套上以太网帧头帧尾。接收方按相反顺序逐层拆封。每层只读属于自己的那张信封,这让五层协议可以各自独立演化。
用一次真实的抓包验证。在任何一台装了抓包工具的机器上访问一个网站,过滤 TCP 端口 80 的包:
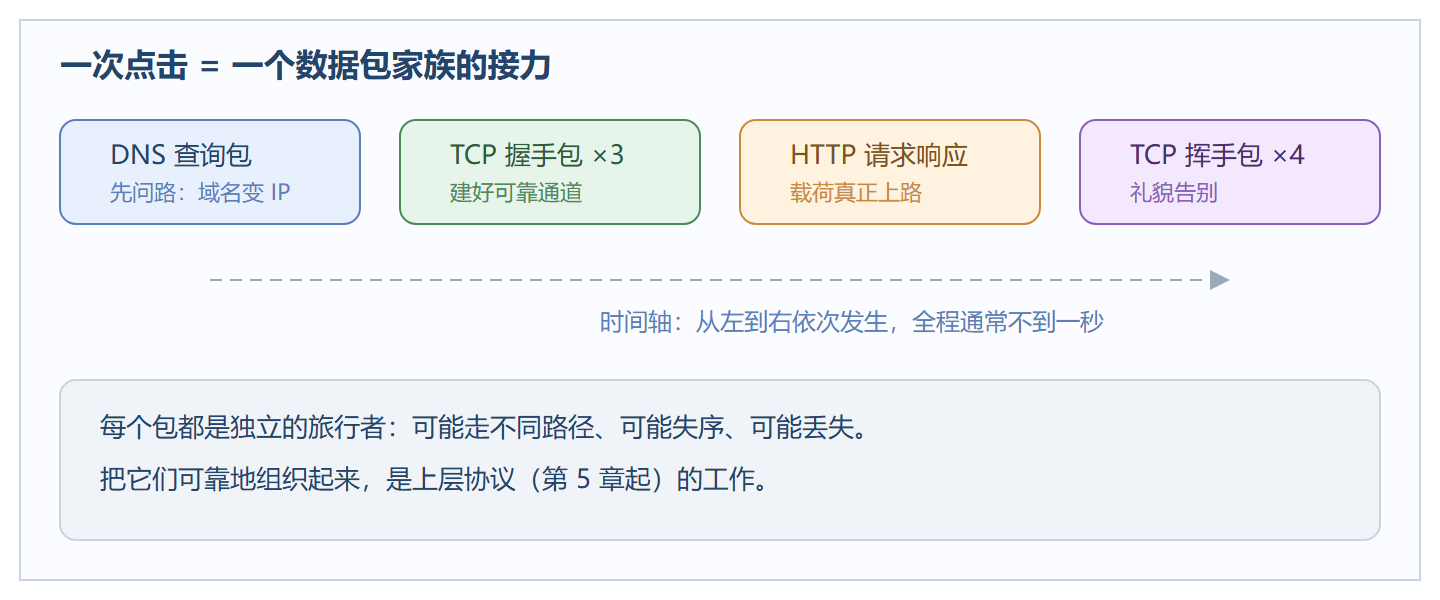
# 抓包过滤 tcp.port == 80,截取一次请求的输出(已简化) No. Time Source Destination Protocol Length Info 12 0.000 192.168.1.23 93.184.216.34 TCP 74 52738 → 80 [SYN] 13 0.028 93.184.216.34 192.168.1.23 TCP 74 80 → 52738 [SYN, ACK] 14 0.029 192.168.1.23 93.184.216.34 TCP 66 52738 → 80 [ACK] 15 0.031 192.168.1.23 93.184.216.34 HTTP 431 GET / HTTP/1.1 解读:前三行是 TCP 三次握手(第 5 章主角),第四行才是 HTTP 请求。 Length 74 的构成:14 字节以太网头 + 20 字节 IP 头 + 24 字节 TCP 头(带选项)+ 无载荷。 一个"网页请求"在网络上从来不是一次对话,而是几十上百个这样的包在协作。
图:一次点击产生的数据包群
二、货物怎么走:分组交换与存储转发
早期电话网用"电路交换":通话前先占用一条端到端的物理线路,占着说话,挂机释放。优点是通话中独享带宽,缺点是线路利用率极低——你沉默的每一秒,线路都在空转。
互联网选择了另一条路:分组交换。数据被切包后,每个包独立路由,路由设备"存储转发"——收完整个包、校验、查表、再从合适端口发出。不同用户的数据包在同一线路上交错复用,线路利用率高得多。代价是每个包要排队,排队的人多了就有时延,队列满了就被丢弃。
两种交换方式的对比:
| 维度 | 电路交换 | 分组交换 |
|---|---|---|
| 建立连接 | 通话前必须先建立独占链路 | 无需预建,随时可发 |
| 资源利用 | 独占,空闲也占着 | 统计复用,利用率高 |
| 时延特征 | 建立后稳定低时延 | 有排队时延,抖动明显 |
| 抗毁性 | 中断即全断 | 可绕道,个别节点失效仍可通 |
| 典型应用 | 传统电话 | 互联网一切流量 |
三、货丢了算谁的:尽最大努力交付
这是初学者最容易忽视、也最重要的一个事实:IP 网络本身不保证送达。路由器队列满了就丢包,不做通知;包可能失序、重复、损坏。网络层只承诺"尽最大努力"。
那网页为什么看起来从不出错?因为可靠性是上层补的:TCP 用序号、确认与重传把不可靠的管道修成可靠的服务。这个"底层尽量简、上层按需补"的分工是互联网能长到今天这个规模的核心设计——它把复杂性从网络核心(几十万台路由器)挪到了网络边缘(你的电脑和服务器),升级一个 TCP 不需要动任何路由器。
⚠️ 常见坑:把"能上网"理解为"网络保证送达"。调试时看到偶发超时先别怀疑代码,抓包看是不是丢包重传,那是正常现象,只是超出你的预期阈值。
常见疑问
数据包、帧、报文、段是一回事吗? 不是,它们是同一货物在不同层的名字:应用层消息经传输层处理后叫段,装进 IP 后叫报文,装进以太网后叫帧,到物理层就是比特流。口语里混称"包",但读文档要敏感于说话者站在哪一层——路由器文档里的"包"指 IP 报文,网卡驱动里的"帧"指链路层信封,搞混会让排错方向跑偏。
为什么不一次发一个超大包? 包越大,单个包出错时重传浪费越大,中间设备缓冲也越大;包太小则首部开销占比过高。1500 字节左右是以太网时代定下的工程折中,沿用四十年(第 4 章会看到它带来的分片麻烦)。
手机流量也是数据包吗? 是。蜂窝接入只是换了物理层介质(第 2 章),你手机发出的每个 TCP 段同样走完整的五层封装,只是最底两层的实现从网线换成了无线电波。
抓包工具会不会看到别人的包? 在交换式有线网络里基本不会(交换机精确转发,3.3 节);在开放 Wi-Fi 里广播帧与未加密流量天然可截获——这也是第 7 章反复强调"咖啡店网络不可信"的原因。工具无善恶,介质定边界。
本节要点回顾
- 数据包结构:首部 + 载荷,五层封装像套娃,每层设备只读自己的信封
- 分组交换:切包独立路由、统计复用线路,换来了高利用率与抗毁性
- 存储转发:每个中间设备都要"收完—查表—再发",这是时延的重要来源
- 尽最大努力交付:IP 不保证不丢、不重、不乱,可靠性由 TCP 事后补偿
- 观察方法:抓包工具是本旅程的显微镜,后面各站会反复使用
- 复杂度外移:核心保持简单、智能放在边缘,是互联网规模化的根本设计
下一节把镜头拉远,看这条流水线的整体布局——分层思想与协议栈。