5.3 调度器与线程律令
5.3 调度器与线程律令
本节摘要:调度器决定协程在哪个线程池上恢复执行。Dispatchers.Main、IO、Default、Unconfined 各有分工,用错线程的事故形态是 ANR、吞吐骤降或主线程检查崩溃。本节讲四大调度器的边界、withContext 的切换与自动恢复、安卓主线程律令的报错形态、批量任务的并行度控制,以及"调度器该出现在哪一层"的架构决策。
一行代码放错线程的三种死法
安卓的线程律令只有一条主句:UI 只能在主线程碰,重活不能在主线程干。违反前半句与违反后半句,死法不同。
// 死法一 NetworkOnMainThreadException lifecycleScope.launch { // 默认主线程 val resp = api.fetchOrdersSync() // 同步网络请求跑在主线程 } // 死法二 ANR lifecycleScope.launch { val bitmap = decodeHugeBitmap(bytes) // 主线程解码 4K 图 超时弹窗 } // 死法三 CalledFromWrongThreadException withContext(Dispatchers.IO) { binding.tvTitle.text = "done" // IO 线程碰 UI 崩 }
第一种是即抛异常,最好排查;第二种是 ANR 弹窗加后台杀进程,用户直接流失;第三种发生在"绕过协程调度直接碰 UI"的场合——比如在 IO 线程的回调里改界面。三种事故的共同根源:协程的"当前线程"是一个需要被管理的资源属性,而不是默认正确的东西。调度器就是这个属性的管家。
四大调度器的分工
Dispatchers.Main // 安卓主线程 UI 操作 与生命周期交互 Dispatchers.IO // IO 线程池 网络磁盘数据库 阻塞型任务的家 Dispatchers.Default // CPU 线程池 排序解析加解密计算核心数 Dispatchers.Unconfined // 不固定线程 谁恢复谁执行 特殊场景专用
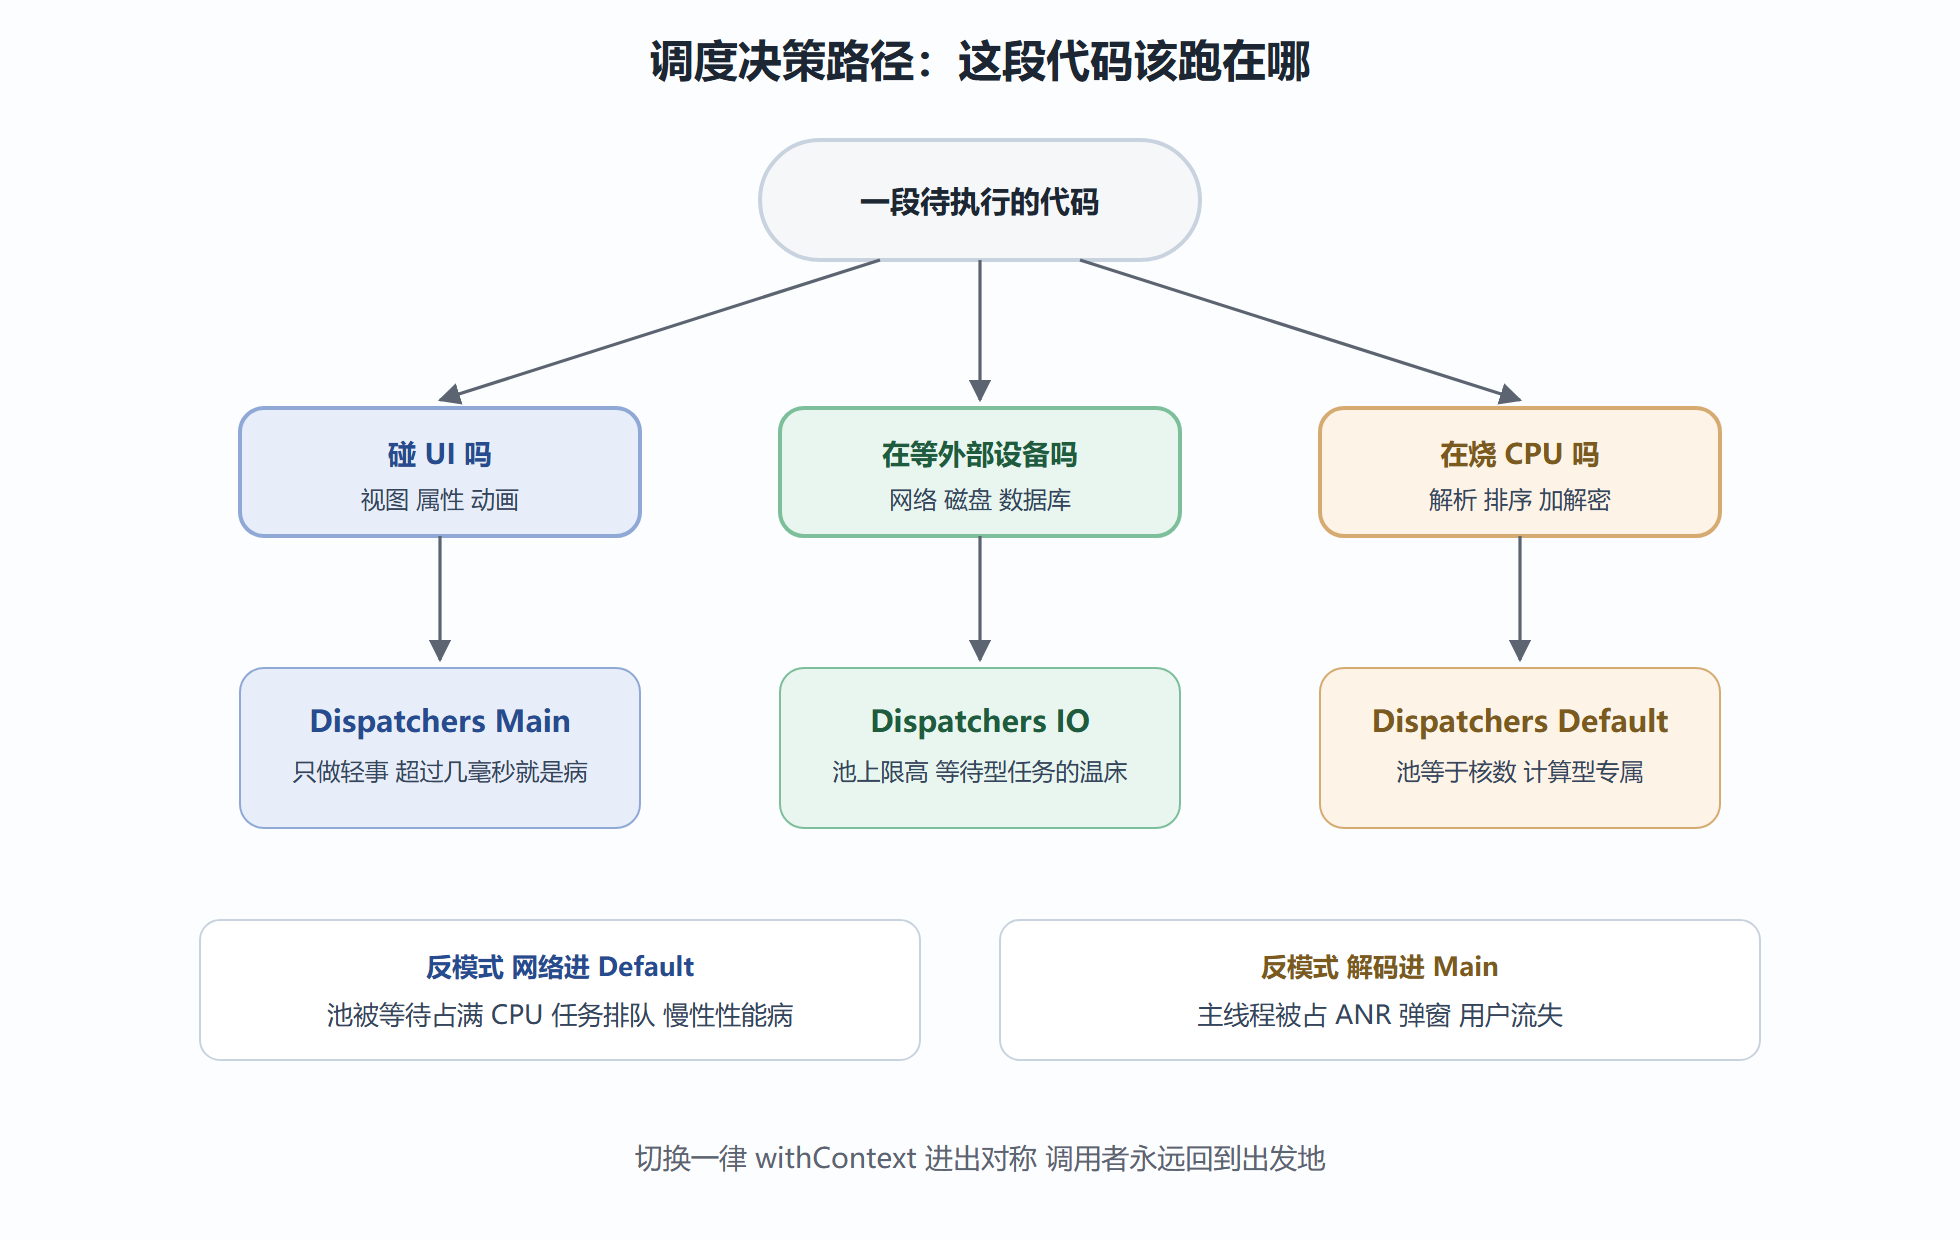
分工的底层逻辑是线程池的两种负载模型。IO 池按"等待型"设计:线程大部分时间在等网卡与磁盘,CPU 空转,所以池子可以远大于核心数(kotlinx 的 IO 池默认上限 64 线程,可调),用线程数换并发连接数。Default 池按"计算型"设计:线程满负荷烧 CPU,池子再大只会增加上下文切换开销,所以它精确等于 CPU 核心数。把网络请求丢进 Default,池子被占满后 CPU 任务排队;把重计算丢进 IO,64 个线程互抢核,上下文切换开销反而拖慢——放错池子不是崩溃,是慢性性能病。
Main 的特殊性在于它绑定安卓主线程的 Looper,恢复到 Main 等于向主线程消息队列投递一个任务。Unconfined 表示"不固定在恢复线程",它只在"挂起点前后线程无所谓"的场景有用(例如单元测试或某些计算中切换),业务代码几乎不应出现——它让"当前线程"重新变得不可推理,违背调度器的存在意义。
withContext:切换与自动归还
withContext 是线程切换的唯一正规姿势:
suspend fun loadAvatar(url: String): Bitmap = withContext(Dispatchers.IO) { // 切到 IO http.get(url).bytes().decodeBitmap() } // 恢复回原线程 自动的 lifecycleScope.launch { // 主线程 val avatar = loadAvatar(url) // 内部在 IO 干活 binding.ivAvatar.setImageBitmap(avatar) // 回到主线程 放心碰 UI }
进入 withContext 切到目标调度器,块结束时自动恢复到调用者的调度器——这个"自动归还"是它区别于裸线程池提交的关键:调用者不需要知道被调函数内部切过线程,它拿回控制权时永远还在自己出发的地方。于是安卓开发的最重要纪律可以写得很短:
主线程发起、withContext 干活、自动回主线程碰 UI。全程不需要 Handler,不需要 post,不需要记"现在在哪个线程"。
对比 Java 时代的同等代码:new Thread 干活、runOnUiThread 归位、两处匿名内部类、中间状态靠 Handler 消息传递——线程上下文靠人脑维护,这正是 5.1 节回调事故的温床之一。
调度决策图
下图把"一段代码该跑在哪"的判断流程画成决策路径,四条终点对应四个调度器。
调度器出现在哪一层:一个架构决策
调度器写在哪一层,是个真实的架构问题。三种写法在工程里都存在:
// 写法一 UI 层显式切换 仓库不管线程 class OrderRepo(private val api: OrderApi) { suspend fun fetch(id: String) = api.getOrder(id) // 无调度器 } class VM : ViewModel() { fun load() = viewModelScope.launch { val order = withContext(Dispatchers.IO) { repo.fetch("A1") } _state.value = order } } // 写法二 仓库内部自带调度器 UI 层无感 class OrderRepo(private val api: OrderApi) { suspend fun fetch(id: String) = withContext(Dispatchers.IO) { api.getOrder(id) } }
写法一线程责任在调用方,每个调用点都要记得切;写法二仓库自我声明"我是 IO 型的",调用方零负担。本册立场:数据层内部自带调度器(写法二),UI 层默认 Main。理由是可组合性——仓库函数可能被 ViewModel、被别的仓库、被 WorkManager 调用,把线程知识内聚在实现处,调用方才不需要层层传递调度器。配合 withContext 的自动归还,两层约定互不干扰:仓库说"我内部去 IO",调用方听到的仍然是"你回来时还在 Main"。
测试是另一条佐证:仓库自带 Dispatchers.IO 时,测试注入一个单线程 TestDispatcher(通过构造器传入调度器参数),并发逻辑变成确定性顺序执行。把调度器当依赖注入是可测试协程代码的标准姿势(第 8 章给出完整测试配置)。
并行度控制:limitedParallelism
批量任务想限制同时跑的数量(比如同时下载不超过 4 个,照顾流量与服务器),IO 池的视图可以限流:
val downloadDispatcher = Dispatchers.IO.limitedParallelism(4) suspend fun downloadAll(urls: List<String>) = coroutineScope { urls.map { url -> async(downloadDispatcher) { downloader.fetch(url) } }.awaitAll() }
一百个 async 也只有四个真正并发,其余在调度器排队。这个 API 把 Java 时代"手写信号量或固定线程池"的样板压缩成一个参数,而且作用域取消时排队任务一并取消——限流与结构化并发不冲突。
主线程的时间预算
调度器视角下,ANR 的定义变得精确:主线程消息队列里一个任务超过约五秒(广播十秒)没处理完,系统弹 ANR。所以 Main 上的预算以毫秒计:一次列表 diff、一次视图属性批量更新可以;一次 JSON 解析、一次 Bitmap 解码不行。经验法则:Main 上单段代码超过 10 毫秒就该审视,超过 50 毫秒必须挪走。StrictMode 的 ThreadPolicy 可以在开发期自动揪出主线程上的网络与磁盘(第 8 章配置),它是调度纪律的自动督察。
线程命名的排查习惯与调度器实测
调度纪律的最后一公里是可观测性。默认线程池的名字是毫无信息量的 DefaultDispatcher-worker-3,出问题时无法从线程名反推业务。两个习惯立刻改善:给关键协程加 CoroutineName(堆栈与日志里可见);自定义调度器时用线程工厂命名(Dispatchers.IO.limitedParallelism(2) 之外,自定义 Executor 转 dispatch 时传命名工厂)。日志框架里输出线程名的前提下,"sync-cart"比"worker-3"的排查价值差一个量级。
感知层面的直觉也值得校准。一个常见疑问:withContext 切线程有没有开销?有——一次入队加恢复,微秒级;对单次网络请求(毫秒级)完全无感,对每帧执行的热路径(onDraw 里)则可能是性能问题。判断口径:切换成本与块内工作的比值低于百分之一时不用犹豫;反过来,热路径里"每个元素一次 withContext"是典型反模式,应该把整批工作包进一次切换。另一个直觉:Main 调度器的队列深度就是界面响应度的直接指标——主线程消息排队越深,点击延迟越明显;StrictMode 与性能工具能抓到队列里的大户,但"哪些任务根本不该排队"要靠设计期的调度决策把住。
常见问题
问:withContext(Dispatchers.IO) 里又调了一个内部自带 withContext(Dispatchers.IO) 的函数,会重复切换吗?
语义上是"切换到同一调度器",库的实现会做短路优化——已在目标调度器上时不发生实际切换,开销退化为一次上下文对象检查。所以"仓库自带调度器、上层又包一层"的写法性能无害,但语义上冗余,且会让调用方误以为线程责任在上层——按本节的架构决策(数据层自带调度器),上层包夹应该删掉。真正要避免的是无意义的跨池切换(IO 里包 Default 又包 IO),那不只是开销,是线程责任表述混乱。
问:Dispatchers.Main 在单元测试里不可用怎么办?
Main 调度器依赖安卓主线程 Looper,纯 JVM 测试里访问会抛异常。解法是 Dispatchers.setMain(testDispatcher) 把 Main 替换为测试调度器(kotlinx-coroutines-test 提供),测试收尾 resetMain。这就是第 5.2 节"调度器当依赖注入"在测试侧的兑现——ViewModel 接收调度器参数、测试注入 TestDispatcher、Main 替身只用于不可注入的场合。第 8 章的测试小节给出了完整接线。
问:挂起函数里用 Thread.sleep 调试"偶尔也行",为什么要绝对禁止?
"偶尔也行"正是它危险的地方——测试与小流量下无感,线上并发上来后线程池被占满,所有依赖该池的任务排队雪崩。sleep 期间协程的状态是"运行中"而不是"挂起",作用域取消对它无效(没有挂起点),取消语义同时失灵。调试想延时用 delay;等待外部条件用 withTimeout 轮询或 await;把锁等待改为 withLock(它的挂起版本)。把"阻塞调用清单"贴在团队文档里(sleep、同步 IO、锁、忙等循环),评审时按图索骥。
本节要点回顾
- 两种线程池模型:IO 池大而等待,Default 池小而计算,放错池是慢性性能病不是崩溃;
- 三种死法:主线程网络即抛异常、主线程重活 ANR、非主线程碰 UI 即崩——根源是"当前线程"未被管理;
- withContext 进出对称:切过去干活、自动回出发地,Handler 与 post 全面退休;
- 架构决策:数据层自带 IO 调度器,UI 层默认 Main,调度器可注入以支撑测试;
- limitedParallelism 限流:并发上限一个参数,且与结构化取消兼容;
- Main 的毫秒预算:超过 50 毫秒的活必须挪走,StrictMode 当自动督察。
线程归属清楚后,剩下的就是收场:页面销毁时任务怎么停、超时怎么断、异常沿树传到哪。下一节讲协程的退出机制——取消,与它配套的异常传播规则。