1.2 解剖一份Deployment声明:YAML逐行导读
1.2 解剖一份 Deployment 声明:YAML 逐行导读
Deployment 是 Kubernetes 中描述"一组无状态副本应用"的工作负载对象:你声明副本数、Pod 模板与选择器,它负责让集群中实际存在的副本与声明始终一致。本节把 orders-api 的第一版 Deployment YAML 逐行拆开,讲清 metadata、spec、selector、template 四者如何互相咬合。
上一节解决了"凭什么信声明式",这一节解决"声明怎么写"。它是全教程的技术地基:后面六章里加探针、加资源、挂配置、滚动升级,改的都是这一份 YAML 的不同段落。先把骨架看熟,后续每一章都只是往骨架上添肉。
一份声明的长相
先看 orders-api 的第一版完整声明。建议对照代码通读一遍,再往下看逐段解读:
apiVersion: apps/v1 # 资源所属的 API 组与版本:Deployment 归 apps 组 kind: Deployment # 资源类型:我要创建的是一份部署声明 metadata: name: orders-api # 对象名,在同一命名空间内唯一 labels: app: orders-api # 给声明自己贴标签,便于检索 namespace: production # 归属的命名空间,逻辑隔离用 spec: # 期望状态:以下是"我要的结果" replicas: 3 # 副本数:任何时刻应有 3 个 Pod 在运行 selector: # 选择器:圈定这份 Deployment 管辖的范围 matchLabels: app: orders-api # 只管理带 app=orders-api 标签的 Pod template: # Pod 模板:按此规格生产每一个副本 metadata: labels: app: orders-api # 模板打出的标签,必须被 selector 命中 spec: containers: - name: orders-api # 容器名,Pod 内唯一 image: orders-api:1.4.2 # 镜像与版本,永远写明确版本号 ports: - containerPort: 8080 # 容器监听端口,仅为声明性信息 env: - name: APP_MODE # 环境变量,配置的雏形 value: "production"
整份声明分三大段,各司其职:
| 段落 | 回答的问题 | 写错时的典型症状 |
|---|---|---|
| apiVersion 与 kind | 我要创建什么类型的对象 | 版本写错直接被 API Server 拒收 |
| metadata | 它叫什么、贴什么标签、归哪个空间 | 重名冲突、检索不到 |
| spec | 期望几个副本、按什么模板生产 | selector 与模板标签不匹配时创建被拒 |
图 1-3:Deployment YAML 三段式结构与咬合关系
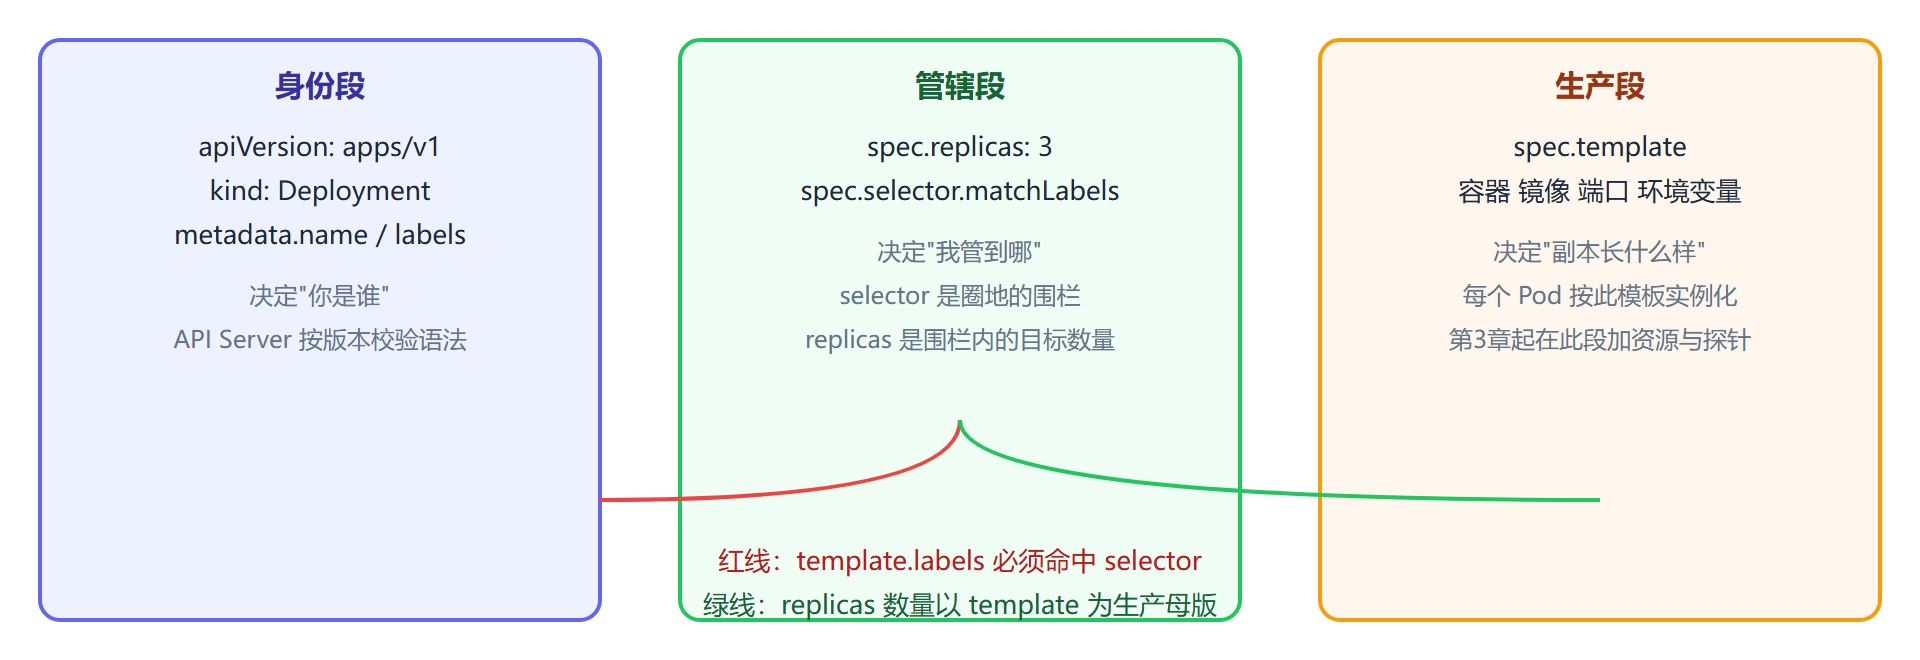
selector 与 template:一对不能出错的搭档
整份声明里最精妙也最容易被新手写坏的,是 selector 与 template 里 labels 的呼应。规则只有一条:模板打出的标签,必须落在选择器的命中范围内。Kubernetes 在受理时就做这个校验,不匹配直接拒绝:
# 故意把 template.labels 写成 app: orders-api-v2 后提交 kubectl apply -f orders-deploy.yaml # The Deployment "orders-api" is invalid: # spec.template.metadata.labels: Invalid value: map[string]string{"app":"orders-api-v2"}: # `selector` does not match template `labels`
为什么要设计得这么严格?因为 Deployment 靠标签动态圈定管辖范围,而不是记住 Pod 的名字。想想这个场景:某个 Pod 被运维手工创建,恰好带着 app=orders-api 标签——它会被 Deployment 视作自己人并纳入副本计数;哪天你把它删了,Deployment 发现副本数少于 3,又会按模板补一个新的。归属关系是动态计算的,标签就是身份证。
这也解释了一个常见疑问:为什么改副本数要改 Deployment,而不是直接删 Pod?答案是你可以删——删掉一个 Pod,控制器发现实际数量变成 2,与期望的 3 有差值,立刻按模板补产。声明没变,现状被推回声明。这个"差值驱动"的机制叫调和循环,第4章会完整拆解。
首次提交与观察
声明写好,提交并观察三样东西:Deployment 自身、它生产的 Pod、事件流:
# 提交声明 kubectl apply -f orders-deploy.yaml # deployment.apps/orders-api created # 观察 Deployment:三个关键列 kubectl get deployment orders-api -n production # NAME READY UP-TO-DATE AVAILABLE AGE # orders-api 3/3 3 3 30s # 观察 Pod:READY 一列应为 1/1 kubectl get pods -n production -l app=orders-api -o wide # NAME READY STATUS RESTARTS AGE IP NODE # orders-api-6d9f7c8b5-2vxk7 1/1 Running 0 30s 10.244.1.5 node-a # orders-api-6d9f7c8b5-9mjq4 1/1 Running 0 30s 10.244.2.8 node-b # orders-api-6d9f7c8b5-x3p2q 1/1 Running 0 31s 10.244.3.3 node-c
输出里藏着两个伏笔:其一,Pod 名字的前缀 orders-api-6d9f7c8b5 中间那串是 ReplicaSet 的哈希——Deployment 并不直接生产 Pod,而是借道 ReplicaSet,细节留给第4章;其二,三个副本散落在三台节点上,这是调度器的手笔,第3章的主角。
案例:一次受控的扩容
背景:大促前压测显示峰值流量需要 5 个副本才能扛住,当前只有 3。
操作:把 YAML 中 replicas 从 3 改成 5,重新提交:
# 修改声明后重复提交:输出从 created 变为 configured,说明是修订而非新建 kubectl apply -f orders-deploy.yaml # deployment.apps/orders-api configured # 观察副本补齐过程 kubectl get pods -n production -l app=orders-api # NAME READY STATUS RESTARTS AGE # orders-api-6d9f7c8b5-2vxk7 1/1 Running 0 10m # orders-api-6d9f7c8b5-9mjq4 1/1 Running 0 10m # orders-api-6d9f7c8b5-x3p2q 1/1 Running 0 10m # orders-api-6d9f7c8b5-7tkf9 0/1 ContainerCreating 0 6s # orders-api-6d9f7c8b5-p1n8w 0/1 ContainerCreating 0 5s
结果:约二十秒后 READY 汇总变为 5/5。
解读:扩容的全过程你没有执行任何"起容器"的命令,只是改了一个数字。控制器发现期望 5、实际 3,差值 2,于是按模板生产 2 个 Pod。ContainerCreating 状态说明新 Pod 已被调度、正在拉镜像建容器。
变式:应急场景下可以用 kubectl scale 命令行直接改副本数,效果立竿见影;但要记得事后把数字回填进 YAML 文件,否则下次别人 apply 你的旧文件,副本数会被"纠正"回去。GitOps 流派(第7章)干脆禁止手工 scale,一切以仓库里的声明为准,就是为了让唯一真相源不被绕过。
本节要点回顾
- 三段结构:身份段声明"我是谁",管辖段声明"我管到哪、要几个",生产段声明"副本长什么样";
- selector 是围栏:Deployment 靠标签动态圈定管辖,template.labels 不命中 selector 会被直接拒收;
- 改数字即扩容:副本数是声明的一部分,改声明比执行命令更可靠;
- apply 的三种输出:created 新建、configured 修订、unchanged 无变化,分别对应声明的三种命运;
- Pod 名中的哈希:它泄露了 Deployment 与 ReplicaSet 的分层关系,第4章展开。
副本的最小载体是 Pod——下一节进入 Pod 内部:多容器如何共享网络、状态如何流转,为第3章的调度与探针做最后一块铺垫。