3.3 kubelet与容器运行时:节点上的执行者
3.3 kubelet 与容器运行时:节点上的执行者
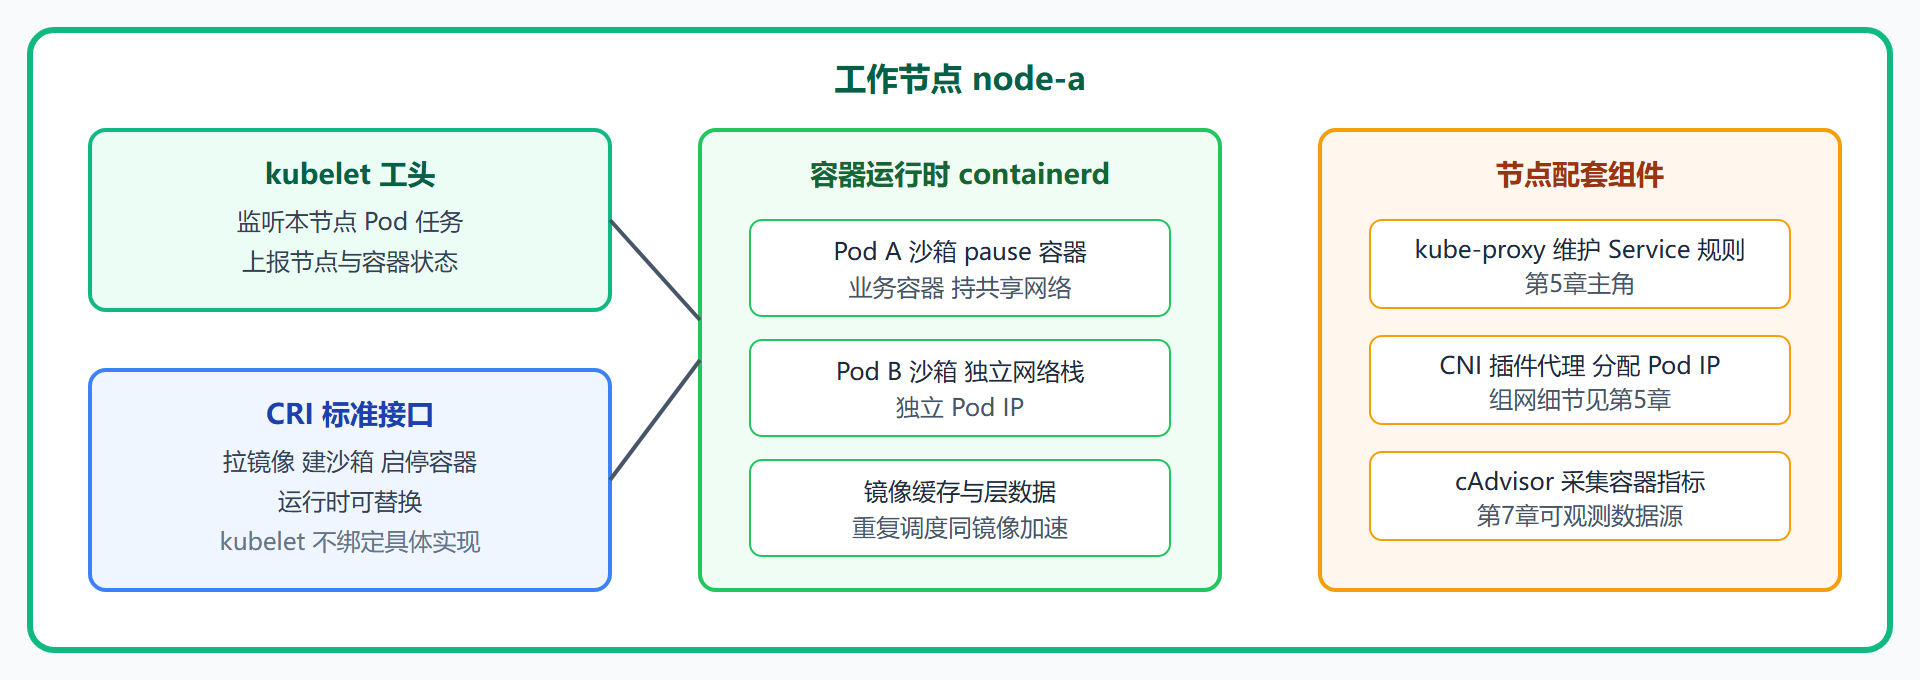
kubelet 是运行在每台工作节点上的代理:它监听分给本节点的 Pod,指挥容器运行时(containerd、CRI-O 等,经 CRI 标准接口交互)完成拉镜像、建沙箱、启容器,并把节点与 Pod 的状态持续上报给 API Server。声明在本节从"账本记录"变成"活着的进程"。
调度器只做了选择题,答案写进了账本;真正动手的是节点上的 kubelet。这一节走进工作节点内部,看这份声明如何被逐字兑现:谁认领任务、谁拉镜像、谁建网络沙箱、状态如何回写。理解这条执行链,ImagePullBackOff 之类的"卡半路"故障才有完整的定位思路。
节点上的工头
kubelet 的角色像一个工头:不自己做决定,但负责把图纸变成楼。它的三份日常:
- 盯任务:通过 Watch 监听 nodeName 等于本节点的 Pod 对象,新任务入账即感知;
- 管施工:按 Pod 声明指挥容器运行时造沙箱、拉镜像、启容器,并维持声明的终态(容器死了按策略重启);
- 报进度:节点资源余量、容器状态每几秒汇总上报,2.3 节看到的 Running、READY 数据都源自这里。
kubelet 与容器运行时之间隔着一层标准接口 CRI(容器运行时接口)。这层抽象让 Kubernetes 不绑定任何具体运行时——containerd 换 CRI-O、再换更新的实现,kubelet 一行不改。节点上装的是哪个运行时,一条命令可见:
# 节点摘要里的运行时信息 kubectl get nodes -o wide # NAME STATUS ROLES ... CONTAINER-RUNTIME # node-a Ready <none> ... containerd://1.7.13 # node-b Ready <none> ... containerd://1.7.13
图 3-2:工作节点内部解剖
从镜像到容器:一次完整施工
以新副本 orders-api-k8w2t 落到 node-c 为例,kubelet 拿到任务后的施工顺序:
- 对账:对比 Pod 声明与本节点现状,确认这是新任务;
- 造沙箱:经 CRI 让运行时先起 pause 容器,占住网络命名空间,CNI 插件随即为沙箱分配 Pod IP(1.3 节的伏笔在此兑现);
- 拉镜像:本地缓存没有 orders-api:1.4.2 就去仓库拉取,拉取进度会写入事件;
- 建容器:按声明组装容器参数(镜像、环境变量、挂载卷、资源限制),创建后启动主进程;
- 回报:容器状态写入 Pod 的 status 段,READY 由接下来的探针决定(下一节)。
整个过程在事件流里全程留痕,这正是 describe 能讲出完整故事的原因:
kubectl describe pod orders-api-6d9f7c8b5-k8w2t -n production | grep -E "Pulling|Created|Started|Allocated" # Normal Pulling 3m kubelet Pulling image "orders-api:1.4.2" # Normal Pulled 3m kubelet Successfully pulled image in 8.2s # Normal Created 3m kubelet Created container orders-api # Normal Started 3m kubelet Started container orders-api
施工中的每一步都可能卡壳,状态列的"行话"直接指向卡点:ErrImagePull 是仓库认证或镜像名问题;ImagePullBackOff 是拉取失败进入退避重试;ContainerCreating 停留过久通常是镜像太大或网络太慢。
💡 关键直觉:kubelet 是"声明的执行翻译器"。它不做任何超出声明的决定,但也不容忍现状偏离声明——容器意外退出时按 restartPolicy 重启,这正是第4章自愈机制在节点侧的最小形态。
案例:一次 ImagePullBackOff 的定位
背景:滚动发布新版本后,node-b 上的新副本停在 ImagePullBackOff,其余节点正常。
操作:
# 第一步:看事件段的具体报错 kubectl describe pod orders-api-7b6d4c9f8-t2m9p -n production | tail -4 # Events: # Warning Failed 2m kubelet Failed to pull image "orders-api:1.5.0": # failed to pull and unpack image ... unauthorized: authentication required # Warning BackOff 1m kubelet Back-off restarting failed pull # 第二步:核对节点凭据配置,发现 node-b 的仓库登录凭据过期 # 第三步:更新该节点的镜像拉取凭据后观察 kubectl get pod orders-api-7b6d4c9f8-t2m9p -n production # NAME READY STATUS RESTARTS AGE # orders-api-7b6d4c9f8-t2m9p 1/1 Running 0 1m
结果:凭据修复后 kubelet 自动重试成功,副本就绪,无需人工干预调度。
解读:故障只在 node-b 出现,而声明是同一份——问题必然在节点局部(凭据、网络、磁盘),而不是声明本身。**"个别节点故障找局部,全部节点故障查声明"**是落地类故障的分水岭判断。另外注意退避机制:拉取失败后重试间隔从 10 秒指数增长,修复后恢复有几十秒延迟属正常。
变式:私有仓库的正规做法是在 Pod 声明里引用 imagePullSecrets,凭据随声明分发而不是散落在各节点,避免本案例这种逐台排查的被动局面。
本节要点回顾
- kubelet 三件事:盯任务、管施工、报进度,状态数据是 describe 与监控的共同源头;
- CRI 是防火墙:kubelet 与运行时解耦,运行时可替换而声明不变;
- 施工五步:对账、造沙箱(pause 先行)、拉镜像、建容器、回报,事件流全程留痕;
- 状态行话对应卡点:ErrImagePull 查仓库、ImagePullBackOff 等退避、ContainerCreating 查网络与镜像体积;
- 分布特征是分水岭:个别节点故障查节点局部,全体故障查声明共性。
容器已经跑起来,但还差最后一道工序:集群如何判定它"能接活"。下一节的探针就是这道工序的裁判——判错规则、判错后果,全部由你在声明里立下。