2.3 etcd与Watch机制:声明的账本与广播站
2.3 etcd 与 Watch 机制:声明的账本与广播站
etcd 是集群唯一持久化存储:所有资源对象的 spec 与 status 都以键值形式存于其中,且只有 API Server 有权读写。Watch 是 API Server 提供的订阅接口:客户端盯住某类资源的变更流,从指定版本号开始接收增量事件。账本加广播,构成控制平面的记忆与神经系统。
三道安检通过后,声明终于要落账。这一节回答两个此前悬而未决的问题:为什么集群里只能有一本账;以及入账之后,调度器和控制器凭什么"立刻知道"有新活要干。理解到这一层,第3章的调度行为与第4章的自愈行为都不再是魔法。
账本与广播站
先看账本。etcd 是一个分布式键值存储,靠共识协议保证多副本之间的强一致。在 Kubernetes 里它的角色被刻意收窄成一件事:当唯一真相源。设计上有两条铁律:
- 只有 API Server 能读写它,其余组件想看状态,一律走 API Server 的接口;
- 存的不只是你的 spec,还有集群回填的 status,以及一个每次修改都会递增的 resourceVersion。
resourceVersion 值得专门盯一眼,它就是账本的页码:
# 读一个对象当前所在的页码 kubectl get deployment orders-api -n production -o jsonpath='{.metadata.resourceVersion}' # 184553 # 任何一次改动(哪怕改一个标签)都会让它前进 kubectl label deployment orders-api -n production team=orders --overwrite kubectl get deployment orders-api -n production -o jsonpath='{.metadata.resourceVersion}' # 184612
页码的价值在于增量同步。客户端不必反复全量拉取,只要报出"我读到第 184553 页",服务端就能把之后的变更一条条补发给它。这正是 Watch 接口的工作方式。
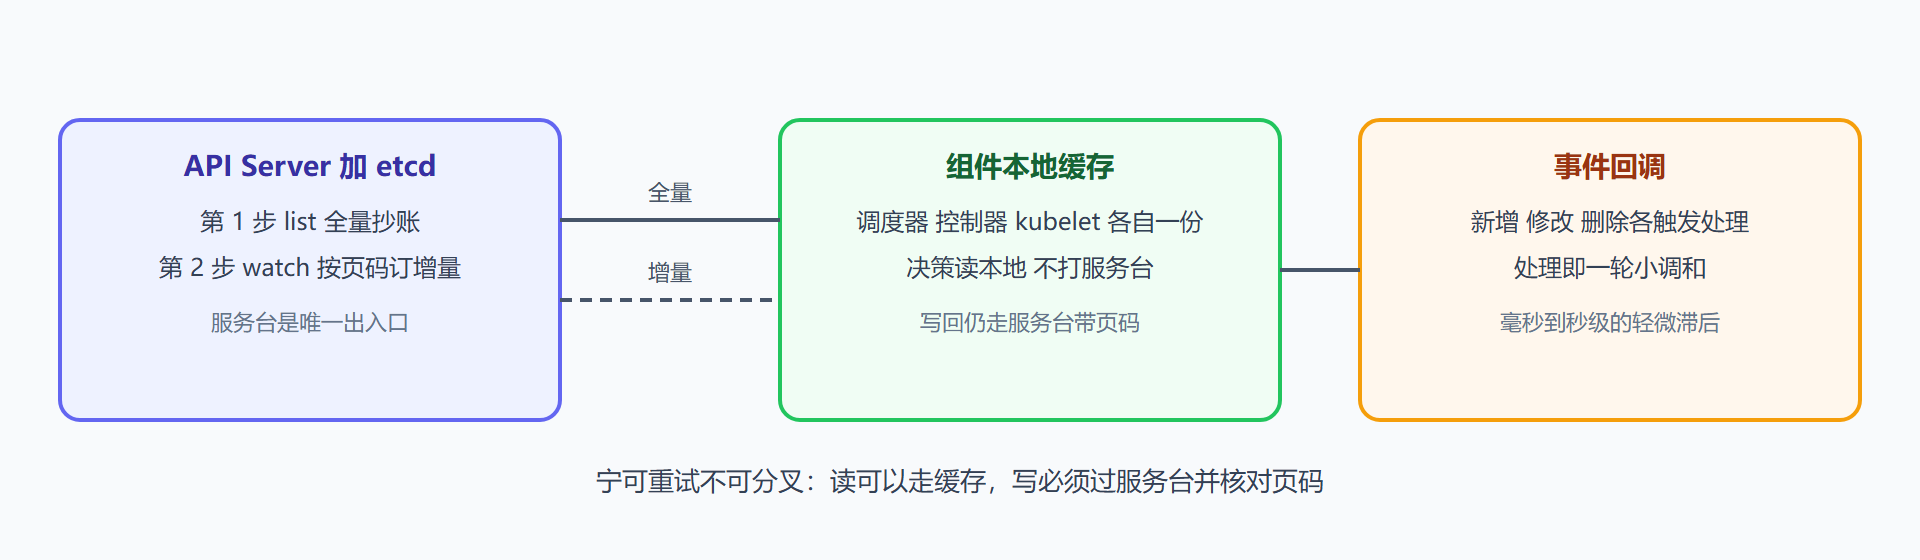
再看广播。API Server 提供两类读接口:get 与 list 是"去服务台抄一页账";watch 则是"在服务台登记一个长期关注的专栏,有新页就推送给我"。调度器 watch 未绑定节点的 Pod,控制器 watch 副本数差值,kubelet watch 分给自己的 Pod——每个组件都在听自己职责范围内的专栏。组件侧还配有一层本地缓存(Informer 机制):先 list 一遍建缓存,再靠 watch 增量维护,避免每次决策都打服务台。
观察 Watch:一次声明的可见传播
Watch 不是抽象概念,kubectl 自带开关能直接体验。开两个终端就能看到"入账即广播":
# 终端一:订阅 production 空间的 Pod 变更流 kubectl get pods -n production -w # NAME READY STATUS RESTARTS AGE # orders-api-6d9f7c8b5-2vxk7 1/1 Running 0 3h # ... # 终端二:手动创建一个排查用的临时 Pod kubectl run debug-tools --image=debug-tools:1.0 -n production # pod/debug-tools created # 终端一随即滚出三行增量事件(不重新拉全量): # debug-tools 0/1 Pending 0 0s # debug-tools 0/1 ContainerCreating 0 2s # debug-tools 0/1 Running 0/1 5s
三行输出对应 Pod 生命周期的三次落账:调度器绑定节点时写入 nodeName(Pending)、kubelet 汇报建容器进度(ContainerCreating)、kubelet 汇报启动成功(Running)。你看到的每一行,都是某个组件往账本上写了一笔,然后被 Watch 推送到你的终端。同样的推送,此刻也发往调度器、控制器等所有订阅者。
| 对比项 | get 与 list | watch |
|---|---|---|
| 模式 | 一问一答,问一次答一次 | 长连接订阅,持续推送 |
| 数据量 | 全量或按需 | 仅增量事件 |
| 典型消费者 | 人工排障、脚本 | 调度器、控制器、kubelet |
| 时效 | 取决于轮询频率 | 秒级,事件驱动 |
组件侧的完整取数姿势是"先全量建缓存、再增量维护"两步,这套模式叫 Informer:
图 2-3:Informer 的本地缓存与增量维护
一致性的边界:最终一致的世界
有一层窗户纸要捅破:各组件的本地缓存相对账本存在毫秒到秒级的滞后。Informer 模式下,组件基于"刚刚同步过的账"做决策,如果决策所依据的一页已被别人改过怎么办?答案是乐观并发控制——写回时带上自己读到的 resourceVersion,页码对不上说明有人先改了,本次写回被拒、重读重来:
# 两个人同时改同一个对象,后提交者会被页码校验拦下 kubectl apply -f orders-deploy.yaml # Error from server (Conflict): error when applying patch: # ... Operation cannot be fulfilled on deployments.apps "orders-api": # the object has been modified; please apply your changes to the latest version # kubectl 会自动重试读改写,通常第二次就成功
这个报错在自动化脚本对接 API 时很常见,不是故障,是账本在防并发覆盖。kubectl 内部会自动重读重试,你几乎无感;但自己写控制器(第4章)或调 API 时,必须正确处理这类冲突。
💡 关键直觉:把集群想象成一家"账本唯一、广播订阅"的机构。任何人可以稍慢地知道最新状态,但任何人都不可能绕过账本改状态——宁可重试,不可分叉。
案例:一次节点宕机中的账本视角复盘
背景:一台工作节点整机失联,上面跑着 orders-api 的一个副本。团队想搞清楚"从失联到副本恢复"之间各组件都做了什么。
操作:事后按账本的时间线复盘(事件时间可从 events 与控制器日志取到):
# 取节点相关事件,按时间排序 kubectl get events -n production --sort-by=.lastTimestamp | tail -8 # ... node-c 状态 NotReady,kubelet 停止心跳上报 # ... 标记 node-c 上的 Pod 为 Terminating(超过容忍时限后) # ... deployment 控制器发现副本 2 小于期望 3 # ... 新 Pod orders-api-6d9f7c8b5-k8w2t 创建并调度到 node-a
结果:约两分钟后副本数回到 3,业务流量无感。
解读:整条链路没有任何组件之间直接通话——kubelet 失联表现为账本上 Pod 状态停更,节点控制器写入 NotReady 与 Terminating,部署控制器从 watch 流里看到副本差值,创建新 Pod,调度器看到未绑定 Pod,选址落账。每一环都是"读账、算差、写账",广播自动把接力棒传给下一环。
变式:如果失联的是承载 etcd 的控制平面节点,故事完全不同——账本本身的多数派还活着才能继续受理写入,这正是生产集群 etcd 至少三节点的原因。账本是单点依赖,它的可用性就是集群的可用性。
本节要点回顾
- 唯一账本:etcd 只被 API Server 读写,spec 与 status 同页存放,resourceVersion 是页码;
- Watch 是神经系统:组件订阅各自专栏,事件驱动、秒级感知,Informer 缓存减少服务台压力;
- get -w 可直接体验广播:滚出的每一行都是一次落账的推送;
- 乐观并发控制:写回带页码,冲突被拒后重读重试,宁可重试不可分叉;
- 自愈的形态:节点失联恢复链全程无组件直连,全靠账本与广播完成接力。
账本与广播就位,声明随时可以被认领。下一章切到工作节点一侧:调度器如何按资源与规则为 Pod 选址,kubelet 如何把镜像变成运行中的容器,探针又如何接管健康裁判权。