5.1 Service:Pod消亡之后的稳定入口
5.1 Service:Pod 消亡之后的稳定入口
Service 是 Kubernetes 的四层负载均衡抽象:用一个创建后不再变化的虚拟 IP(ClusterIP)与端口,把流量转发给"通过 selector 选中的、且处于就绪状态的 Pod 集合"。转发规则由每台节点上的 kube-proxy 维护,Pod 的生灭只影响后端名单,不影响入口地址。
orders-api 的副本在滚动更新里换了一茬又一茬,但上游的支付服务一直用同一个地址调它——这个地址就是本节的主角。Service 要讲透三件事:稳定入口是怎么实现的(不是你想的那个"代理服务器")、后端名单如何随标签与探针动态伸缩、四种类型各自换来什么。
会消亡的 Pod 与不朽的名字
先看声明。给 orders-api 配一个集群内入口只需要这几行:
apiVersion: v1 kind: Service metadata: name: orders-api namespace: production spec: type: ClusterIP # 默认类型:集群内可达的虚拟 IP selector: app: orders-api # 圈定后端:带此标签的 Pod ports: - name: http port: 80 # Service 对外暴露的端口 targetPort: 8080 # 转发到容器的端口
提交之后,验证三样东西——入口地址、后端名单、连通性:
kubectl apply -f orders-service.yaml # service/orders-api created kubectl get service orders-api -n production # NAME TYPE CLUSTER-IP PORT(S) AGE # orders-api ClusterIP 10.96.38.104 80/TCP 30s # 虚拟 IP 创建即固定,Pod 怎么换它都不变 kubectl get endpoints orders-api -n production # NAME ENDPOINTS AGE # orders-api 10.244.1.5:8080,10.244.2.8:8080,10.244.3.3:8080 30s # 三个就绪副本的 Pod IP 与容器端口,即转发名单 # 集群内任一 Pod 均可经稳定地址访问(DNS 名字与虚拟 IP 等价) kubectl run tmp --rm -it --image=busybox:1.36 -- wget -qO- http://orders-api.production:80/healthz # ok
现在拆穿一个普遍误解:ClusterIP 不是一台机器,也不是一个进程。它不会出现在任何网卡上,也没有谁在中间替你转发包。真正的机制是 kube-proxy 在每台节点上维护转发规则:目的地址命中该虚拟 IP 的流量,按规则改写到名单中某个后端。iptables 模式靠链式规则随机选路,ipvs 模式靠内核哈希表支持更多后端与更精细算法。规则分散在所有节点上,所以入口既不漂移也不单点——这就是"不朽的名字"的实现。
名单的动态伸缩也顺理成章:端点控制器持续核对"selector 选中的 Pod"与"READY 状态",探针失败的副本被移出名单(4.2 节滚动更新的底座),恢复后加回。Service 的 YAML 从不改动,名单却始终是新鲜的。
四种类型与一个特殊形态
type 字段把 Service 的暴露范围从内到外排成一列,对照着选:
| 类型 | 暴露范围 | 机制要点 | 代价与适用 |
|---|---|---|---|
| ClusterIP | 集群内 | 虚拟 IP 加端口 | 默认选择,内部互访 |
| NodePort | 集群外经节点端口 | 每台节点开同一高位端口 | 端口裸露、无 TLS,测试或自建 LB 后端 |
| LoadBalancer | 公网 | 云厂商配一个外部负载均衡器 | 依赖云环境、按 LB 计费,生产外露常用 |
| ExternalName | 集群内访问外部 | DNS 别名到外部域名 | 无转发逻辑,纯名字映射 |
图 5-2:四种类型的暴露范围逐级扩大
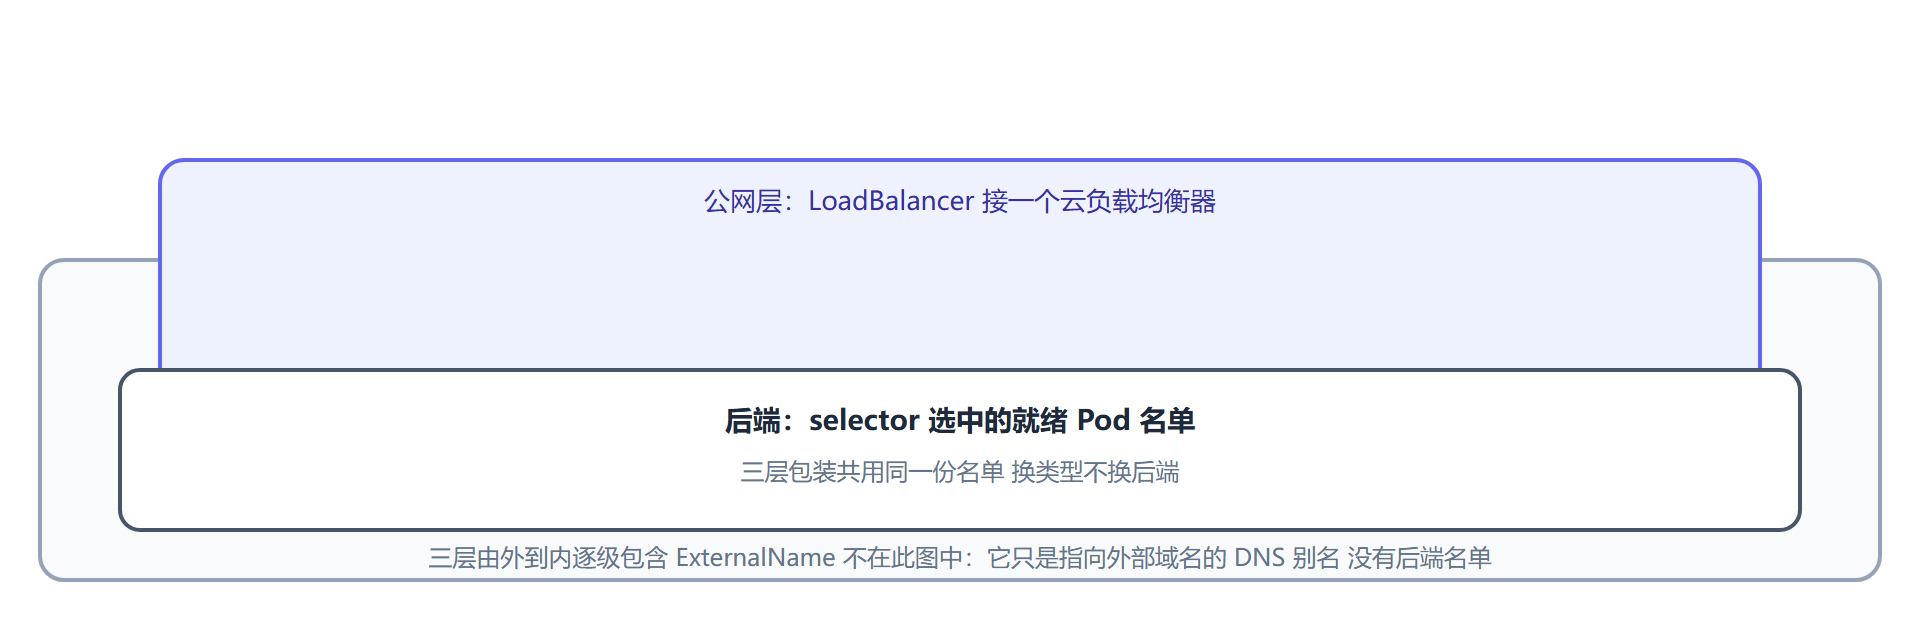
NodePort 与 LoadBalancer 是 ClusterIP 的逐级包装:NodePort 在虚拟 IP 之上多开节点端口,LoadBalancer 再在 NodePort 之上接一个云 LB。所以任何"外露"的 Service 依然带着虚拟 IP,集群内访问不受影响。
特殊形态是 headless Service:把 clusterIP 显式设为 None,Service 便不再分配虚拟 IP,DNS 查询直接返回所有就绪后端的 Pod IP 列表。客户端拿到的是"名单"而非"入口",适合需要直连个体、自己选路的场景——4.3 节 StatefulSet 的稳定域名(orders-db-0 之类)正是靠 headless Service 支撑的。
案例:一次"入口通了、请求全挂"的端点空名单排查
背景:支付服务反馈调 orders-api 全部超时,但 Service 明明存在、域名解析正常。
操作:
# 第一步:先查名单——入口存在不代表有后端 kubectl get endpoints orders-api -n production # NAME ENDPOINTS AGE # orders-api <none> 3d # 名单为空!入口没有任何可转发目标 # 第二步:核对标签拼写——selector 与 Pod 标签是否对得上 kubectl get pods -n production --show-labels | grep orders # orders-api-7b6d4c9f8-t2m9p 1/1 Running app=orders-api-v2 # 新版本滚动时把模板标签改成了 orders-api-v2,Service 的 selector 没跟上 # 第三步:对齐标签(改 Service 或改回 Pod 标签) kubectl set selector service orders-api app=orders-api-v2 -n production # service/orders-api selector updated
结果:selector 对齐后几秒内名单回填 3 个端点,支付服务恢复。
解读:Service 的联动全靠标签这条隐线——selector 是钩子,Pod 标签是挂环,两边任何一侧拼写漂移,钩子就挂空。这类故障的诡异之处在于"半通":DNS 正常、无虚拟 IP 报错、curl 集群内地址却全部超时。排障口诀:先看 ENDPOINTS 再看一切,名单空就查标签,名单满才查网络。
变式:另一种名单为空的常见原因是全部副本探针失败(READY 0/1),此时标签没错但无人够格入名单——结合 describe 的 Unhealthy 事件即可分辨两种病因。跨命名空间访问则要注意 DNS 全名(服务名加命名空间),短名只在本空间内解析。
💡 关键直觉:Service 是"标签的守门人 + 节点上的规则集"。入口稳定靠规则而非实体,名单新鲜靠标签与探针的持续核对——两根线都握在你写的声明里。
本节要点回顾
- 稳定入口的真相:ClusterIP 是规则不是实体,kube-proxy 在每台节点维护转发,故不漂移、不单点;
- 名单动态伸缩:selector 圈人、探针定资格,滚动更新与自愈的流量侧机制都在名单层;
- 四类型逐级包装:ClusterIP 是内核,NodePort 加节点端口,LoadBalancer 再接云 LB,按暴露范围选型;
- headless 返回名单:无虚拟 IP,DNS 直吐 Pod IP,StatefulSet 的稳定域名靠它;
- 排障先看 ENDPOINTS:名单空先查标签拼写,再查探针就绪,最后才怀疑网络。
四层入口有了,但生产外露还需要域名、路径与 TLS 这些七层能力。下一节的 Ingress 在 Service 之上再立一层总入口,把"api.shop.cn 进订单服务、admin.shop.cn 进后台"的分发逻辑也声明化。