4.3 工作负载图谱:StatefulSet、DaemonSet与Job
4.3 工作负载图谱:StatefulSet、DaemonSet 与 Job
Kubernetes 把"控制器加调和循环"复用成多种工作负载类型:Deployment 面向无状态服务;StatefulSet 给有状态应用提供稳定身份与独立存储;DaemonSet 保证每台(或选定的)节点恰好一份;Job 与 CronJob 负责跑完即退的一次性与周期任务。选型是声明设计的第一决策。
orders-api 是教科书式的无状态负载,但一个真实集群里还住着别的房客:主从复制的数据库、每台节点都要跑的日志采集、每晚对账的批处理任务。它们的共同点是都用调和循环驱动,差别全在"副本的Identity与生命周期"上。这一节把四类负载放进一张选型图谱,并各给出可落地的声明骨架。
不同兵种的编制
先看对照表,编制差异一目了然:
| 负载类型 | 副本身份 | 典型场景 | 缩容行为 |
|---|---|---|---|
| Deployment | 完全等价、可互换 | Web 与 API 服务 | 随机撤,无副作用 |
| StatefulSet | 稳定序号、独立存储 | 数据库、消息队列主从 | 从最大序号逆序撤 |
| DaemonSet | 每节点恰一份 | 日志采集、监控代理 | 节点移除即消失 |
| Job 或 CronJob | 任务完成即退出 | 批处理、定时对账 | 完成后保留记录 |
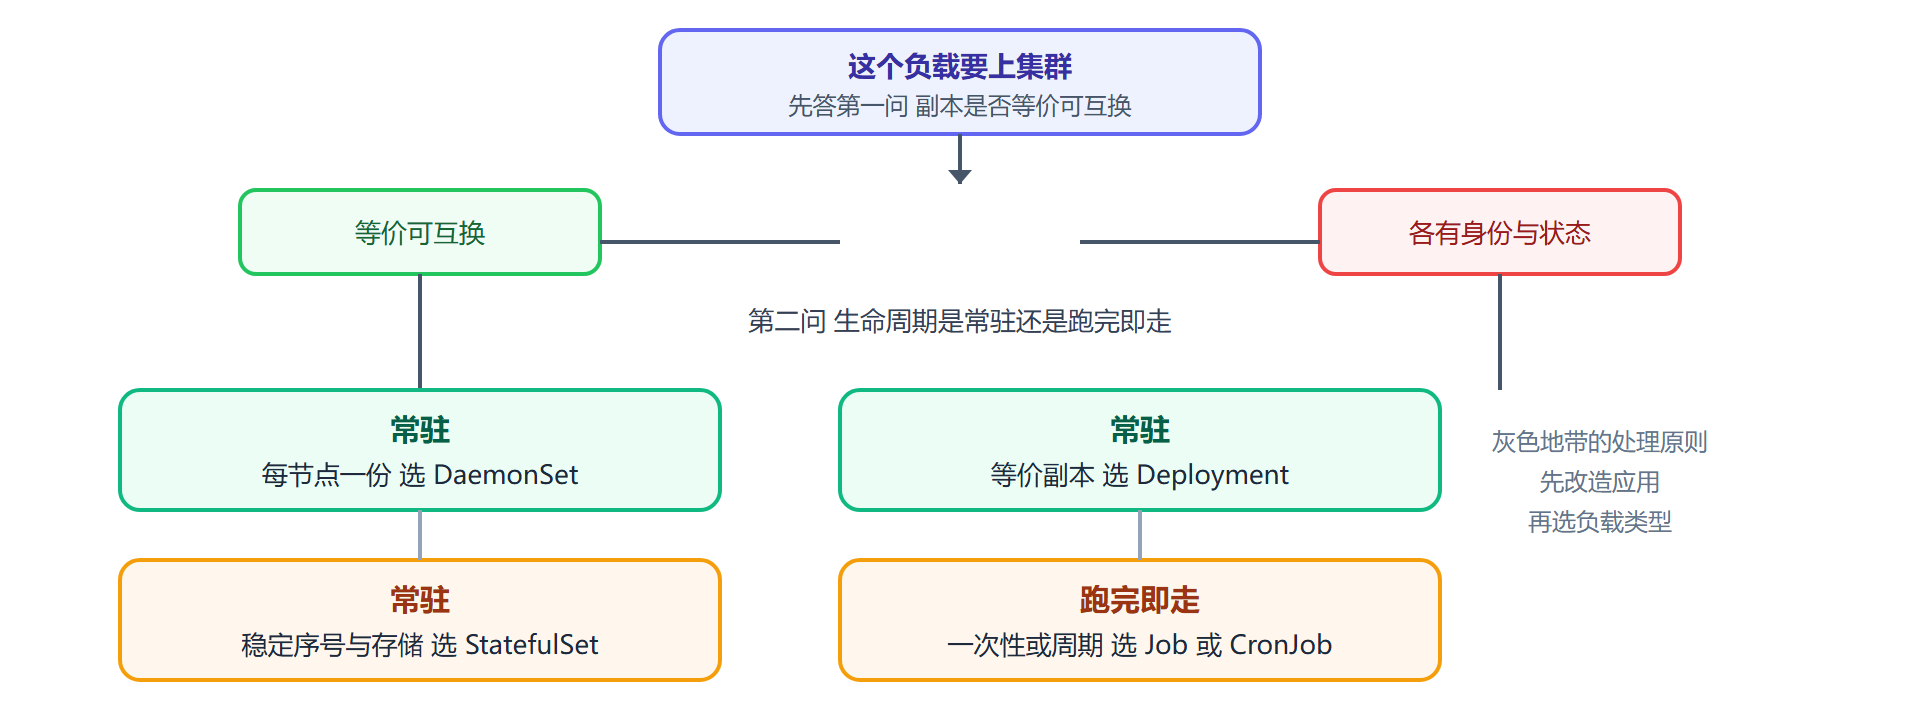
选型的判断题只有两道:副本之间是否等价可互换?生命周期是常驻还是跑完即走?两题的答案组合直接落到四种类型上,没有灰色地带——灰色地带意味着应用该先改造(比如把会话状态外移到缓存),而不是让编排迁就混乱。
图 4-2:四类工作负载的选型决策图
StatefulSet:有身份的副本
数据库集群是最典型的房客:三个节点分别扮演主与从,各有独立的磁盘卷、各自稳定的网络名,拓扑关系靠身份维系。StatefulSet 给的正是这三样:
apiVersion: apps/v1 kind: StatefulSet metadata: name: orders-db spec: serviceName: orders-db # 关联的 headless Service(第5章) replicas: 3 selector: matchLabels: { app: orders-db } template: metadata: labels: { app: orders-db } spec: containers: - name: orders-db image: orders-db:14.6 volumeMounts: - name: data # 每副本独立卷,来自卷模板 mountPath: /var/lib/postgresql/data volumeClaimTemplates: # 卷模板:为每个序号自动申领 PVC - metadata: name: data spec: accessModes: ["ReadWriteOnce"] resources: requests: storage: 100Gi # 申领制度详见第6章
创建顺序严格可预期:副本按序号 0、1、2 依次创建,前一个 Ready 才轮到下一个;每个副本得到形如 orders-db-0 的名字、由 headless Service 解析出的稳定域名、以及一块自己的卷。缩容时逆序回收,卷默认保留——数据的谨慎刻在类型语义里。
DaemonSet 与 Job:一节点一份与跑完即退
日志采集器要出现在每台节点上,节点扩容时自动跟进、节点下线时自动消失,这正是 DaemonSet 的语义(3.2 节的污点容忍组合在此标配):
apiVersion: apps/v1 kind: DaemonSet metadata: name: node-logger namespace: logging spec: selector: matchLabels: { app: node-logger } template: metadata: labels: { app: node-logger } spec: tolerations: # 系统级组件标配:容忍控制面污点 - key: node-role.kubernetes.io/control-plane effect: NoSchedule containers: - name: collector image: log-collector:3.2 volumeMounts: - name: varlog # 挂载节点日志目录(hostPath) mountPath: /var/log volumes: - name: varlog hostPath: path: /var/log # 节点本机目录,仅 DaemonSet 场景推荐
每晚的对账批处理则是 Job 的地盘。Job 的成功条件是容器退出码为 0,失败重试与完成计数都有参数可调:
# 跑一个一次性对账任务 kubectl create job nightly-reconcile --image=orders-jobs:1.1 -- /app/reconcile # job.batch/nightly-reconcile created kubectl get jobs # NAME COMPLETIONS DURATION AGE # nightly-reconcile 1/1 3m12s 4m # COMPLETIONS 1/1 表示一个任务完成一次,达到即整个 Job 收工 # 定时化:CronJob 按表驱动,每晚两点创建一个新的 Job kubectl create cronjob reconcile-daily \ --image=orders-jobs:1.1 --schedule="0 2 * * *" -- /app/reconcile # cronjob.batch/reconcile-daily created
案例:一次选错类型的迁移返工
背景:团队最初把主从架构的 orders-db 用 Deployment 部署(当时只想"先跑起来"),三副本共用一个 PVC。运行一周后问题集中爆发:副本重建后拿到的卷可能与前任不同,主从角色漂移,一次滚动更新后从库读到了旧主库的数据。
操作:返工三步——
# 第一步:按 StatefulSet 重建(卷模板保证每序号独立卷) kubectl apply -f orders-db-stateful.yaml # statefulset.apps/orders-db created # 第二步:确认按序创建与稳定身份 kubectl get pods -l app=orders-db -w # orders-db-0 0/1 Pending → Running (先 0) # orders-db-1 0/1 Pending → Running (0 就绪后才轮到 1) # orders-db-2 0/1 Pending → Running # 第三步:验证身份稳定性:删掉序号 1,重建后同名同卷 kubectl delete pod orders-db-1 kubectl get pvc | grep orders-db-1 # data-orders-db-1 Bound ... 100Gi # 卷还在,重建的 1 号继续用它
结果:主从拓扑稳定,滚动更新按序号逐个换、不再出现角色错乱;每副本独立卷也把原来三副本争抢一块盘的性能问题顺带解决了。
解读:Deployment 的隐含承诺是"副本可互换",数据库恰好不满足这个前提——选型错误时,调和循环依然忠实工作,只是它维持的是一个错误的声明。控制器永远兑现你写下的期望,哪怕期望本身是错的。
变式:跨集群的分布式数据库(每实例既要有身份又要弹性调度)有时会跳过内置负载类型,用自定义控制器或 Operator 直接管 Pod——第7章会再遇到这个思路;单体遗留系统迁移则常用 StatefulSet 加单个副本起步,先获得稳定身份与存储,再逐步拆分。
本节要点回顾
- 选型两问:副本是否等价可互换、生命周期常驻还是跑完即走,答案组合直接定类型;
- StatefulSet 三件套:按序创建、稳定网络身份、卷模板配独立 PVC,逆序缩容且卷保留;
- DaemonSet 语义:每节点恰一份,节点进出自动跟进,污点容忍是系统组件标配;
- Job 以退出码定成败:COMPLETIONS 是验收表,CronJob 只是给 Job 加了时刻表;
- 控制器不审查期望的正确性:选错类型等于让系统精确地维持一个错误。
工作负载的编制齐了,但它们对外的门牌还没解决——Pod 的 IP 随重建而变,外部世界需要一个稳定的名字。第5章进入流量入口:Service、Ingress 与 NetworkPolicy。