7.2 排障现场:当声明与现状不一致时
7.2 排障现场:当声明与现状不一致时
Kubernetes 排障的本质是找出声明与现状的分叉点。本节给出一套按层推进的诊断手册:先分诊症状的分布特征,再依次过资源层(集群还有余量吗)、声明层(声明本身对吗)、落地层(调度与 kubelet 卡在哪)、流量层(端点与策略放行了吗),每层有固定命令与判读口径。
教程走到这里,每一章都埋过排障的种子:1.3 的 CrashLoop 取证、2.1 的空间误会、3.1 的账满机闲、3.4 的探针误杀、5.1 的端点空名单。本节把这些零珠串成一串——一套可以背下来的现场流程。它不是理论框架,是从历次故障里长出来的作战序列。
侦查手册:先分诊,再按层推进
第零步永远是分诊:症状的分布特征比症状本身更有信息量(3.3 节立过此原则)——个别副本异常查局部(节点、凭据、网络),全部副本异常查共性(声明、镜像、依赖)。分诊之后,按四层推进,每层一条判读口径:
| 层 | 问的问题 | 固定命令 | 判读口径 |
|---|---|---|---|
| 资源层 | 集群还装得下吗 | describe node 看 Allocated | 申报量逼近可分配量即账满 |
| 声明层 | 声明本身对吗 | get 加 -o yaml 逐字段核 | selector、标签、镜像名、探针路径 |
| 落地层 | 调度与启动卡在哪 | describe pod 看 Events | 按 FailedScheduling 与镜像类事件分流 |
| 流量层 | 名单与围墙放行了吗 | get endpoints 与策略实测 | 名单空查标签探针,超时查策略丢包 |
图 7-2:四层排查的推进顺序与分流
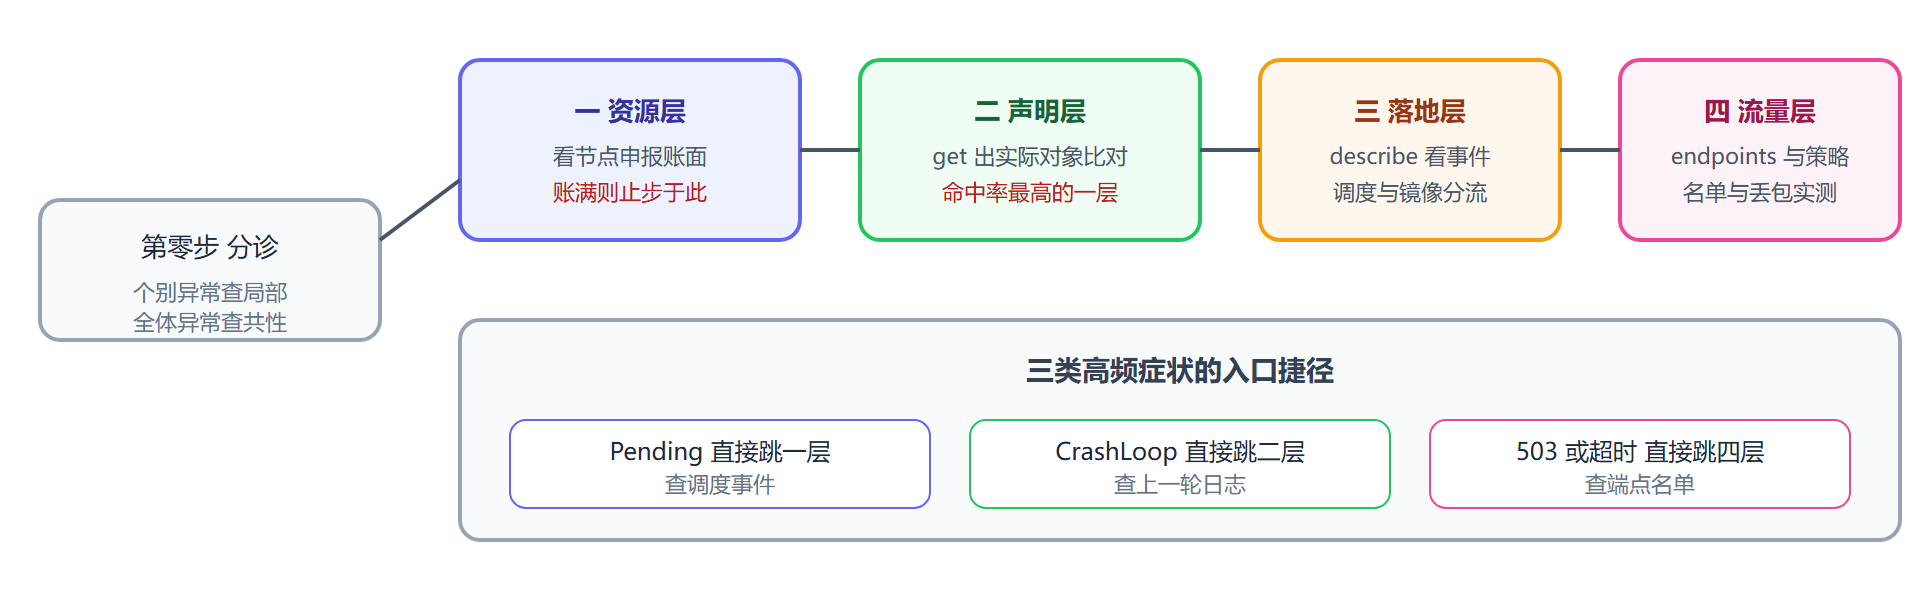
四层的顺序有意为之:资源层最快排除(一条命令),声明层排查成本高但命中率高(多数故障是"改了没改对"),落地与流量层依赖前两层的排除结果。跳层排查是新手最大时间黑洞——Pod 明明 Pending,却在查网络策略。
三类高频症状的速查分流,先把最常见的入口钉死:
# 症状 A:Pending——调度不动,查资源层与落地层 kubectl describe pod <pod> | tail -5 # Warning FailedScheduling 0/6 nodes are available: 6 Insufficient cpu # → 3.1 节路径:报价虚高或节点不足 # 症状 B:CrashLoopBackOff——起来了又死,查声明层 kubectl logs <pod> -p --tail=10 # FATAL cannot connect to db: dial timeout # → 1.3 节路径:配置、依赖、凭据三类共性因 # 症状 C:服务 503 或超时——入口在、请求不通,查流量层 kubectl get endpoints <svc> -n production # ENDPOINTS <none> # → 5.1 节路径:标签漂移或探针全败
综合案例:一次四层全过的真实故障
背景:周五晚高峰,网关报 orders-api 错误率飙到 30%,监控显示 3 个副本只剩 1 个 READY,另两个 CrashLoopBackOff。
操作:分诊先行——2 个副本异常、1 个正常,属"个别异常",先查局部;但 CrashLoop 属声明层症状,两条线索并行——
# 第一步(落地层证据):看异常副本的上一轮日志 kubectl logs orders-api-7b6d4c9f8-t2m9p -n production -p --tail=6 # FATAL config parse error: /etc/orders/app.properties line 5 # 第二步(声明层核对):新配置是 17:50 发布的,时间吻合 kubectl get configmap orders-config -n production -o yaml | grep -A8 app.properties # db_host=db-new.internal # db_port=5432 # db_password=${DB_PASSWORD} ← 第 5 行:引用未展开的占位符 # 第三步(定位责任):运维改 ConfigMap 时误把凭据占位符写进文件, # 而 DB_PASSWORD 走环境变量注入(6.1 节),文件里的占位符不会被展开 # 第四步(修复):改回正确键名后,CrashLoop 副本自动恢复 kubectl rollout status deployment/orders-api -n production # deployment "orders-api" successfully rolled out
结果:从告警到恢复 22 分钟,其中 8 分钟花在第一步之前的方向误判(先怀疑了数据库)。
解读:本案的教训有两条。其一,配置变更是有史以来最常见的事故源,时间相关性(发布时刻与故障时刻吻合)是第一线索;其二,排障最大的成本不是执行命令,而是方向选择——四层手册的价值就是把方向选择变成流程。
变式:同型故障还有"Secret 键名拼错、探针路径大小写不符、标签前后缀不一致",全部落在声明层,核对手段一致:拿 get -o yaml 的实际对象与最近一次变更 diff。落地层与流量层的案例在前文各有专案(3.3 的镜像凭据、5.3 的策略丢包),此处不重复展开。
把手册变成机制
排障能力的上限不是个人经验,而是机制沉淀。三件事值得制度化:
- ** runbook 进版本库**:四层手册的每一步命令与判读口径写成可执行的排障脚本或文档,新人照单操作;
- 告警对齐手册分层:资源层告警(余量)、声明层信号(变更事件)、落地层症状(重启计数)、流量层指标(错误率)各自有告警对应,让"告警响起即知道从哪层入手";
- 事后复盘回写声明:每次故障的修复最终应落到声明或规范的修改(补探针、改参数、加策略),否则同型故障必然重演——这与 4.1 节"声明是唯一遥控器"一脉相承。
⚠️ 常见坑:排障时随手 kubectl edit 修现场。眼下的故障消失了,但声明文件没变,下一次滚动或 GitOps 同步会把修复冲掉,故障轮回。任何修复都要回答一个问题:它被写进声明了吗?
💡 关键直觉:把每次故障都当作"声明与现状的一次意外对话"。你的工作是找到分叉点,把正确的那个版本写回声明——而不是在现场扮演人肉控制器。
本节要点回顾
- 第零步分诊:分布特征定方向,个别异常查局部、全体异常查共性;
- 四层固定序列:资源、声明、落地、流量,跳层排查是最大时间黑洞;
- 三类症状速查:Pending 查调度、CrashLoop 查配置、503 查端点;
- 时间是第一线索:故障时刻与变更时刻吻合,先审最近的那次变更;
- 修复必须回写声明:未沉淀进声明的修复会被下一次同步冲掉。
故障会越来越少,但声明会越来越多——单个集群的技艺已经完整,下一节面对最后的问题:一份 orders-api 声明要复制到几十上百个环境,Helm 与 GitOps 如何让规模化不失控。