3.1 数据导入导出与预处理
3.1 数据导入导出与预处理
本节摘要:导入函数负责把外部数据变成 Matlab 变量,预处理负责让数据达到可分析的质量。本节覆盖文本与表格导入、table 类型、缺失值与离群点处理、数据导出,并给出一条完整的清洗流水线。
数据形态决定分析写法
早期 Matlab 只有 matrix 一种容器,所有数据进来都被摊平成数。这在"数据全是数字"的年代够用;当实验记录带上了时间戳、设备编号、单位说明这些列,硬塞进 matrix 就要靠人脑记住"第 4 列是温度"。table 类型(R2013b 引入)就是这次演化压力的产物:列有名字、类型可混杂、缺失有标准记号。今天的选择题很简单:纯数值算矩阵,带元信息用 table。
导入:三代工具
M = load('data.txt'); % 最老一代:纯数值文本 N = readmatrix('sensor.csv'); % 二代:csv直接进矩阵 T = readtable('sensor.csv', ... % 三代:进table,保留表头 'VariableNamingRule','preserve');
readtable 之后可以按名取列,可读性立升:
T.Properties.VariableNames % 看列名 temp = T.temperature; % 点语法取列 T(T.temperature > 100, :); % 逻辑索引配合table,无缝衔接
导出同样分层次:writetable(T, 'out.csv') 存表格,save('run.mat','T','pars') 存工作区变量——.mat 是 Matlab 自己的二进制格式,保精度保类型,做实验快照首选。大文件的演化方向是 matfile,可以按需读部分变量而不必整个载入内存。
清洗流水线:缺失与离群
真实数据两类污点最常见。缺失值在 table 里记为 NaN(或 string 列的 missing):
missingRows = sum(ismissing(T), 2) > 0; Tc = T(~missingRows, :); % 剔除含缺失的行 Tf = fillmissing(T, 'linear'); % 或线性插值补齐
剔除还是填充?数据密集、缺失零散就插值;缺失成片、或缺失本身有含义(设备断电)就剔除并记录。这是个领域决策,不是技术决策。
离群点用 Z 分数或中位数绝对偏差识别,后者对离群点本身不敏感,更稳:
z = (temp - median(temp)) ./ ... (1.4826 * mad(temp)); outlier = abs(z) > 3; temp(outlier) = median(temp); % 中位数替换
图 一条数据清洗流水线
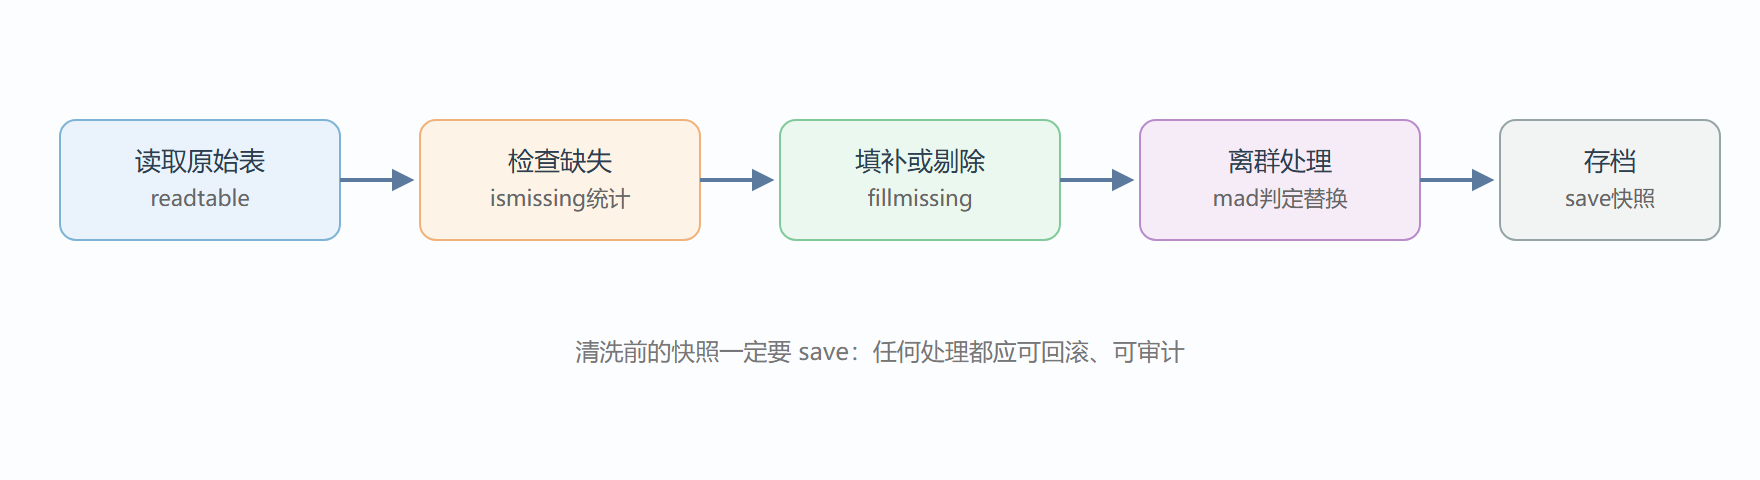
⚠️ 常见坑:对含
NaN的列直接mean会得到NaN。统计前先omitmissing(或旧写法'omitnan'),否则整条流水线的输出悄悄变空。
完整案例:一份脏数据的清洗全程
把流水线拼成完整过程。背景:某温控实验导出了一份 csv,列有时间戳、设备号、温度、压力,已知设备偶发掉电、传感器偶发尖峰。操作分四步走,每一步都落一个可检查的中间量:
% 第一步:导入并体检 T = readtable('sensor.csv', 'VariableNamingRule', 'preserve'); summary(T) % 每列类型、缺失计数一眼看清 height(T) % 行数 % 第二步:剔除掉电造成成片缺失的时段 gap = T.temperature; missRun = movsum(ismissing(gap), 50); % 50 点窗口内的缺失计数 T(missRun > 10, :) = []; % 缺失密集的段落整段剔除 % 第三步:散点缺失用时间线性插值 T.temperature = fillmissing(T.temperature, 'linear'); % 第四步:尖峰治理与快照 z = (T.temperature - median(T.temperature)) ... / (1.4826 * mad(T.temperature)); T.temperature(abs(z) > 3.5) = median(T.temperature); save('clean_snapshot.mat', 'T') % 快照落盘,之后可回滚
结果解读:summary 的输出里缺失计数若集中在少数几行,基本可判定是掉电;插值只应作用于零散缺口,成片缺口插出来的数据是编造的。变式:若温度列存在缓变漂移(基线漂移),在第四步之前加一步去趋势,用多项式拟合减掉基线即可,顺序不能反——先替换尖峰会污染基线估计。
导入报错与格式陷阱
导入环节的报错比看起来多。csv 分隔符是分号(部分欧洲设备导出)时,readtable 默认按逗号解析会得到单列怪物,加 'Delimiter',';' 即解;文件头混有非数据行(采集软件的说明文字),用 'NumHeaderLines', 3 跳过。日期时间列读进来是字符串时,datetime(T.timestamp, 'InputFormat','yyyy-MM-dd HH:mm:ss') 转换后才能做时间运算。Excel 多工作表要在调用里指定 'Sheet' 参数,否则永远只拿到第一张。最后是隐性的:数值列里混进一个 "N/A" 文本,整列可能被降级成字符串类型,str2double 抢救后配合 rmmissing 才能恢复数值形态——遇到"明明是数字却不能做算术"的情形,先用 class 查列类型。
辨析:剔除、插值与替换的边界
三种处理手段对应的假设不同。剔除假设"缺失/异常的样本没有信息量",代价是样本量缩水;插值假设"缺口两端之间是平滑过渡",对突变型信号(阶跃、冲击)是错误假设;中位数替换假设"异常点本该在典型值附近",对真正的极端物理事件(雷击记录)会把信号抹平。选择前先问数据来源:这一格为什么脏?答案不同,手段就不同。把处理决策连同理由写进注释或日志,半年后回看数据时才知道当时发生了什么——这属于可复现性的一部分,第 7 章还会回到这个话题。
本节要点回顾
- matrix 与 table 分工:纯数值 vs 带元信息,选错容器后面全程难受;
- 三代导入工具对应三个数据时代,新代码用
readtable; - 缺失处理是领域决策:零散插值、成片剔除并记录;
- MAD 比 Z 分数稳,离群点不会污染判定尺度本身;
- 清洗前先存快照,处理过程可回滚才算工程。