5.3 典型工具箱应用案例
5.3 典型工具箱应用案例
本节摘要:真实工程方案几乎总是多个工具箱的接力。本节用三个案例演示组合用法:振动信号的频域诊断、图像缺陷检测、参数寻优,每个案例给出从数据到结论的完整代码路径。
为什么讲组合
单工具箱教程遍地都是,但工程现场的问题从不按工具箱分类。一次振动诊断要用信号处理提特征、用统计学习做分类;一次缺陷检测要用图像工具箱预处理、再进学习模型;一次模型标定要用仿真跑样本、用优化工具箱反推参数。会组合,生态才算真正为你所用。
案例一:振动信号的故障特征提取
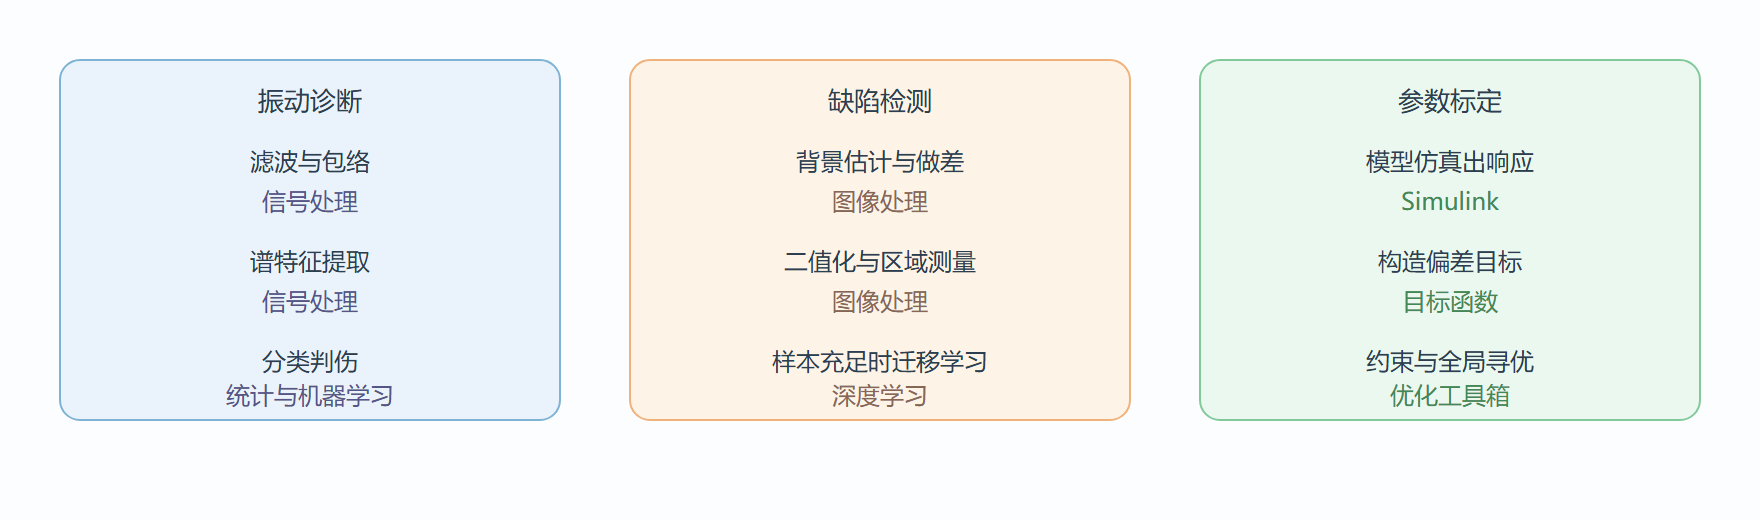
设备振动数据,怀疑轴承局部损伤。损伤的特征频率落在特定频带,思路是"滤波提带—包络解调—找峰":
% 信号处理工具箱 d = designfilt('bandpassfir', ... 'PassbandFrequency', [500 800], 'SampleRate', fs); env = abs(hilbert(filtfilt(d, x))); % 包络:解析信号取模 pspectrum(env, fs, 'FrequencyLimits', ... [0 200]); % 包络谱上找特征峰
hilbert 构造解析信号取模得到包络,是轴承诊断的经典手法。若要自动判伤,把每台设备的包络谱特征(若干频带能量)排成特征矩阵,交给 fitcsvm 训练分类器——信号处理负责"把物理变成数字",统计学习负责"把数字变成判据"。
案例二:图像缺陷检测
工业零件照片找划痕:
% 图像处理工具箱 I = imread('part.png'); Ig = im2gray(I); Bg = imgaussfilt(Ig, 15); % 大尺度背景估计 R = imabsdiff(Ig, Bg); % 减背景,突出细节 bw = imbinarize(R, 'adaptive'); % 自适应阈值 bw = bwareaopen(bw, 50); % 去小噪声连通域 stats = regionprops(bw, 'Area', 'Centroid');
流程是"估背景—做差—二值化—量区域"。没有训练样本时这套传统视觉流水线依然能打;有样本时,把 regionprops 的几何特征喂给分类器,或直接换深度学习工具箱的预训练网络做迁移——两条路线的取舍在样本量:百张以下传统法常更稳。
案例三:模型参数寻优
已知模型结构与实验数据,反求参数:
% 优化工具箱 + 仿真 function err = objFun(p) ysim = runModel(p); % 仿真得到响应 err = norm(ysim - yexp); % 与实验的偏差 end p0 = [1, 0.5]; popt = fmincon(@objFun, p0, [], [], ... [], [], [0.1 0.1], [10 5]); % 带上下界的约束优化
仿真在循环里被反复调用,目标函数就是"仿真输出与实验的偏差"。目标函数多峰时换全局优化工具箱的 particleswarm 粗搜,再用 fmincon 精修——两级搜索是参数标定的标准阵型。
图 三个案例的工具箱接力路径
💡 关键直觉:跨工具箱协作的接口往往就是矩阵与 table——上游的输出整理成矩阵,下游就拿得动。设计数据接口时按"通用容器"思考,组合难度会大幅下降。
案例一的完整过程与判读
把振动诊断补成完整闭环。背景:轴承内圈局部损伤会在振动包络谱上激起轴频调制的特征频率族。操作分四步——带通滤波保留共振频带、希尔伯特取包络、包络谱找峰、对照理论频率判型。前两步代码上文已给,判读环节如下:
fs = 12000; [E, f] = pspectrum(env, fs, ... 'FrequencyLimits', [0 300]); [pks, locs] = findpeaks(E, f, ... 'MinPeakProminence', 0.5, 'MinPeakDistance', 5); [~, bp] = max(pks); fprintf('主峰频率 %.1f Hz\n', f(locs(bp)));
解读:若主峰及其倍频与轴承内圈特征频率的理论值对得上(理论值由转速与轴承几何参数算出),判内圈损伤;只出轴频不成族,多半是不对中这类装配问题。变式:把"人看谱"换成"机器判",对每台设备提取若干频带能量作特征、健康与故障样本各若干,fitcsvm 训练后新设备一键判级——特征设计来自物理,判据交给统计,这就是工业诊断方案的标准分野。
案例三的展开:两级寻优为什么要分
参数标定直接上 fmincon 常见的问题是最优解随初值漂移——目标函数多峰,局部搜索掉进哪个坑看起点脸色。展开成两级:全局粗搜撒网点、局部精修收敛:
nvars = 2; lb = [0.1 0.1]; ub = [10 5]; opts = optimoptions('particleswarm', ... 'SwarmSize', 60, 'MaxIterations', 150); [prough, frough] = particleswarm(@objFun, nvars, lb, ub, opts); [pfine, ffine] = fmincon(@objFun, prowgh, ... [], [], [], [], lb, ub); fprintf('粗搜 %.4f -> 精修 %.4f\n', frough, ffine)
典型输出里精修值比粗搜再降一截,且换随机种子重跑结果稳定。工程经验:目标函数每 evaluations 都要跑一次仿真、代价不低时,全局搜索的预算要卡死(迭代数与群规模),把算力留给最后的精修。变式是拉丁超立方采样先扫一遍参数空间画响应面——若响应面明显单谷,两级寻优可以省掉,直接局部搜索。
组合方案的通用检查单
三个案例沉淀出的共性检查单,跨工具箱方案动手前过一遍:数据接口是否统一为矩阵或 table;每一步的中间产物是否落盘(哪一步出错能从最近快照续跑);授权清单是否覆盖全部用到的模块;全局随机种子是否固定(涉及随机初始化的算法要可复现);失败分支是否有兜底(某文件读不进时记日志跳过还是中止)。五条都过,方案才算从"能跑"升到"能交付"。
本节要点回顾
- 工程方案 = 工具箱接力,问题不按工具箱分类;
- 包络分析:滤波—
hilbert取模—包络谱,轴承诊断三板斧; - 传统视觉流水线在小样本场景依然是首选;
- 两级寻优:全局粗搜加局部精修,标定问题的标准阵型;
- 矩阵与 table 是通用接口,容器选对组合就顺。