6.3 外部语言接口与并行计算
6.3 外部语言接口与并行计算
本节摘要:与 Python 的双向互操作、与 C 的接口机制解决"连得上",
parfor与 GPU 计算解决"算得动"。本节讲两类能力的使用方式、适用判断与代价,重点是并行化的前提——迭代独立性。
没有系统是孤岛
Matlab 长期处在多语言生态里:老一代遗留系统是 Fortran 与 C,新一代数据科学栈在 Python。两种互操作路线由此长出——调进来(在 Matlab 里调 Python 与 C),调出去(在 Python 里调 Matlab 引擎)。并行计算则回应另一个压力:单核频率撞墙后,性能红利只能从多核与 GPU 里挖。
与 Python 互操作
R2014b 起 Matlab 内置 Python 接口,py. 前缀直接调用:
np = py.importlib.import_module('numpy'); arr = np.array(py.list([1.0, 2.0, 3.0])); double(arr) % 转回 Matlab 矩阵
反向也有官方路径:Python 侧安装引擎包后可以启动 Matlab 会话、传数组、取结果。注意边界处的类型转换成本——两边各有一套数据结构,跨一次边界就要转一次,高频小调用的方案会被转换开销吃光。合理用法是大块数据过一次边界,两边各自内部处理。
与 C 的接口是更老的传统:MEX 函数把编译好的 C 代码包装成普通 Matlab 函数调用,适合已有 C 库复用或热点的极致优化。维护成本不低,动用它之前先确认向量化与并行已经做到位。
并行计算:独立性是前提
parfor k = 1:1000 result(k) = monteCarloTrial(k); % 每次试验互不依赖 end
parfor 把循环分发给多个工作进程。能用的前提写在语法里:迭代之间不能相互依赖。x(k) = x(k-1) + a 这类递推写进 parfor 直接报错——不是工具苛刻,是并行语义本身不允许。判断口诀:把循环顺序打乱重跑,结果不变,就能并行。
% 蒙特卡洛示例:万次独立试验并行求 pi n = 1e6; inside = false(1, n); parfor k = 1:n p = rand(1,2); inside(k) = sum(p.^2) <= 1; end piEst = 4 * mean(inside);
再往上是 GPU:数据搬上显存后,大量内置函数自动按 GPU 版本执行:
G = gpuArray(X); % 上卡 Y = fft(G) * 2; % 自动用 CUDA 实现 Yhost = gather(Y); % 取回
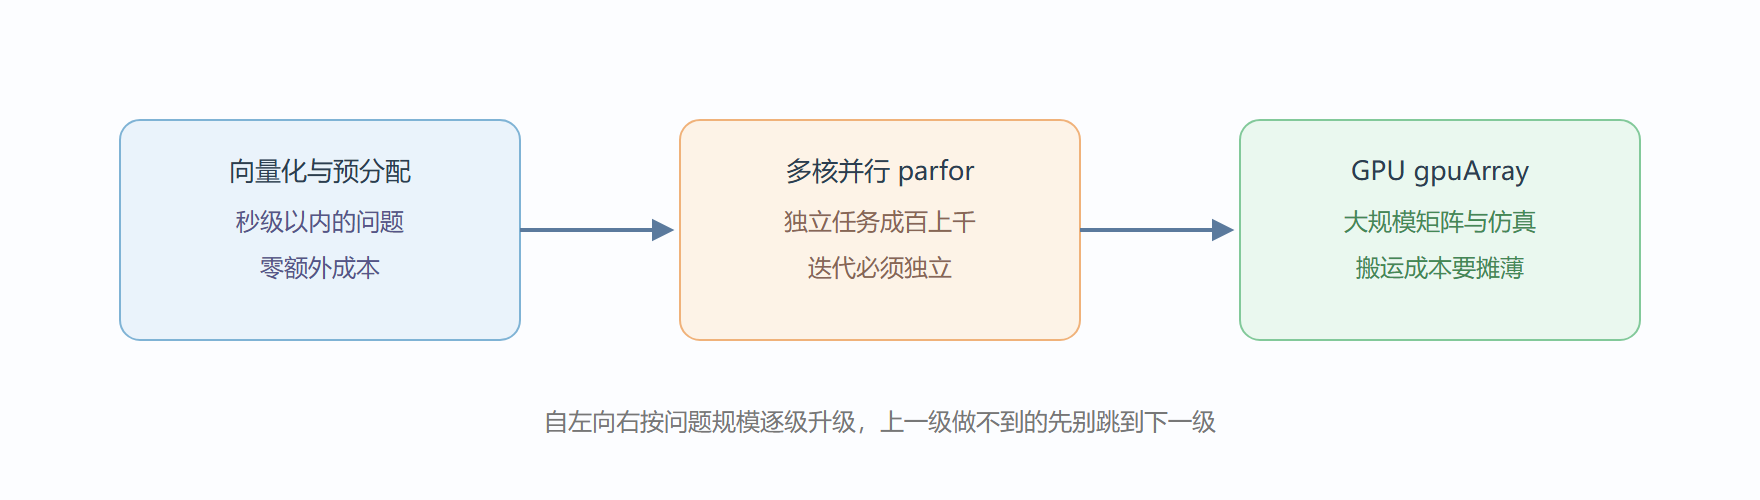
代价模型要心里有数:数据搬运过总线是显性成本,小数据上 GPU 纯属倒贴;真正受益的是"上卡一次、算很久、取回一次"的形态,大矩阵运算、大规模随机模拟都符合。
图 三层加速能力的适用规模
⚠️ 常见坑:在
parfor内调用绘图或写共享变量。工作进程没有界面也不共享工作区,随机数种子还需要parfor内部自动处理才能保证可复现——涉及随机模拟时验证一下各迭代确实拿到了不同流。
完整案例:一次并行的实际收益测量
背景:风场统计课需要十万次独立的流场模拟,串行预估要跑大半天。操作分三步,每步都留数据。先建本地进程池并测串行基线:
pool = parpool('Processes', 6); % 六个工作进程,按机器核数定 n = 1e5; tic; % 串行基线 s1 = zeros(1, n); for k = 1:n s1(k) = streamTrial(k); end tSerial = toc; tic; % 并行版本 s2 = zeros(1, n); parfor k = 1:n s2(k) = streamTrial(k); end tPar = toc; fprintf('串行 %.1f s,并行 %.1f s,加速比 %.1f\n', ... tSerial, tPar, tSerial/tPar) delete(pool)
结果解读:理想加速比接近进程数,实际通常打七折——折扣来自任务分发与结果回收的开销;单次试验越轻,折扣越狠,所以"把循环体内的活做大"(比如一批一万次试验作为一个任务)是并行的常用改写。变式与边界:若 streamTrial 内部还要读写同一文件,独立性被破坏,正确做法是让每次迭代写自己的临时文件,循环外汇总。测量还有个易错点:首次 parfor 要等进程池启动,几十秒的启动开销别算进并行耗时,正式计时前先空跑一轮预热。
互操作排错清单
Python 接口的报错多数集中在环境配对。按序排查:pyenv('Version', '路径') 指定的解释器是否为当前 Matlab 支持的版本区间(各版本支持区间不同,官方兼容表可查);py.sys.version 能否在命令行返回,返回即通路已建立;模块是否装在该解释器里而非系统默认解释器——两个 Python 共存时八成错在这里。MEX 侧的排错则围绕编译器配置:mex -setup 找不到支持的 C 编译器时,先装厂商编译器再重跑;改动 C 源码后记得重新 mex 编译,直接调用的还是旧二进制,这类"改了没生效"的悬案在 MEX 使用里排名第一。
并行层还有一个介于 parfor 与 GPU 之间的选项值得知道:parsim 面向 Simulink 仿真批量并行,spmd 面向需要在各进程间通信的分布式数组。多数用户一辈子只用 parfor 就够,但知道谱系的存在,遇到"每次仿真要跑一个模型"或"矩阵大到单机内存放不下"这两类场景时,知道该往哪个关键词去查。三层的共同心法不变:先把单核做对做快,再谈多发。
给三层加速配一张速断表,升级前先对照:单核耗时毫秒级,不值得任何优化;秒级且热点集中,向量化与预分配;分钟级且迭代独立,parfor;矩阵巨大或逐元素运算海量,GPU;热点无法向量化且算法已到极限,MEX。多数真实项目在前两档就解决了九成问题,后三档是给真正的大计算准备的——先测后升级的纪律,在每一档之间同样适用。
本节要点回顾
- 互操作两方向:
py.前缀调进来,引擎包调出去;边界处有类型转换税; - MEX 是老牌 C 接口,动用前先穷尽向量化与并行;
parfor的前提是迭代独立,打乱顺序结果不变才可并行;- GPU 的成本在搬运,上卡一次算很久的形态才划算;
- 三层加速逐级升级,规模决定层级。