7.3 金融与经济领域:量化分析工具链
7.3 金融与经济领域:量化分析工具链
本节摘要:金融业自八十年代末引入 Matlab,围绕时间序列分析、组合优化与风险度量长出专门工具链。本节用一条从收益率数据到组合配置的主线,讲金融数据的预处理、统计建模与优化配置,并说明回测的纪律。
从价格序列开始
金融数据的原子是价格序列,分析的起点是收益率:
ret = price2ret(price); % 价格转对数收益率
为什么用收益率不用价格:价格不平稳(有趋势),收益率近似平稳,统计工具才适用。这一步转换是金融计算与一般数据分析最大的分野——处理的对象是"变化的量"而非"量本身"。
mu = mean(ret); sig = std(ret); sk = skewness(ret); ku = kurtosis(ret);
偏度刻画崩盘侧的厚尾,峰度高于三说明极端事件比正态假设更频繁——2008 年之后,金融工程对峰度的敬畏深了一层。
波动率建模与协方差
收益率的一阶近似不相关,但波动率聚集(大涨大跌扎堆出现)。刻画它用协方差矩阵,组合层面的一切都建立在协方差上:
C = cov(rets); % rets: 多资产收益率矩阵,每列一只
组合优化:均值与方差的交易
% 期望收益 mu、协方差 C,最小化方差约束达到目标收益 n = numel(mu); H = 2*C; f = zeros(n, 1); Aeq = [mu'; ones(1,n)]; beq = [0.01; 1]; % 目标收益与满仓 w = quadprog(H, f, [], [], Aeq, beq, ... zeros(n,1), ones(n,1)); % 上下界:不许卖空
quadprog 求解二次规划,马科维茨框架在这十几行里完整落地:目标是最小化组合方差(二次项来自协方差),约束是达到目标收益且权重和为一。结果的敏感性要警惕:协方差估计的噪声会被优化器放大,权重对输入的微调可能剧烈跳动——实务中的收缩估计与权重约束都是为此而设。
图 量化分析的数据流
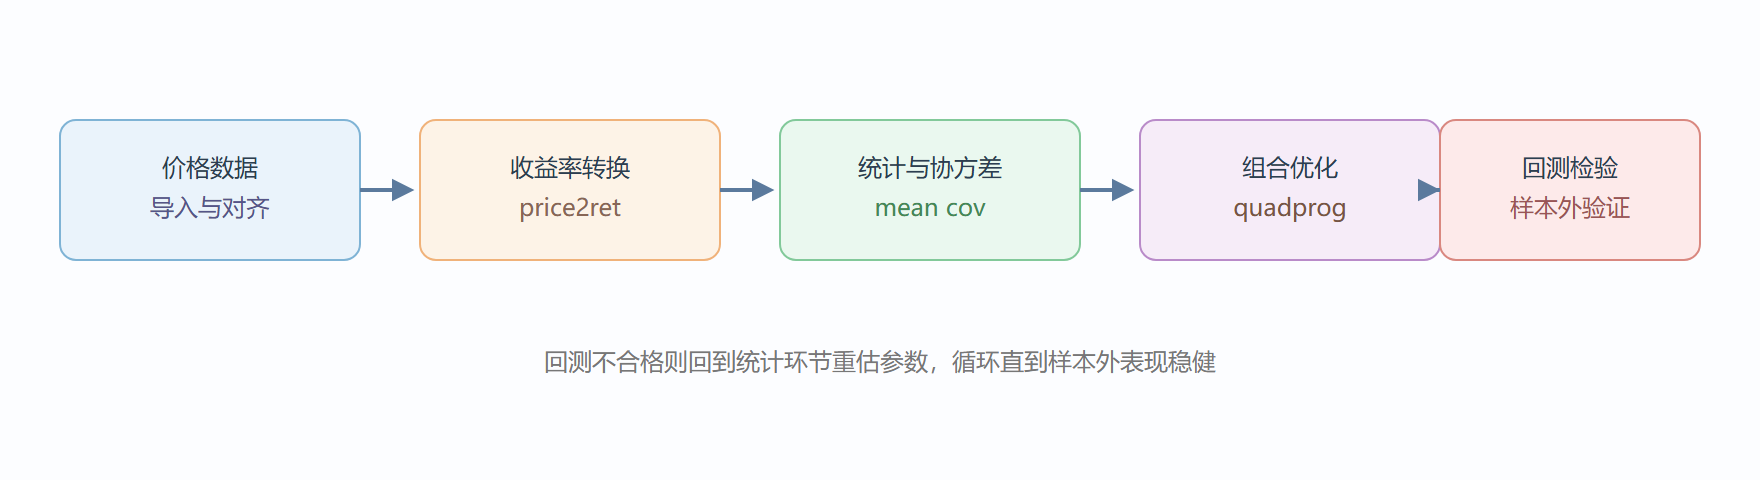
回测的纪律
回测是量化方法的检验场,也是自欺的重灾区。两条纪律:样本外检验——参数在一段数据上标定,必须在另一段未参与标定的数据上验证;避免前视——任何时点的决策只能用该时点之前的信息。前视偏差往往藏在"用全样本均值算收益率"这类不起眼的写法里,回测表现好得离谱时,第一反应应该是找偏差而不是庆祝。
⚠️ 常见坑:多资产数据按日期对齐被忽略,停牌与缺失日错位导致协方差失真。
timetable与synchronize专门解决对齐问题,合并多源数据前先统一时间轴。
完整案例:一次滚动窗口回测
背景:检验"等权组合每月再平衡能否跑赢买入持有"。操作分三段:构造数据、滚动执行、汇总对照。核心纪律——每月末只用截至当日的数据,下月收益在样本外自然产生:
% rets: 按日对齐的多资产收益率矩阵(行=日期,列=资产) nA = size(rets, 2); monthEnd = ismember(day(dates), 28:31); % 简化的月末标记 idx = find(monthEnd); wRB = zeros(numel(idx)-1, nA); portRB = []; portBH = []; wBH = ones(1, nA) / nA; % 期初等权,此后不动 for k = 1:numel(idx)-1 seg = rets(idx(k)+1 : idx(k+1), :); % 下一段:真正的样本外 portBH = [portBH, seg * wBH']; % 买入持有 wNow = ones(1, nA)/nA; % 等权再平衡 portRB = [portRB, seg * wNow']; wRB(k,:) = wNow; end cumRB = cumsum(portRB); cumBH = cumsum(portBH); plot(dates(idx(2:end)), [cumRB.' cumBH.']); legend('再平衡','买入持有')
结果解读:多数平稳市场里两条曲线差距很小,再平衡的收益主要来自波动率红利与风险控制,而非超额收益;一旦某资产长期单边上涨,买入持有胜出。这个"结论取决于市场形态"的结果本身就是答案——回测告诉你的是机制而非圣杯。变式:把等权换成上月的波动率倒数加权,就得到最简单的风险平价雏形;把再平衡周期从月改到季,检验结论对参数的稳健性。排错要点:任何一段的收益若用到了"当月月末之后"的数据,前视即告成立——代码评审时专门盯循环边界,是量化代码审查的第一课。
风险指标辨析:波动率、VaR 与 CVaR
三个指标常被混用。波动率(收益率标准差)度量双向波动,对称地惩罚涨与跌,适合刻画整体不确定性;VaR(在险价值)回答"给定置信水平下,最坏日子会亏多少",直观但有个数学上的缺陷——它不关心超过分位数的尾部有多深;CVaR(条件在险价值)度量尾部损失的期望,把"最坏情形平均有多坏"也计入,优化理论里它还保有凸性,适合做组合优化的目标。经验顺序:报告用 VaR 沟通直观,风控与优化用 CVaR 稳妥,波动率作为基准参照。三者都建立在收益分布估计之上,样本不够长时尾部估计极不可靠——回到本节开头的忠告:金融统计的第一课是敬畏数据之短。
数据源的工程细节在金融场景里比别处更致命。复权处理决定收益率算得对不对——用了未复权价格,每次分红除权都被当成暴跌;交易日历差异让跨市场对齐必须显式处理节假日;数据供应商的字段口径(收盘价是当时价还是事后调整价)要在第一次接入时逐字段核对。量化团队通常在数据接入层花掉最初两周,这笔时间不是浪费,是后面一切统计的地基。
本节要点回顾
- 收益率而非价格是金融统计的对象,平稳性是前提;
- 峰度与偏度刻画尾部风险,正态假设在市场里常不成立;
- 马科维茨框架在
quadprog十几行内落地,但对协方差噪声极敏感; - 回测两条纪律:样本外验证、严禁前视;
- 时间轴对齐用
timetable,错位的协方差毫无意义。