8.3 持续学习与未来方向
8.3 持续学习与未来方向
本节摘要:平台仍在演化,学习路径也应随之更新。本节梳理近年 Matlab 的演化趋势——云端化、AI 辅助编程、与开源生态互操作的加深——并给出仿真建模、数据分析、机器学习、工程部署四条深化方向的选择框架。
平台还在长
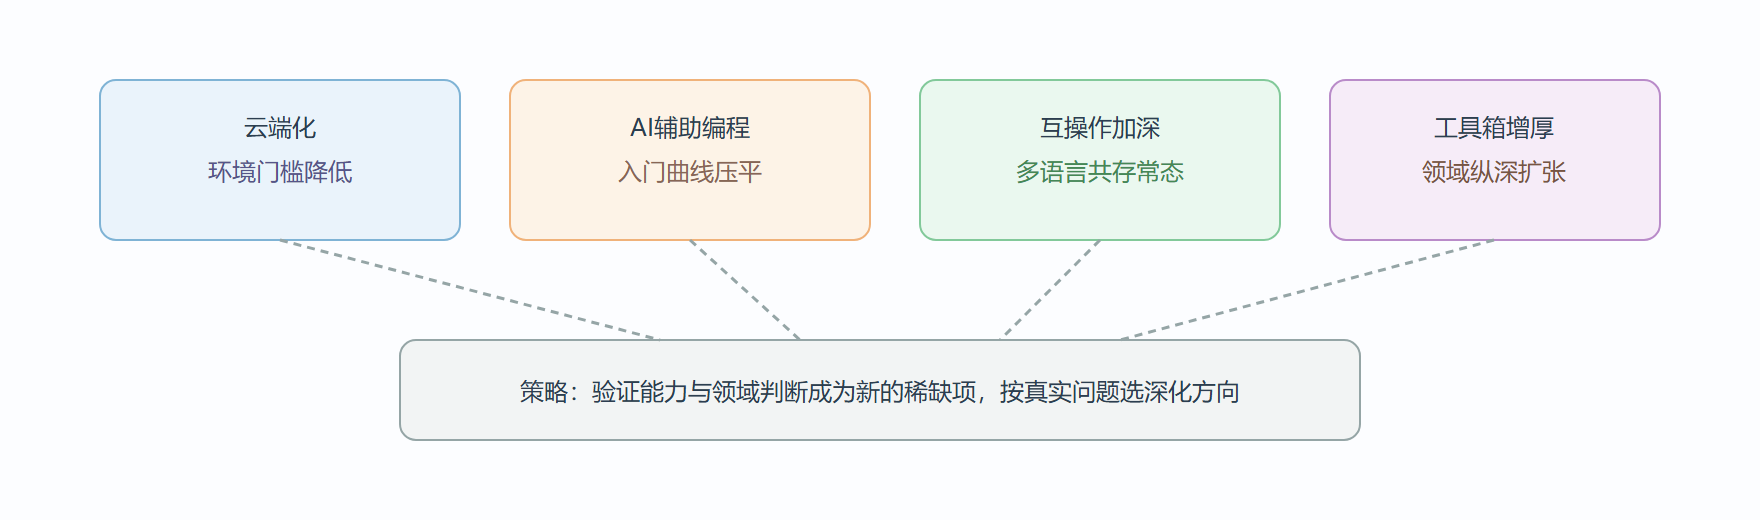
回看全册开头的演化时间线,故事没有停在"今天"。正在进行的几条演化线,每条都在改变学习策略:
- 云端与在线版本:浏览器里即开即用,安装与授权的门槛在消解;
- AI 辅助编程:对话式生成代码、解释报错、补全测试,入门曲线被压平,但判断与验证能力反而更值钱;
- 互操作加深:与 Python 的双向调用、与开源生态的数据格式互通越来越顺,"单一语言信仰"不再是必要立场;
- 领域工具箱持续增厚:深度学习、无线通信、自动驾驶仿真等方向的功能以版本为单位扩张。
四条深化方向
学完主干后的分岔口,大致四条路:
| 方向 | 核心能力 | 适合的人 | 深化标志 |
|---|---|---|---|
| 仿真建模 | Simulink、物理建模 | 控制与系统工程取向 | 能建带非线性的系统模型并做验证 |
| 数据分析 | 统计、时间序列、可视化 | 数据密集型科研与业务 | 独立完成从原始数据到决策建议 |
| 机器学习 | 特征工程、训练调优 | 想往智能应用走的人 | 能判断模型何时不可信 |
| 工程部署 | 代码生成、测试、集成 | 面向产品交付的团队 | 算法稳定运行在目标设备上 |
选择框架很简单:看你手头的问题属于哪一类。问题推着走的方向就是该深的方向——凭"哪个热门"选方向的人,多数在三个月后停滞,因为没有真实问题供养技能。
图 平台演化与学习策略的对应
与其他生态共处
一条务实的心态:工具是雇来的,不是嫁的。数据科学项目里 Matlab 与 Python 各有强项,互操作接口让"分析在 Python、领域计算在 Matlab"的混编完全可行;团队存量资产往往比技术优劣更该被尊重。你在第 6 章学过的接口与部署知识,就是这种混编工作的全部基础。
持续机制
学习不靠意志力靠机制:版本发布说明每半年浏览一次,只看与自己方向相关的部分;自己领域的新工具箱函数季度试一次;8.2 节的项目每季度做一个新的,难度递增。把这三件写进日历,比"我要坚持学 Matlab"这类决心可靠得多。
💡 关键直觉:平台每次演化都在降低入门门槛、抬高深层价值。焦虑"是不是白学了"的人看错了方向——被淘汰的从来是浅层技能,不是持续深化的人。
AI 辅助编程的正确用法:生成—验证工作流
AI 辅助是四条演化线里最需要"学习方法"的一条。生成的代码不能直接信,正确的循环是"生成—读懂—验证—收编"。举个真实流程:让助手写一个滑动窗口去均值函数,拿到代码后第一件事是读懂并造三个测试用例验证:
% 对 AI 生成代码的验证骨架:正常、边界、退化三用例 x1 = [1 2 3 4 5]; % 正常输入 x2 = [2 2 2 2]; % 常数序列:去均值后应全零 x3 = [7]; % 长度不足窗口:期望给出提示或原样返回 r1 = movingMeanRemove(x1, 3); r2 = movingMeanRemove(x2, 3); r3 = movingMeanRemove(x3, 3); assert(all(abs(r2) < 1e-12), '常数序列应被完全去除') % 再核对 r1 首尾边界行为与 r3 的处理方式是否符合预期
验证骨架本身比函数更重要:任何生成代码,都过"正常、边界、退化"三关再进项目。这个工作流里真正值钱的是你写测试用例的能力——它来自本册第 2 章的测试思维与第 3 章的数据直觉。AI 把"写出能跑的代码"的成本降到极低,于是"判断代码对不对"的成本成了新的瓶颈,本册花在断点、断言、验证上的篇幅,在 AI 时代反而增值。
每季一次的"新函数体检"
把"季度试一次新函数"落成可执行的仪式,也只需要十几分钟。从发布说明里挑一个与自己方向相关的函数,跑一个对照实验:
% 例:对比新旧接口在同一任务上的表达 % 老写法 b = fir1(64, 200/500); y1 = filter(b, 1, x); % 新写法 d = designfilt('lowpassfir', 'PassbandFrequency', 200, ... 'StopbandFrequency', 260, 'SampleRate', 1000); y2 = filtfilt(d, x); norm(y1 - y2(1+32:end)) / norm(y1) % 差异主要来自阶数与零相位
跑完问自己两个问题:新接口多表达了什么需求?旧代码要不要迁?答案记进个人笔记,一年四条,几年下来你对平台演化方向的判断力就建立起来了——这种判断力没法从任何单本教材买到,只能靠这种小实验持续喂养。
方向选择上再补一个自测方法,帮你在四条路里收窄到一条:翻出你最近三个月主动花时间琢磨的问题清单(不是任务清单,是没事也想摆弄的东西),把每个问题归到仿真、数据、学习、部署四类,计数最多的那类就是你的真实倾向。测试有效的前提是"主动"二字——工作任务Push出来的倾向不算数,因为那测的是岗位而不是你。选中的方向再做一个两周的小项目试婚,做得津津有味且愿意升级难度,方向就算落定;两周都熬不下来,换下一条重测,成本不过半个月,远低于在错误方向上硬扛两年。方向感不是想出来的,是试出来的,这与本册"动手优先于阅读"的立场一脉相承。
四条方向之间也不是单选题。仿真与部署在嵌入式团队天然并存,数据与机器学习在科研里本是一家——真正要避免的是四条同时追。常见失败样本:年初定四个方向的学习计划,年底每个都停在第三章。持续学习的现实策略是主线加副线:主线方向以项目深度推进,副线方向只保持"季度新函数体检"式的浅接触,等主线的项目产出稳定后,副线再视机会转正。深度换广度的时机由成果决定,不由日历决定。
本节要点回顾
- 四条演化线:云端、AI 辅助、互操作、领域增厚,各自改变学习策略;
- 四条深化方向按真实问题选,热门不该做主;
- 混编是常态,接口与部署知识是共处的基础;
- 学习靠机制不靠意志:发布说明、新函数、季度项目写进日历;
- 浅层技能贬值、深层判断升值,是演化给出的方向信号。