第1章 初识MongoDB:选型与安装的事故
第 1 章 · 初识 MongoDB:选型与安装的事故
章节摘要:本章解决三个问题——为什么会有 NoSQL、MongoDB 的架构长什么样、怎么把它正确地装起来。三个问题分别对应三起事故:用关系型思路硬扛海量半结构化数据导致迁移失败、驱动与服务器版本不匹配导致上线崩溃、数据目录权限错误导致服务起不来。读完本章,你能在选型讨论里说清 MongoDB 的边界,也能独立完成一次干净的部署。
学习目标
- 能说出 NoSQL 四大类别与 MongoDB 所属分支;
- 能解释文档、集合、数据库三层结构与 BSON 的关系;
- 能描述 MongoDB 单机架构(mongod、存储引擎、WiredTiger 缓存);
- 能在 Linux 上完成安装、目录规划与配置文件落地;
- 能独立排查"服务启动失败"这类最常见的初级故障。
核心概念速览
金句:MongoDB 不是"更快的 MySQL",它是把"结构"还给应用层的数据库——这一句话理解错,后面所有建模都会错。
本章知识版图
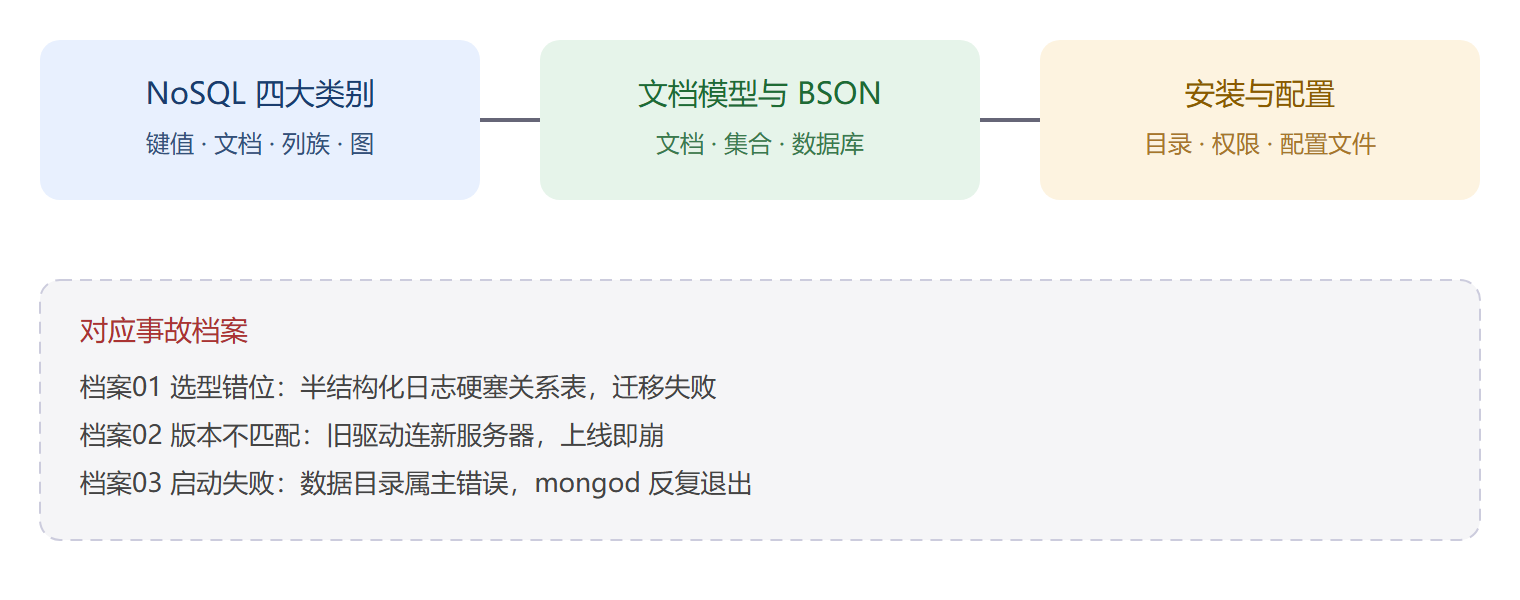
子章节导航
- 1.1 NoSQL 概述:从一次失败的迁移讲 NoSQL 的动机与四类分支,给出选型判据。核心产出是一份"该不该用 MongoDB"的判断清单,以及一张关系库与文档库逐维度的对照表。读完你应当能在选型会上把争论从口味之争拉回到数据形态本身:结构变更频率、联结密度、扩展诉求,三个问题定方向。
- 1.2 MongoDB 架构:从一次版本兼容事故讲 mongod、存储引擎、版本策略。这一节建立了后面所有章节的词汇表——WiredTiger 缓存、journal、驱动协议,第 10 章的缓存驱逐与本章的架构图是同一张图的不同局部。事故复盘部分给了升级的正确节奏:逐版本、先驱动后服务器、查兼容矩阵。
- 1.3 安装与配置:从一次启动失败讲目录规划、权限、配置文件与排查路径。四步排查法(读日志、查属主、验配置、最小启动)不只服务于安装,之后任何 mongod 起不来的场合都适用。配置项取舍表覆盖了缓存上限、oplog 大小、慢查询阈值这些第一批要动的参数。
子章节之间的逻辑关系
先判断"该不该用",再看"里面长什么样",最后"装起来跑通"——三节是决策链,不是知识清单。反过来看也成立:如果 1.1 的判据通不过,后面两节就不该发生;如果 1.3 的排查法救不了你的实例,问题多半出在 1.2 讲的组件层而不是安装层。
该不该用(1.1) ──► 里面长什么样(1.2) ──► 装起来跑通(1.3) │ │ │ 选型判据 架构与版本 排查套路
三起事故还有一个共同点值得点破:它们都不是数据库的 bug,而是使用者的假设与数据库的假设错位——假设结构稳定、假设升级无断层、假设目录权限无关紧要。带着"对齐假设"的意识读后面的故障年鉴,每一起都能读出双层的教训。
本章知识点核对清单
离开本章前,逐条自查:能否不看资料说出 NoSQL 四类分支各自的代表与短板;能否解释 BSON 与 JSON 的差异以及 MongoDB 三层结构(实例、数据库、集合)的对应关系;能否画出 mongod 进程内 WiredTiger 缓存、数据文件、journal 三者的写入路径;能否默写一份最小可用的生产配置文件骨架;能否对着一条 NonExistentPath 或 Permission denied 日志说出排查动作。任何一条卡住,回到对应小节的事故复盘里再走一遍定位过程。
前置知识与后续延伸
前置:基本的 Linux 命令行操作、JSON 读写能力。延伸:第 2 章开始进入数据模型与 CRUD,本章装好的实例正是后续所有操作的舞台。