4.1 聚合管道概念与内存超限事故
4.1 聚合管道概念与内存超限事故
本节摘要:聚合管道让文档依次流过多个阶段逐级加工,match 过滤、group 分组、$project 整形。本节从一次内存超限事故讲各阶段语义与 100MB 内存红线的由来与应对。
事故档案 08:一条聚合杀掉的主从切换
报表团队统计月度订单,管道是先 group 再 match。数据量上来后,mongod 日志出现:
QueryExceededMemoryLimitNoDiskUseAllowed: ... exceeded memory limit for stage, but didn't allow spilling to disk
聚合直接失败,同时巨大的排序与分组挤占缓存,其他业务查询延迟飙升,触发一次主从切换。两个根因:阶段顺序反了与没有 allowDiskUse。
管道语义速写
db.orders.aggregate([ { $match: { status: "paid", month: "2026-07" } }, // 先过滤:能吃索引 { $unwind: "$items" }, // 展开数组:一单多品变多行 { $group: { _id: "$items.sku", revenue: { $sum: "$items.amount" }, cnt: { $sum: 1 } } }, // 分组统计 { $project: { revenue: 1, cnt: 1, avg: { $divide: ["$revenue", "$cnt"] } } }, { $sort: { revenue: -1 } }, { $limit: 20 } ]);
各阶段语义:
| 阶段 | 作用 | 内存特征 |
|---|---|---|
| $match | 过滤文档 | 放最前可吃索引 |
| $project | 选列、计算新列 | 减小文档 |
| $group | 按键聚合 | 每组驻留内存,红线 100MB |
| $sort | 排序 | 全量驻留,红线 100MB |
| $unwind | 数组展开 | 放大文档数 |
| $lookup | 关联另一集合 | 每文档一次查询,昂贵 |
内存红线的应对
// 允许溢写磁盘:慢但不会失败 db.orders.aggregate(pipeline, { allowDiskUse: true });
group 与 sort 单阶段默认最多占用约 100MB,超限要么报错(如档案 08),要么溢写磁盘。allowDiskUse 是保险丝,不是性能优化——真正要做的是把 match 提前、把 limit 提前,让进入重阶段的文档尽可能少。
事故管道 vs 修复管道
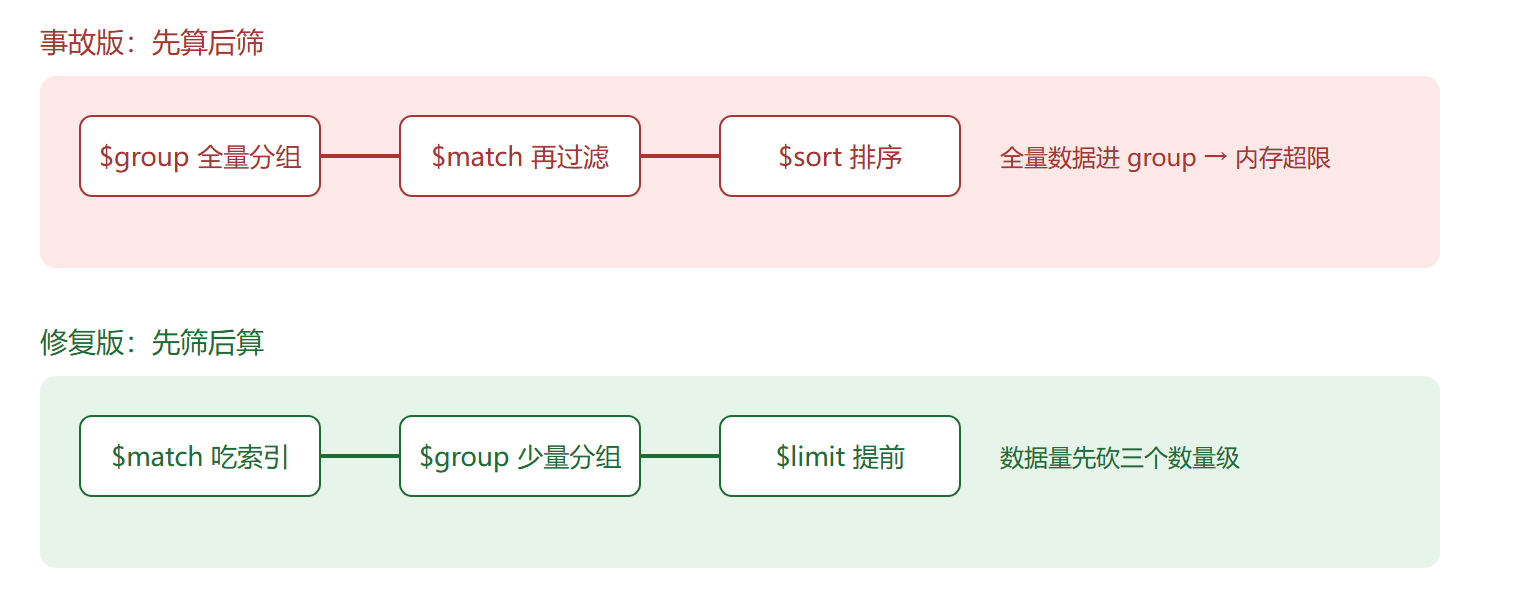
💡 评审聚合语句时我只看一件事:$match 之前还有没有别的阶段。有,就先问能不能挪。
事故复盘:一条报表查询如何触发主从切换
时间线还原:报表凌晨两点启动,$group 在内存里累积上千万个分组键,占用一路逼近 100MB 红线并触发大量缓存驱逐;两点十七分,业务库的读延迟从 5 毫秒涨到 800 毫秒,复制延迟同步攀升;两点二十一分,心跳检测判定主库不健康,复制集发起选举,主从切换期间写入中断九秒。第二天看日志才拼出因果链:一条没有过滤条件的聚合,吞掉了缓存,把整个实例拖下了水。
定位时最有用的一条命令是 explain 的 executionStats 模式,聚合同样支持。它逐阶段给出输出文档数与耗时,一眼看到哪个阶段是瓶颈:
db.orders.explain("executionStats").aggregate(pipeline, { allowDiskUse: true }); // 关注每个 stage 的 nReturned 与 executionTimeMillisEstimate // 事故版:$group 输入 4200 万;修复版:$match 先砍到 130 万
修复后的管道把 match { month: "2026-07", status: "paid" } 提到最前,配合 month 与 status 的复合索引,进入 group 的文档从 4200 万降到 130 万,分组键从千万级缩到 sku 数千个,内存占用回到 40MB 以内,聚合从"拖垮实例"变成普通的报表查询。
阶段顺序的等价性陷阱
match 与 project 的移动通常是安全的——过滤和选列与顺序无关,优化器甚至会自动把 match 推到 project 之前。但有两类阶段的顺序不能随手换。unwind 之后再 match,与 match 之后再 unwind,语义可能不同:过滤条件如果写在数组元素字段上(如 items.amount),必须在 unwind 之后过滤;条件若在外层字段(createdAt),提前就是纯赚。group 与 $sort 的先后则决定排序对象是明细还是聚合结果,顺序不同结果都不同。写管道时的自查方法是把每个阶段的输出文档数标注在旁边,数字膨胀的位置就是危险位置。
lookup 的内存行为也常被误解:它不受 100MB 红线约束,但每个输入文档要对目标集合执行一次匹配查询,外键无索引时等于 N 次全表扫描,慢的形式从"报错"变成"挂住不动",反而更难排查。评估 lookup 的正确姿势是先看 from 集合的 localField 有没有索引,没有就先补,这比任何参数调优都有效。
// $lookup 的正确打开方式:localField 必须有索引 db.orders.aggregate([ { $match: { status: "paid" } }, { $lookup: { from: "users", localField: "uid", foreignField: "uid", as: "buyer", pipeline: [{ $project: { name: 1, level: 1, _id: 0 } }] } }, { $unwind: "$buyer" } ]); // pipeline 参数让关联侧先减列,网络与内存都省
本节要点回顾
- 管道即流水线,每阶段消费上一阶段输出;
- group/sort 各有约 100MB 红线,超限需 allowDiskUse 或收敛数据量;
- $match 永远尽量靠前,可吃索引;
- $lookup 昂贵,能靠建模内嵌解决就不 lookup(见第 5 章)。