7.3 分片键选择与整改事故
7.3 分片键选择与整改事故
本节摘要:分片键要同时满足高基数、写分布均匀、高频查询携带三个条件;选错后唯一的根治是再分片(refineCollectionShardKey 或迁移重写)。本节从一次低基数键的整改讲选键方法与补救路径。
事故档案 17:按省份分片之后
物流平台按 {province: 1} 分片,全国 34 个省市最多 34 个 chunk 上限。广东一家的数据量是西藏的两百倍,分布死锁成"个别巨型分片 + 一堆空分片",且数据还在涨。这是教科书级的低基数键事故:键的取值数封顶了 chunk 数,均衡器无棋可走。
// 补救一(5.0+):在线细化分片键,追加高基数字段 db.orders.createIndex({ province: 1, orderId: 1 }); db.adminCommand({ refineCollectionShardKey: "logistics.orders", key: { province: 1, orderId: 1 } }); // 补救二:新集合换键重写,双写切换——数周工程
选键四问
- 基数够高吗:取值数至少应是预期 chunk 数的十倍以上;
- 写入均匀吗:单调递增字段(时间、自增 id)单独做键必热点,改哈希或复合;
- 高频查询带它吗:查询不带分片键就是全分片广播;
- 会变吗:分片键不可修改(只能细化追加后缀),业务上的可变字段不能当键。
候选键评估矩阵
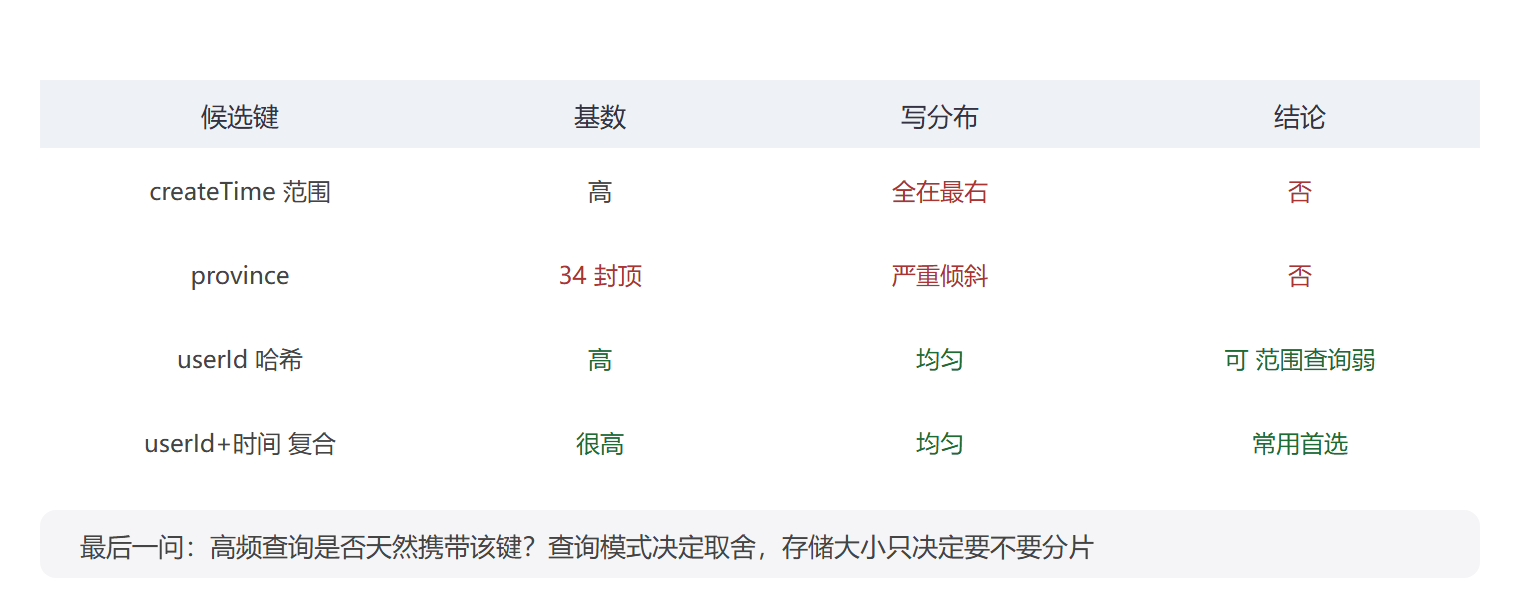
⚠️ 分片键不可修改是硬约束。上线前用评估矩阵过一遍候选键,比上线后 refine 或双写迁移便宜一个数量级。
事故复盘:34 个 chunk 的天花板
这次整改的决策过程值得完整记录。发现问题是在一次容量评审:广东分片的磁盘用了 61%,西藏分片 0.3%,sh.status() 里广东的 chunk 标着 jumbo——超过阈值却无法分裂,因为按省份范围键,一个省份就是一个最小切分单位,再切只能切进省份内部,而键里没有第二个字段可切。均衡器面对 jumbo chunk 只能放弃,分布从此冻结。
方案对比花了两天。方案一 refineCollectionShardKey 在线追加 orderId 后缀,不停写、不搬迁存量(新键只影响后续分裂与路由),是最便宜的路;它的局限是前缀仍是 province,广东的写入依旧全部落在广东分片——分布问题的根(写倾斜)没解,只解了"切不动"的问题。方案二新集合换 ownerId 哈希键、双写迁移数周,彻底根治但要付工程成本。团队的选择分了两期:先 refine 止住 jumbo 冻结,给按省份的查询保留定向路由;半年后新业务用新集合新键,旧集合随归档自然衰减。这个"两期走"的决策框架比任何一个"正确答案"都更值得抄——分片键事故的整改往往不是技术选型题,而是成本分期题。
// refine 后验证:广东省份内部可继续分裂 sh.status(); // 广东区间下出现多个子 chunk db.orders.getShardDistribution(); // 写倾斜仍在,但磁盘可控
哈希键与复合键的边界讨论
哈希键的适用面比直觉窄。它只支持等值路由,范围查询(时间区间、id 区间)一律广播;但它对"单调递增导致热点"免疫,且支持预分裂。复合键 {高基数字段, 单调字段} 范围键是另一条主路:等值打头字段定向、尾部单调字段保序,读写都能照顾,代价是打头字段的写分布必须均匀——若打头字段本身倾斜(如大客户 ID 占三成写入),热点只是缩小了一号。还有一个常被忽略的组合:{单调字段: "hashed", 其他字段: 1},把时间哈希化获得均匀写入,但彻底放弃时间范围查询的路由,只适合写入吞吐压倒一切的日志场景。
选键时用数据说话的具体做法:拉一周真实写入样本,按候选键统计各取值的写入占比与基数,任何单值占比超过百分之一的键都要警惕倾斜;再拉慢查询日志,统计高频查询携带的字段集合,候选键必须被这个集合包含。两张统计表对着看,选键从"经验判断"变成"数据对齐"。
选键工作坊:三个真实场景过一遍
用三个典型业务把四问走成肌肉记忆。场景一,订单库:高频查询是"按买家查订单列表"与"按订单号点查",写入按买家分布均匀。候选键 {buyerId: 1, createdAt: -1}——基数极高(买家百万级)、写均匀、两类查询里点查需改造为先查买家(订单号不带买家时只能广播),处理办法是订单文档里冗余买家号或查询侧先走索引服务。场景二,物联网时序:设备十万台、每秒共百万点写入,查询几乎都是"某设备某时间段"。{deviceId: "hashed"} 单字段哈希即可,设备基数远超 chunk 数,范围部分在分片内索引完成。场景三,多租户 SaaS:租户数千、头部租户占写入三成。任何以租户打头的键都会倾斜,务实解法是键里掺租户内高基数子字段(如 {tenantId: 1, userId: 1}),让大租户在内部继续分裂——refineCollectionShardKey 的追加后缀正是为这种后知后觉准备的。
// 场景三的落地:先建覆盖新键的索引,再在线细化 db.events.createIndex({ tenantId: 1, userId: 1 }); db.adminCommand({ refineCollectionShardKey: "saas.events", key: { tenantId: 1, userId: 1 } }); sh.status(); // 头部租户区间开始出现子 chunk
三个场景的共同结论:没有万能键,只有与查询日志对齐的键。上线前拿一周真实负载跑一遍 7.1 的分布统计命令,比任何评审会议都诚实。
本节要点回顾
- 选键四问:基数、写分布、查询携带、不变性;
- 低基数键封顶 chunk 数,均衡器无法救;
- refineCollectionShardKey 可在线追加后缀字段,是 5.0 后的首选补救;
- 先问查询模式再谈分片,"该不该分片"本身要先于"怎么分"。