11.2 Compass与工具链排障事故
11.2 Compass 与工具链排障事故
本节摘要:Compass 提供可视化查询、执行计划与索引分析;mongosh 负责脚本化操作;mongodump/mongorestore 做逻辑备份,mongostat/mongotop 做现场观测。本节从一次备份恢复演练失败的事故讲工具链分工与驱动使用要点。
事故档案 25:恢复不出来的备份
团队用 mongodump 每天备份,从未演练恢复。一次误删集合后才发现:备份目录挂的磁盘半年前就满了,最近的 dump 是五个月前的,且当时没开认证的旧密码早已轮换。恢复失败,只能靠 binlog 式的 oplog 前段勉强追回部分数据。教训只有一句:没演练过的备份等于没有备份。
工具链分工
# 逻辑备份与恢复(小中规模、可跨版本) mongodump --uri "mongodb://backupUser@mongo-a:27017" --db trade --gzip --archive mongorestore --uri "..." --archive --gzip --nsFrom "trade.*" --nsTo "trade_restore.*" # 数据导入导出(JSON/CSV,换格式用) mongoexport --db trade --collection orders --type json -o orders.json mongoimport --db trade --collection orders --file orders.json # 现场观测(第 10 章已介绍) mongostat 5 # 全局速率与队列 mongotop 5 # 集合级读写时间
| 工具 | 定位 | 注意 |
|---|---|---|
| mongodump/mongorestore | 逻辑备份 | 大集群耗时长,做恢复演练 |
| 文件系统快照 | 物理备份 | 大规模首选,配合 journal 一致点 |
| mongoexport/import | 格式转换 | 不保索引与全部类型,别当备份 |
| Compass | 可视化排查 | explain 可视化、索引建议 |
| mongosh | 脚本化运维 | 自动化的一切入口 |
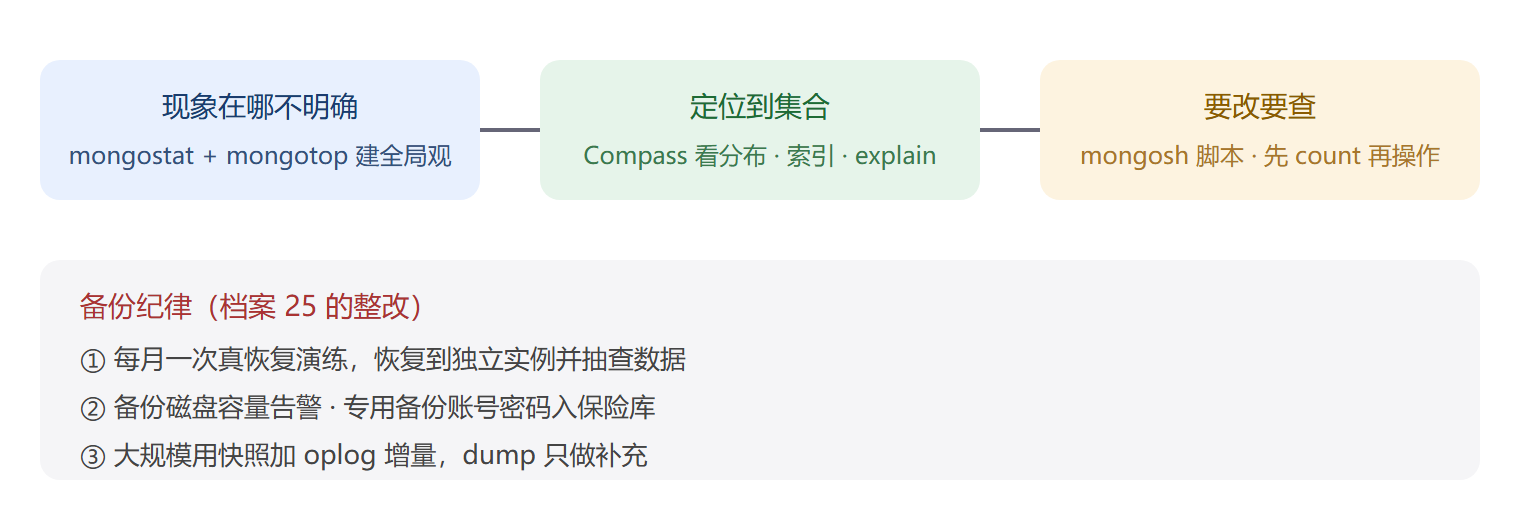
排障工具选用路线
驱动使用要点
- 连接串带
retryWrites=true(多数驱动默认开),故障转移期写入自动重试; - 连接池大小按应用并发设置,别默认值打满服务器连接数(第 10 章指标);
- Node.js 驱动注意事件循环阻塞时的连接心跳超时,Java 驱动注意 maxPoolSize 与超时拆分。
💡 每季度挑一个低峰时段做"恢复演练日":拿最近备份起一个实例,让业务同学抽查数据。这是检验整条工具链的唯一办法。
事故复盘:备份链路的三处断点
恢复失败的复盘把备份链路拆出了三处独立断点,每一处单看都是小事,叠起来就是数据丢失。断点一,磁盘写满:备份盘在半年前某天写满后,cron 任务每晚照跑、每晚失败、失败邮件进了没人看的公共邮箱——备份脚本没有成功校验,dump 命令退出码非零也没人拦。断点二,口令轮换:备份账号口令按第 9 章的季度策略轮换过一次,脚本里的旧口令从此失效,恰好被断点一掩盖,等磁盘扩容后脚本重新跑起来才发现。断点三,从未演练:没人验证过恢复的端到端时长,真到恢复那天才发现五个月前的 dump 与线上版本差了两个大版本,mongorestore 报了集合校验错误。
# 修复后的备份脚本关键三行:成功校验、失败告警、产物清点 mongodump --uri "$URI" --db trade --gzip --archive=/backup/day.dump test ${PIPESTATUS[0]} -eq 0 || alert "backup FAILED" # 退出码校验 mongorestore --archive=/backup/day.dump --gzip --nsFrom 'trade.*' \ --nsTo 'drill.*' --dryRun --quiet && echo OK # 每次dump后做干跑恢复校验
整改后的备份体系是三层:mongodump 逻辑备份保留七天做快速恢复,文件系统快照保留三十天做大灾难恢复,第 6 章的延迟隐藏节点兜误删类事故。每季度恢复演练日雷打不动,演练脚本就是上面那三行加上数据抽查——演练产物是一个可用的临时实例和业务同学签名的抽查记录。整条链路的核心原则一句话:备份系统的每个环节都要有自己的健康检查,因为它出问题时是静默的。
排障会话:三件套的实际配合
一次真实的索引排查展示三件工具怎么接力。接到"某接口偶发三秒慢":mongostat 先看全局,发现尖刺时刻 getMore 堆积,确认是特定查询不是资源问题;Compass 打开该集合,用 Explain 视图把嫌疑查询可视化,stage 图上一眼看到 SORT 阶段吞掉了两秒九;mongosh 落地修复,创建并入排序键的复合索引并在低峰执行。三件工具各干一段,没有一个环节靠猜。
// Compass 里看清楚的问题,最终在 mongosh 里固化成变更脚本 db.orders.createIndex({ buyerId: 1, createdAt: -1 }, { background: true }); // 修复验证:planSummary 从 SORT+IXSCAN 变为纯 IXSCAN db.orders.find({ buyerId: "u88" }).sort({ createdAt: -1 }) .explain().queryPlanner.winningPlan.input.stage; // IXSCAN
驱动侧再补一个高频坑:连接串里的 maxStalenessSeconds、connectTimeoutMS、serverSelectionTimeoutMS 三件套要成组显式设置,默认值在跨机房部署下经常不合适——serverSelectionTimeoutMS 默认 30 秒,意味着故障转移期间应用可能干等半分钟才报错,调到 5 秒配合驱动的自动重选,Failover 体验完全不同。
本节要点回顾
- dump 是逻辑备份,大规模换快照加增量,且必须演练恢复;
- export/import 是格式转换,不是备份;
- 排障三步走:mongostat 全局观 → Compass 定位 → mongosh 动手;
- 驱动开 retryWrites,连接池显式规划。