2.2 全局块与事件块:进程模型的旋钮
2.2 全局块与事件块:进程模型的旋钮
本节摘要:全局块与事件块直接决定 Nginx 的进程形态和连接容量——worker 数量、CPU 亲和、连接上限、accept 行为。参数不多,但每个都对应整机级影响,本节逐个给出选值依据。
全局块三件事
# 1. worker 数量:与 CPU 核数对齐 worker_processes auto; worker_cpu_affinity auto; # 2. 错误日志:级别决定细节程度 error_log /var/log/nginx/error.log warn; # 3. 进程身份:master 用 root 绑端口,worker 降权干活 user nginx;
worker 数量的判断依据:worker 是 CPU 密集的事件循环,多于核数只会增加切换;少于核数则浪费 CPU。auto 即取核数,8 核机器上会看到 1 个 master 加 8 个 worker。
error_log 级别从低到高是 debug、info、notice、warn、error、crit。生产默认 warn 合理;排查问题时临时降到 debug 能看到每请求的处理路径,但日志量会放大两三个数量级,用完必须改回去——我曾见过一台开了两周 debug 的机器,错误日志 40GB,磁盘告警先于业务告警到来。
事件块:容量与惊群
events { use epoll; # Linux 默认,通常不用写 worker_connections 40960; # 每 worker 连接上限 multi_accept on; # 一次唤醒尽量多 accept accept_mutex off; # 新版本默认关闭 }
三个参数的线上含义:
| 参数 | 作用 | 选值思路 |
|---|---|---|
| worker_connections | 每 worker 可持有连接数 | 目标并发 ÷ worker 数 ÷ 2(代理占双连接),再留余量 |
| multi_accept | 唤醒时尽量多收新连接 | 突发流量场景开启,匀速流量差别不大 |
| accept_mutex | worker 轮流抢 accept 锁 | 内核已用 SO_REUSEPORT 缓解惊群,默认即可 |
另外两个常被遗忘的联动项:系统级文件描述符上限(worker_rlimit_nofile 与 ulimit)必须大于 worker_connections,否则启动报错或运行中耗尽;作为代理时出站端口范围决定向后端的最大并发(见 1.3 的内核参数)。
一次容量参数的计算演练
目标:承载 30000 并发代理连接,8 核机器。
worker 数 = 8 每 worker 需承载 = 30000 / 8 = 3750 个客户端连接 代理场景双连接 → 每 worker 至少 7500 连接 取整留余 → worker_connections 16384 worker_rlimit_nofile 需 > 16384,设 65535
图:容量参数联动关系
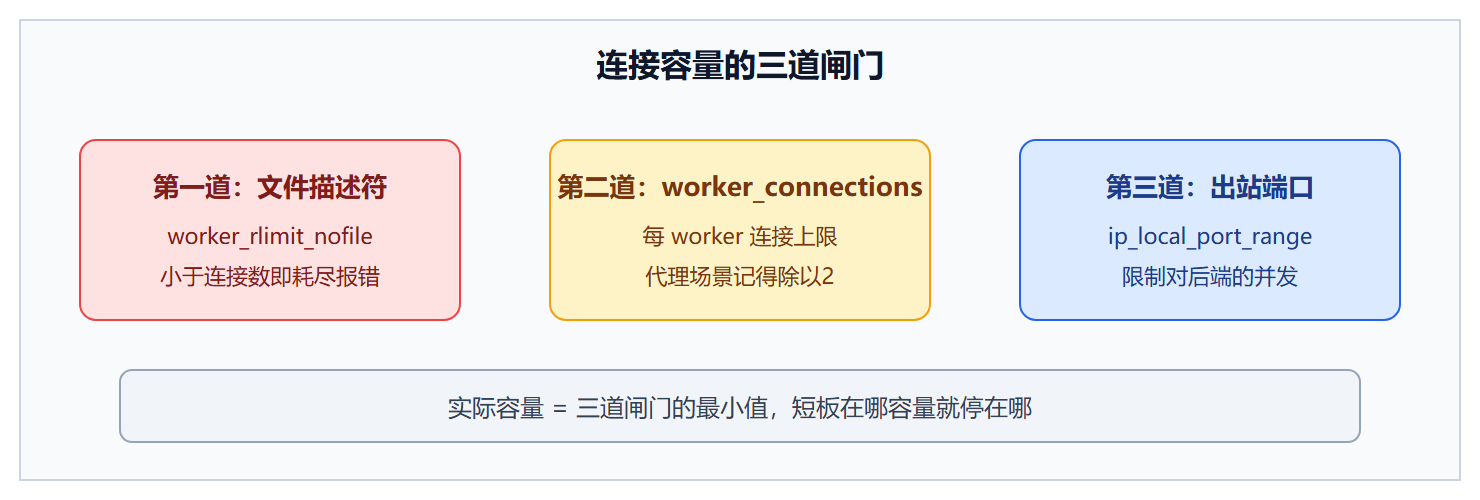
worker_rlimit_nofile 与系统级限制的三层关系
文件描述符上限有三道闸,任何一道最小都成为真实容量:
系统级 fs.file-max → 整机所有进程合计 用户级(systemd 的 LimitNOFILE 或 pam 的限制)→ 单进程 Nginx worker_rlimit_nofile → worker 自我声明,不能超过上一道
常见的翻车方式:worker_rlimit_nofile 设了 65535,systemd 服务单元里 LimitNOFILE 还是默认 1024(老版本)或 524288 之外的历史低值,worker 启动后实际拿到的上限以低者为准,流量上来直接报 too many open files。排查命令一条:
# 看 master 实际生效的描述符上限 cat /proc/$(pgrep -o nginx)/limits | grep "open files"
修法是 systemctl edit nginx 里加 LimitNOFILE=65535 后重启——注意这一项改动不能 reload 生效,属于少数必须 restart 的参数,安排在维护窗口做。
CPU 亲和性的实际收益边界
worker_cpu_affinity auto 让每个 worker 绑定一个核,减少缓存失效与迁移开销。但它的收益有前提:机器主要跑 Nginx。若 Nginx 与数据库、Java 应用混部,绑核反而和邻居抢同一个核。云主机还要额外小心——虚机的 vCPU 本身就在宿主机上漂移,绑核收益接近零。经验值:物理机独享 Nginx 时开 auto 可拿百分之几的吞吐提升;其余场景保持默认,把精力留给容量参数。
最后交代一个哲学层面的取舍:全局块与事件块的参数是"装机时定、平时不动"的一类。它们影响的是整机的进程形态与容量上限,改动牵一发动全身,理应经过压测验证并纳入变更管理,而不是值班时顺手调。把这两块参数当作基础设施规格书的一部分——和 CPU 核数、内存大小并列写进机器交付清单——是区分"配置使用者"与"系统 owner"的分界线。日常运维九成的调整发生在 http 层以下,全局块的每次变动都应该有压测报告背书。
自测一题收束本节:8 核机器、目标 4 万并发代理连接,要求给出全套容量参数并指出最容易遗漏的一项。推导过程——worker 数 8;每 worker 客户端连接 5000,代理双连接折算 worker_connections 至少 10000,取 16384 留余量;worker_rlimit_nofile 高于连接数取 65535,同时确认 systemd 的 LimitNOFILE 不低于此值;系统级 somaxconn 提到 65535,listen 行加 backlog。最容易遗漏的是最后一项的联动:任何一道闸门没跟上,其余参数全部白设,而容量瓶颈永远藏在三道闸门里最低的那道后面。答得出全部五步,本节的目标就达成了。
本节要点回顾
- worker 数等于核数,
auto即可,不必手工干预; - debug 日志只在排查时开,用完立刻回 warn;
- worker_connections 是每 worker 上限,代理场景按双连接折算;
- 三道闸门取最小值:描述符、连接数、出站端口共同决定真实容量。