1.1 什么是Node.js:单线程凭什么高并发
1.1 什么是 Node.js:单线程凭什么高并发
本节摘要:Node.js 是一个基于 V8 引擎与 libuv 事件循环的 JavaScript 运行时,用「单线程 + 非阻塞 I/O」模型处理高并发网络请求。本节讲清它的分层构成、与传统线程模型的对比、适用与不适用的场景,并完成环境搭建与第一个 HTTP 服务器的实操。
动手目标
- 能画出 Node 运行时的四层结构并说明各层职责
- 能对比「每请求一线程」与「单线程事件循环」的内存与上下文切换成本
- 能安装 Node 并用版本管理工具切换版本
- 能写出第一个 HTTP 服务器并理解回调在这里扮演的角色
一、先破一个误解
很多人第一反应是:「Node.js 就是跑在服务器上的浏览器 JavaScript。」这个理解差了一层。浏览器里的 JavaScript 是一门被沙箱圈起来的语言,摸不到文件系统和网络底层;而 Node.js 做的事情是把 V8 引擎从浏览器里搬出来,再往它身上接一整套操作系统级的能力——读写文件、监听端口、创建子进程、加密解密。所以更准确的说法是:Node.js 是一个让 JavaScript 获得操作系统接口的运行时。
它的构成可以拆成四块:
- V8 引擎:负责把 JavaScript 编译成机器码并执行,是「快」的第一来源。
- libuv:一个 C 语言写的事件循环库,负责调度异步 I/O、定时器与回调队列,是「高并发」的真正来源,也是本书的主角。
- 核心模块:fs、http、events 这些由 Node 官方维护的模块,大部分用 JavaScript 包装,底层调用 libuv。
- npm 生态:全球最大的软件包仓库,这是 Node 能在服务端站稳脚跟的生态护城河。
两种并发模型的对决
传统服务器(比如早期 Apache 的默认配置)采用「每个请求分配一个线程」的模型。一百个并发请求就是一百个线程,每个线程默认预留约 1MB 栈空间,光内存就要一百多 MB;线程之间的上下文切换还要消耗 CPU。而 Node 只有一条主线程处理所有请求逻辑,I/O 操作交给操作系统内核与 libuv 线程池,完成后把回调「排队」送回主线程。
线程模型对比:同一台机器上的两种活法
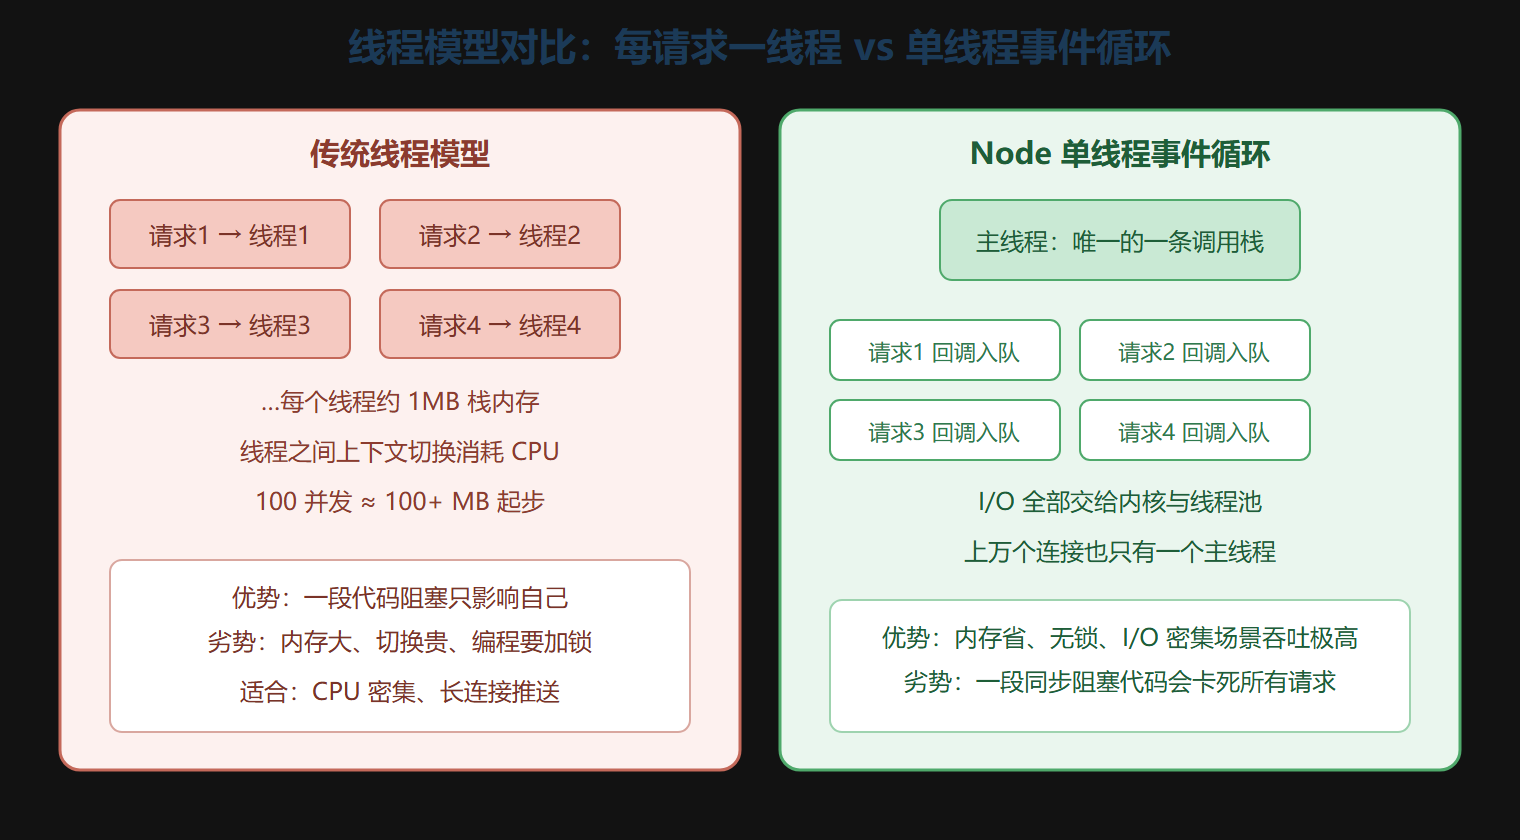
这张图也交代了 Node 的软肋:因为只有一条主线程,任何一段同步的重计算都会让全部请求排队。第 7 章讲的 cluster 与 Worker Threads 就是给这个软肋打的补丁。
二、把环境搭起来
安装 Node 的方式很多,我最推荐用版本管理器:Node 大版本每年两次迭代,项目多了之后你一定需要在同一台机器上切换版本。
装好后验证:
node -v npm -v
两个命令分别输出版本号即可。接着花两分钟认识 REPL——在终端里直接敲 node 回车,进入交互式环境,可以随手验证表达式:
$ node > 1 + 1 2 > [1,2,3].map(x => x * 2) [ 2, 4, 6 ] > .exit
REPL 是贯穿本书的「草稿纸」:后面讲事件循环执行顺序时,所有实验都可以先在这里跑。
三、第一个 HTTP 服务器
七行代码,一个能用的 Web 服务器:
const http = require('http'); const server = http.createServer((req, res) => { res.writeHead(200, { 'Content-Type': 'text/plain; charset=utf-8' }); res.end('你好,Node'); }); server.listen(3000, () => { console.log('服务器已启动,端口 3000'); });
运行后浏览器访问本机 3000 端口就能看到问候。注意这段代码里没有「启动线程」的动作——createServer 只是注册了一个回调:每当有请求进来,事件循环就调用它一次。一千个请求同时到达?没关系,它们只是排队等着同一个回调被调用一千次,而回调内部的 res.end 之类的 I/O 又是非阻塞的。
这里已经埋下了全书的伏笔:回调函数是 Node 与事件循环之间唯一的接口。它为什么会长成这样、怎么避免越写越乱,就是第 2 章的主题。
⚠️ 常见坑:在回调里写同步的重计算(比如 JSON.parse 一个 50MB 的文件)会让所有并发请求一起卡住。从第一天起就要建立「主线程寸土寸金」的意识。
本节要点回顾
- Node 的定义:V8 + libuv + 核心模块 + npm 生态组成的 JavaScript 服务端运行时,不是「浏览器 JS 的服务端版」那么简单。
- 并发来源:高并发能力来自 libuv 事件循环与操作系统非阻塞 I/O,而不是多线程。
- 模型取舍:I/O 密集(API 网关、实时推送、代理)是主战场;CPU 密集(视频转码、大文件压缩)要用 Worker Threads 补课。
- 版本管理:用版本管理器安装 Node,别用单一安装包,多项目共存时你会感谢这个决定。
- 回调即接口:第一个服务器已经展示了 Node 的基本编程模型——注册回调,事件循环负责调用。