3.1 fs文件系统:三套API与目录遍历实战
3.1 fs 文件系统:三套 API 与目录遍历实战
本节摘要:fs 模块提供同步、异步回调、Promise 三套并行 API 访问文件系统。本节讲清三套 API 的适用边界、stat 与读写的常用组合、递归遍历目录的实战实现,并用一个内存对比实验说明为什么大文件读取必须交给 Stream——事件循环视角下,fs 的每个设计都是「别把主线程绑在磁盘上」。
动手目标
- 能为给定场景选择正确的 fs API 形态并说明理由
- 能用 stat 区分文件与目录、读取元信息
- 能实现一个可复用的递归目录遍历
- 能量化对比 readFile 与 createReadStream 的内存差异
一、三套 API,三个场合
同一个 readFile,fs 给了三种形态:
const fs = require('fs'); // 形态一:同步——阻塞事件循环,直到磁盘返回 const data1 = fs.readFileSync('配置.json', 'utf8'); // 形态二:异步回调——发起后立即返回,完成后回调进 poll 阶段 fs.readFile('配置.json', 'utf8', (err, data2) => { if (err) throw err; }); // 形态三:Promise——回调的现代化包装,可配合 await const fsp = fs.promises; async function main() { const data3 = await fsp.readFile('配置.json', 'utf8'); }
选型原则很干脆:服务进程的热路径禁用同步 API——readFileSync 会把事件循环按在磁盘上,期间所有请求冻结。同步形态只属于两种场合:脚手架脚本(跑完就退)和进程启动期的一次性配置加载(此时还没有请求需要服务)。业务代码统一走 Promise 形态。
⚠️ 常见坑:有人为了让 async 函数「等」文件读完,在函数里用 readFileSync 包一层 async——同步代码不会因为外层是 async 就变成异步,事件循环照样被卡住。
二、stat:先问再动
读写之前常常要先「问一句」:这是文件还是目录?多大?什么时候改的?stat 负责回答:
const fsp = require('fs').promises; async function probe(p) { const st = await fsp.stat(p); console.log('是目录:', st.isDirectory()); console.log('是文件:', st.isFile()); console.log('大小:', st.size, '字节'); console.log('最后修改:', st.mtime.toISOString()); return st; }
一个高频组合是「文件存在则读,不存在则创建」。注意 Node 官方早已不建议用 exists 判断——检查与打开之间存在竞态窗口,正确做法是直接打开并用 errno 区分 ENOENT(不存在)与其它错误。
三、实战:递归遍历目录
目标:给定根目录,收集所有扩展名为 js 的文件路径。用 Promise 形态实现:
const fsp = require('fs').promises; const path = require('path'); async function collectJs(dir, out = []) { const entries = await fsp.readdir(dir, { withFileTypes: true }); for (const e of entries) { const full = path.join(dir, e.name); if (e.isDirectory()) { if (e.name === 'node_modules') continue; // 跳过依赖目录 await collectJs(full, out); } else if (e.isFile() && e.name.endsWith('.js')) { out.push(full); } } return out; } collectJs('.').then(files => console.log(`共 ${files.length} 个 js 文件`));
withFileTypes: true 让 readdir 直接返回带类型标记的目录项,省掉了每个条目一次额外的 stat——在文件极多的目录里这是两倍的 I/O 差距。另外注意这里的 await 是必要的:子目录遍历必须完成后结果才有意义,属于真正的依赖关系(第 2 章的教训在这里就派上了用场)。
流式读取管道:数据像水一样分段流过
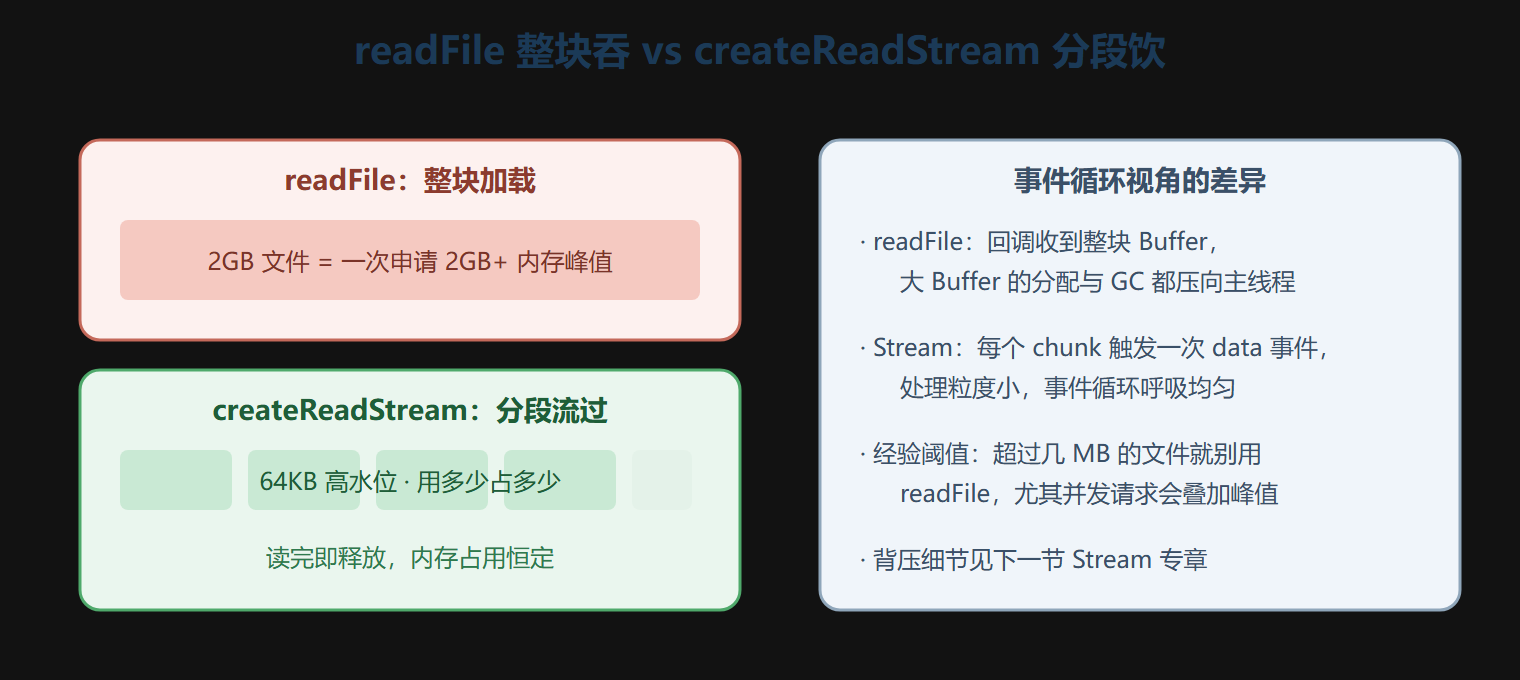
四、一个内存实验
用两个脚本分别读取同一个 300MB 的日志文件并统计行数,用系统工具观察进程内存:
// 方案A:整块读 const fs = require('fs'); fs.readFile('big.log', (err, buf) => { console.log('行数', buf.toString().split('\n').length); }); // 方案B:流式读 const fs = require('fs'); const rl = require('readline'); let n = 0; rl.createInterface({ input: fs.createReadStream('big.log') }) .on('line', () => n++) .on('close', () => console.log('行数', n));
方案 A 的内存峰值在 300MB 之上再翻倍(toString 又生成一份字符串);方案 B 稳定在几十 MB。更关键的是若把三个请求的并发考虑进来,方案 A 是 3 倍峰值叠加,方案 B 依然恒定——流式处理对并发几乎免疫,这是它在服务端的价值核心。
权限与原子性两个补充话题
写文件时有两个容易踩的边界。其一,权限:进程对目标路径的读写权限取决于运行用户,容器化部署时常见「本地好好的、上容器就 EACCES」,根因多是容器用户与目录属主不匹配,读 errno 里的权限错误码比反复试要快得多。其二,原子性:直接 writeFile 覆盖目标文件,写到一半进程崩掉就会留下半个残文件。需要原子落盘时,惯用做法是先写临时文件再改名——改名在文件系统层面是原子操作,读方要么看到旧全文、要么看到新全文,永远看不到半成品。配置文件、索引文件的更新都该走这条路。
临时文件与目录的清理习惯
再说一个运维味的细节:程序生成的临时文件要有编号与生命周期。惯用做法是建专用临时目录、文件名带进程号与时间戳、启动时清理上一轮遗留。不做这件事的服务器,几个月后磁盘就会被无名临时文件悄悄填满,而那时的你早已不记得它们是谁写的。
本节要点回顾
- 三套 API 各有辖区:热路径只许异步/Promise;同步留给启动期与脚本。
- stat 先行:类型判断与元信息靠 stat,exists 已废弃,竞态要用 errno 处理。
- withFileTypes:目录遍历省一半 I/O 的开关。
- 大文件必流式:readFile 的内存峰值随文件与并发线性放大,Stream 恒定。
- 事件循环视角:fs 的双轨设计目标是让磁盘时间与主线程时间不重叠。