3.4 Buffer与Stream:背压模型详解
3.4 Buffer 与 Stream:背压模型详解
本节摘要:Buffer 是 Node 处理二进制的定长容器,Stream 是数据分段流动的抽象,背压则是读写速度不匹配时的自动调节机制。本节讲 Buffer 的基本操作与编码陷阱、四种流的分工,然后用「读快写慢」的实验复现内存膨胀,拆解 pipe 内部的背压实现,最后手写一个 Transform 流完成逐行处理。
动手目标
- 能完成 Buffer 的创建、切片、拼接与编码转换,避开 UTF-8 切块陷阱
- 能说出四种流(Readable/Writable/Duplex/Transform)的分工
- 能复现并解释「读快写慢」的内存膨胀,读懂 pipe 的背压源码
- 能手写 Transform 流做逐行/逐块的数据加工
一、Buffer:二进制的集装箱
JavaScript 原生只有字符串,而网络与文件的世界是字节。Buffer 就是一段定长的原始内存,用来装字节:
const buf = Buffer.from('你好', 'utf8'); console.log(buf.length); // 6:一个汉字 3 字节 console.log(buf.toString('hex'));// e4bda0e5a5bd const part = buf.slice(0, 3); // 切片:不复制内存,与原 Buffer 共享 console.log(part.toString()); // 你 const merged = Buffer.concat([buf, Buffer.from('!')]); console.log(merged.toString()); // 你好!
最容易翻车的地方是 UTF-8 多字节字符被切块。流式读取时一个 data 事件给你 64KB,恰好把某个三字节汉字从中间劈开,直接 toString 就会出乱码。正确姿势是用 StringDecoder,它会把不完整的字节留到下一块拼齐:
const { StringDecoder } = require('string_decoder'); const decoder = new StringDecoder('utf8'); stream.on('data', chunk => { const text = decoder.write(chunk); // 不完整的多字节序列会被扣住 if (text) handle(text); });
二、四种流的分工
Stream 家族四个成员,职责清晰:
| 类型 | 方向 | 典型代表 | 典型用途 |
|---|---|---|---|
| Readable | 只读 | fs.createReadStream | 从磁盘/网络取数据 |
| Writable | 只写 | http response、fs.createWriteStream | 数据的去处 |
| Duplex | 双向独立 | TCP socket | 读写互不干扰 |
| Transform | 读写转换 | zlib 压缩流 | 边流边加工 |
管道把它们串成流水线,一行代码完成「解压 → 逐行 → 重新压缩」:
const fs = require('fs'); const zlib = require('zlib'); const rl = require('readline'); fs.createReadStream('app.log.gz') .pipe(zlib.createGunzip()) // 解压 .pipe(rl.createInterface()) // 逐行 .on('line', line => { /* 过滤 */ }) .pipe(fs.createWriteStream('filtered.gz')); // 示意:重新写出
三、背压:读快写慢的自动调节
现在到本节的核心问题。磁盘每秒能吐几百 MB,而一个慢客户端的下载带宽可能只有 2MB/s。如果读端只管猛灌,写端来不及消费的数据去哪了?全堆在内存里。
// 反面教材:手动搬运,没有背压 const fs = require('fs'); const rs = fs.createReadStream('huge.iso'); const ws = fs.createWriteStream('copy.iso'); rs.on('data', chunk => { ws.write(chunk); // 写不过来时数据在 ws 的内部缓冲里无限堆积 });
ws.write 返回 false 表示写缓冲已超过高水位(内部缓冲约 16 个 chunk)。正确做法:
rs.on('data', chunk => { const ok = ws.write(chunk); if (!ok) { // 写端撑不住了 rs.pause(); // 暂停读 ws.once('drain', () => rs.resume()); // 缓冲排空再恢复 } }); rs.on('end', () => ws.end());
这就是背压的完整闭环。pipe 内部做的就是这段逻辑,所以日常直接 pipe 就自带背压。
Stream 背压模型:一个自适应的水闸
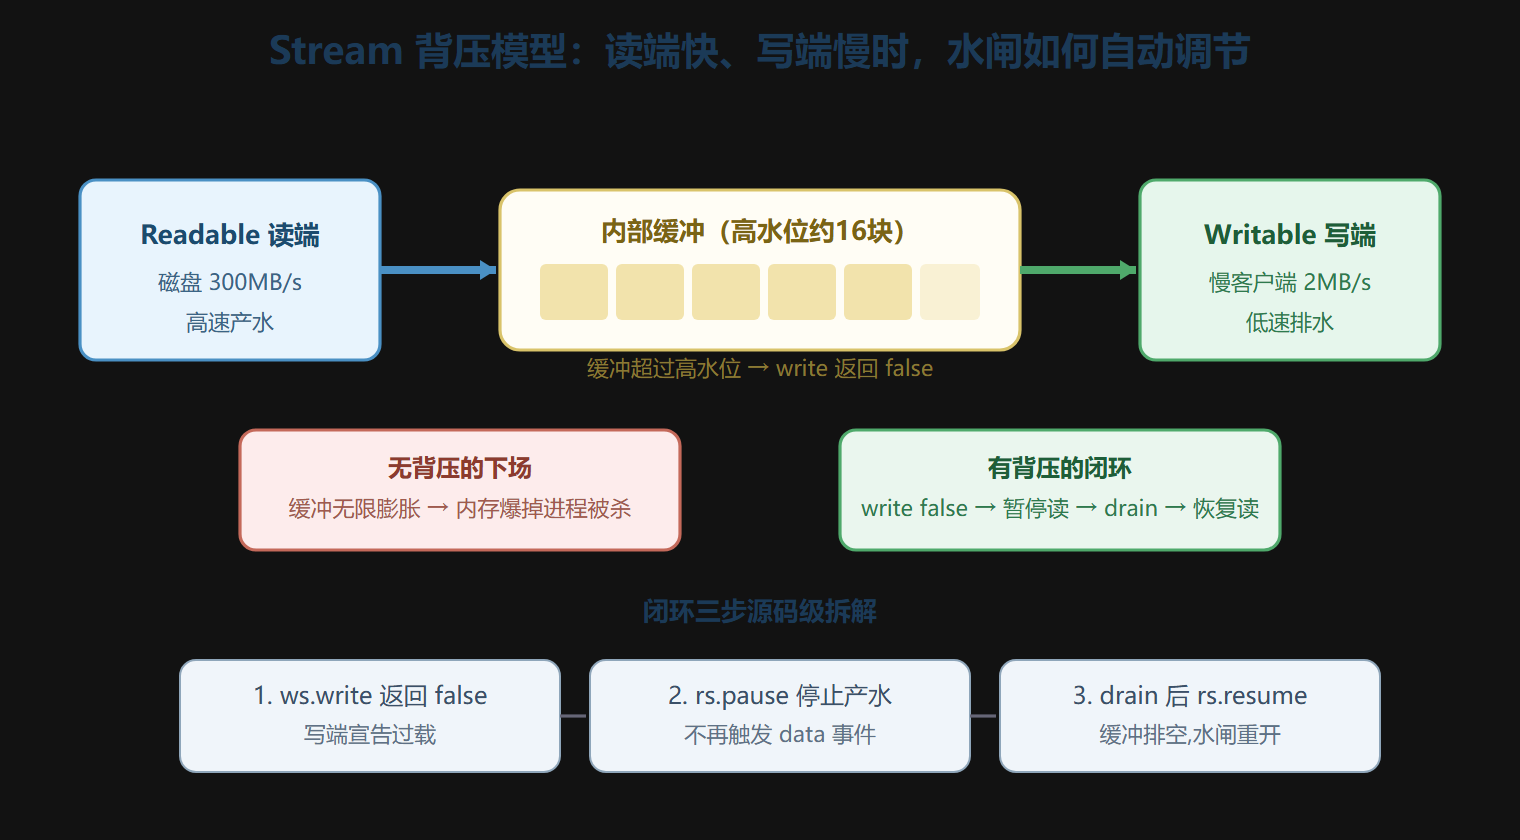
背压不只是省内存:它把流量整形成「消费得动」的节奏,等价于网络传输里的滑动窗口思想——接收方反过来控制发送方,防止被灌垮。
四、手写 Transform 流
Transform 是流家族里最有工程味的一员:读进来的每块数据经 _transform 加工后写出。做一个给日志行打时间戳的流:
const { Transform } = require('stream'); class Timestamp extends Transform { constructor() { super({ readableObjectMode: false }); this.remainder = ''; } _transform(chunk, enc, cb) { const text = this.remainder + chunk.toString(); const lines = text.split('\n'); this.remainder = lines.pop(); // 最后一行可能不完整,留到下一块 for (const line of lines) { if (line.trim()) { this.push(new Date().toISOString() + ' ' + line + '\n'); } } cb(); } _flush(cb) { // 流结束时处理剩余 if (this.remainder.trim()) { this.push(new Date().toISOString() + ' ' + this.remainder + '\n'); } cb(); } } process.stdin.pipe(new Timestamp()).pipe(process.stdout);
注意它同时解决了两个前面埋下的问题:跨块的字符完整性(remainder 缓冲)与加工数据的可组合性(一个流类,任意管道里即插即用)。zlib 的压缩流、加密流,本质都是这个结构。
对象模式与管道组合
流还有一扇常被忽略的门:对象模式。让流里流动的不再是字节而是任意 JavaScript 对象,每一条是一个解析后的记录——数据库驱动的查询结果、日志分析管线的结构化事件,都靠它表达。对象模式与普通流可以经 Transform 桥接:字节流进、对象流出,解析逻辑封装在一个类里,任意复用。写数据处理服务时,先问自己「这能不能做成一条管道」,能做成管道的,内存稳定、可组合、可测试三样全占。
一个判断练习
试着回答这个问题:日志收集服务每分钟把上百个服务的日志汇总压缩后写入对象存储,该用整块读还是管道流?答案显然是后者,但理由要能说全:文件总量持续增长决定内存不可控,上游数量多决定并发叠加,对象存储的网络速度与磁盘速度差距决定背压必然发生——三条理由分别对应本节的三个知识点,能说全才算把背压模型吃透。
本节要点回顾
- Buffer 是字节容器:定长、可切片共享内存;字符串转换警惕多字节被劈开,用 StringDecoder 兜底。
- 四种流分工:Readable 产、Writable 消、Duplex 双向、Transform 边流边加工。
- 背压三步闭环:write 返回 false → pause → drain 后 resume;pipe 已内置,手写搬运别忘补。
- 内存免疫并发:背压让流式服务的内存占用与并发数基本无关,这是服务端大文件的唯一正解。
- Transform 惯例:remainder + split + push + flush,逐行处理的标准骨架。