1.1 为什么文本处理偏爱 Perl
1.1 为什么文本处理偏爱 Perl
Perl 是一门为处理文本而生的脚本语言:内建正则引擎、逐行读文件是默认行为、哈希是一等公民。判断一个活该不该用 Perl,看它的输入输出是不是"一团非结构化文本进、结构化结论出"。
一段历史,解释它的脾气
1987 年 Larry Wall 写 Perl 时,手里的问题是报表生成和系统管理:读日志、拼字符串、生成摘要。这门语言的所有设计决定都朝着这个方向倾斜——正则不用导入库就能用,while (<>) 一行代码完成"打开文件、逐行读取、自动关闭",%count 这样的哈希天生适合"按 key 聚合"。后来 CPAN 上沉淀了两万多个模块,文本方向尤其厚实。
理解了出身,就理解了它的适用边界:
| 场景 | 适合度 | 原因 |
|---|---|---|
| 日志分析、报表生成 | 很合适 | 正则 + 哈希 + 逐行读是母语 |
| 配置文件批量改写 | 很合适 | 单文件替换几分钟写完 |
| 生物信息序列处理 | 合适 | 社区有成熟模块与惯例 |
| 高并发 Web 服务 | 不合适 | 有更现代的生态 |
| 手机 App | 不合适 | 不是它的战场 |
一行代码的冲击
统计一份日志里 404 出现的次数,Perl 只需要一行:
perl -ne '$c++ if / 404 /; END { print "404 共 $c 次\n" }' access.log
-n 让 Perl 自动逐行读文件,/ 404 / 是内建正则,END 块在文件读完时收尾。同样的逻辑用编译型语言写,光打开文件和处理异常就要十几行。这就是"为文本而生"的具体含义。
它和 sed、awk、Python 什么关系
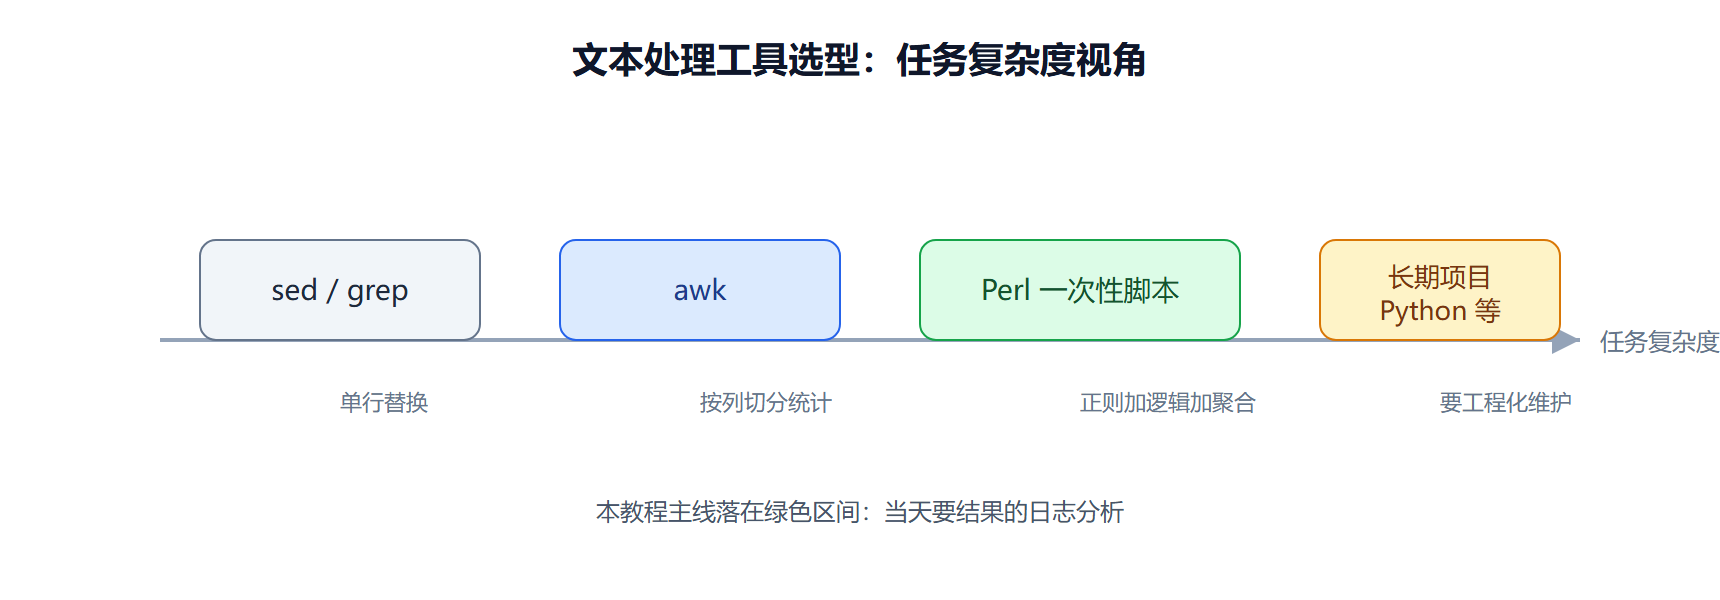
命令行老手会问:这些事 sed 和 awk 也能干。没错,简单替换确实该交给 sed。但任务一旦长出逻辑——多条件分支、跨行状态、结果要排序输出——awk 的语法就开始吃力,而 Perl 等于"awk 的语法舒适区 + 完整的通用语言能力"。Python 反过来:通用能力更强,但逐行正则处理这种事要多敲一些字。我的经验法则:一次性、当天要结果的文本活,Perl;要长期维护、团队协作的系统,再考虑别的。
动手体会:三个一行式
光看对比表还不够,亲手敲三个一行式,体感会立刻建立。假设手头有一份 access.log,依次回答三个递进的问题。
第一个问题:这份日志里 POST 请求有多少条?
perl -ne '$c++ if /"POST/; END { print "POST 共 $c 条\n" }' access.log
第二个问题:请求量最大的前五个小时是哪几个?把统计对象从"是否匹配"升级成"提取分组":
perl -nae '$c{$F[3]}=~s/:.*//r; $h{ ## 概念辨析:脚本语言、解释器与运行时 讨论"Perl 过不过时"时,三个常被搅在一起的词需要分开。脚本语言指书写风格——短、直、面向当下问题;解释器指执行方式——perl 这个程序读源码直接执行,不产出独立的可执行文件;运行时指程序跑起来时背后那整套标准库与环境。Perl 三者兼备,但"脚本"不等于"玩具":CPAN 上稳定运行二十年的解析模块比比皆是,差别只在于写的人有没有按工程标准对待它。评价一门工具,看的是它解决的问题域是否仍然存在。日志、配置、报表、数据清洗,这些文本脏活在可预见的年头里不会消失,Perl 的工位就一直在。 最后给一个可操作的选择流程,拿来就能用:第一步,把任务写成一句话,主语是输入、宾语是输出;第二步,若宾语是"排序的数字/表格/排名",进入候选;第三步,预估中间结果能否装进内存,能装则 Perl 一票通过;第四步,检查团队维护能力,有至少一人能读懂 Perl 即开工。四步走完通常不超过十分钟,却足以避免一大类"选型靠感觉"造成的返工。 还有一个高频疑问值得正面回答:Perl 6 去哪了。2019 年起 Perl 6 更名 Raku,是另一门有亲缘关系的独立语言,语法与 Perl 5 不兼容。市面上"Perl 已死"的论调有一半是把两者的分家误读成了废黜。本教程讲的是 Perl 5——那个仍在无数生产环境里跑日志与报表的版本,Raku 不在讨论范围。 版本内部也有生命周期:每个 5.x 系列维护数年,5.36 起默认开启很多新特性。选版本的原则就一条——跟操作系统的包管理器走,别手工编译冷门版本,除非确有理由。 ## 本节要点回顾 }++ if /"GET|"POST/' access.log
这一行写得有点急智,可读性一般,先跑起来再看:它演示了一行式的典型形态——用最短字符数换最快出结果。真正可维护的写法要等学完第 4 章正则再回头重写。第三个问题:把所有 500 错误的请求路径抽出来去重:
perl -ne 'print "$1\n" if /"\w+ (\S+)[^\"]*" 500/' access.log | sort -u
第三个例子暴露了一行式的真实用法:Perl 一行式经常和 sort、uniq 这些 shell 工具混编,各干各的强项。这也是工坊的第一条操作守则——别追求纯 Perl,追求最快下班。
什么时候该放弃 Perl
诚实地列出放弃信号,比吹捧优势更有用。出现以下任一情况,请考虑换工具:数据量已经大到单机内存装不下中间结果(Perl 哈希全部驻留内存);需要多人长期维护且团队没人写过 Perl;任务核心是数值计算而不是文本搬运;要和现代 Web 框架深度集成。文本工坊不揽瓷器活,识别自己的边界本身就是工程能力。
另一个常被忽略的坚持信号:历史遗留。接手一套运行了十年的 Perl 报表系统,读懂它比重写它便宜得多。这类系统里沉淀的正则和字段知识往往只存在于代码里,文档早就失传了。此时学 Perl 的回报不是写出新东西,而是安全地改动旧东西——第 7 章的测试章节正是为这种场景准备的。
本节要点回顾
- Perl 1987 年为报表与系统管理而生,正则、逐行读取、哈希是内建能力
- 判断标准:非结构化文本进、结构化结论出的活,是 Perl 的主场
- 一行式能力:
perl -ne加正则就能完成日常小统计 - 与近邻分工:单行替换给 sed,按列统计给 awk,带逻辑的文本流水线给 Perl,长期工程另选
- 不神化:高并发服务、客户端开发不是它的场景,选型时坦率承认