1.3 第一个脚本:统计日志行数
1.3 第一个脚本:统计日志行数
本节产出一个可直接使用的日志概览脚本:统计总行数、总字节与最大单行长度,并在过程中认识 Perl 脚本的基本骨架——shebang、变量、逐行读取、格式化输出。
任务定义
手头一份 access.log,先回答最基础的问题:多大、多少行、最长的行长什么样。别小看这一步,"最长行"经常暴露异常请求——比如塞满了垃圾参数的攻击探测。
脚本骨架
#!/usr/bin/perl use strict; use warnings; my $file = shift || 'access.log'; my $lines = 0; my $bytes = 0; my $max = 0; my $max_ln = ''; open my $fh, '<', $file or die "无法打开 $file: $!"; while (my $line = <$fh>) { $lines++; $bytes += length($line); if (length($line) > $max) { $max = length($line); $max_ln = $line; } } close $fh; printf "文件: %s\n行数: %d\n字节: %d\n最长行: %d 字节\n", $file, $lines, $bytes, $max; print "最长行内容: ", substr($max_ln, 0, 80), "...\n";
逐块拆开看:
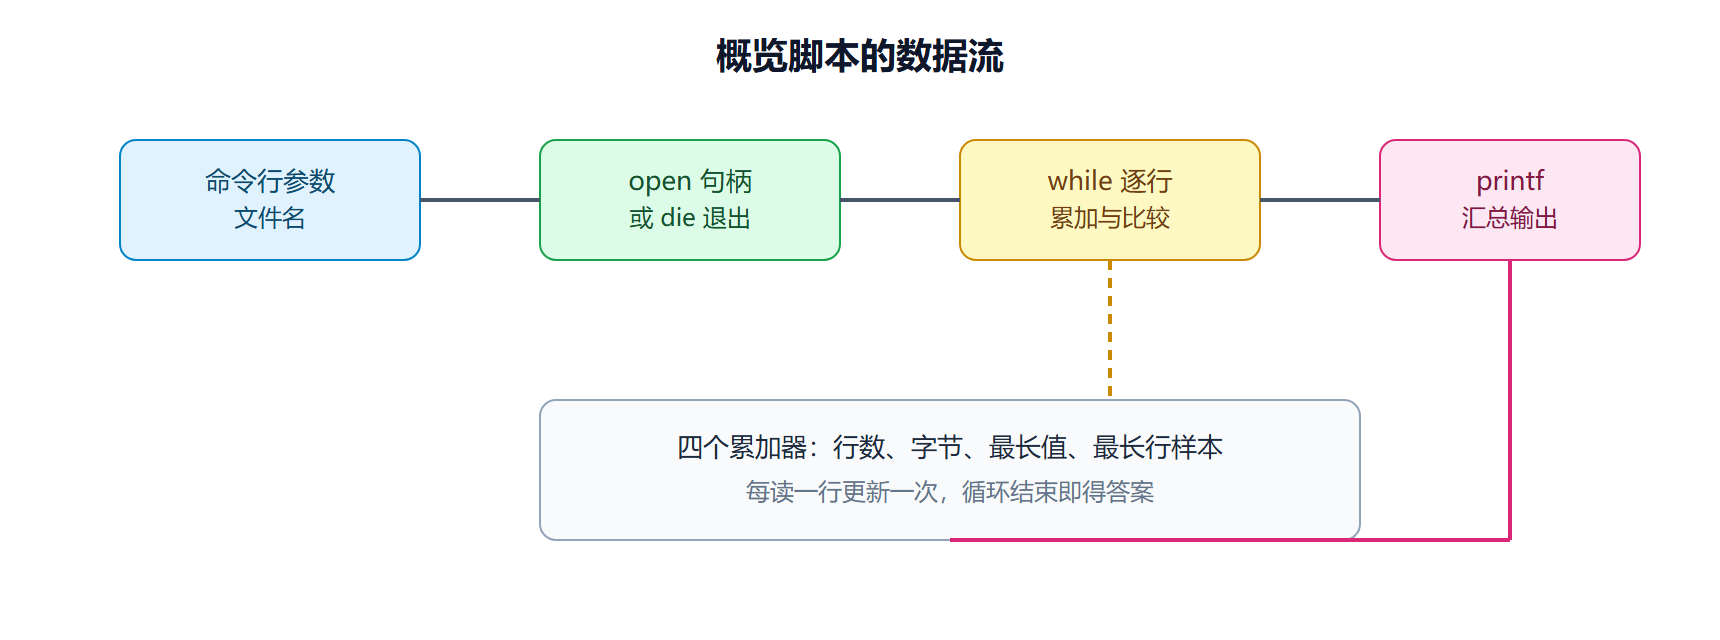
#!/usr/bin/perl是 shebang,类 Unix 系统靠它知道用什么解释器执行;Windows 上可以省略use strict; use warnings;强制声明变量、打开警告,这两行是所有脚本的标配,没有它们的小错误会静默溜走shift从命令行参数取文件名,|| 'access.log'给默认值open ... or die ...打开失败立即报错退出,$!是系统给出的原因while (my $line = <$fh>)逐行读取,<$fh>每次吐出一行printf做格式化输出,和 C 语言的 printf 同源
数据在脚本里的流动
顺手认识键盘输入
同一套读入思路放在终端交互上也成立,日后做交互式工具会用到:
print "请输入日志文件名: "; chomp(my $name = <STDIN>); print "你输入的是 $name\n";
<STDIN> 从标准输入读一行(含换行符),chomp 只删掉末尾换行——注意它和 chop 不同,chop 会无差别删掉最后一个字符,几乎不该使用。
💡 关键直觉:把"读一行、处理一行"当成 Perl 的呼吸节奏。后面所有章节的正则、统计,都挂在这个节奏上。
加一步:按小时统计行数
总行数只能回答"总量",排查问题几乎一定要看"分布"。给脚本加一个哈希,按小时聚合行数,二十行就能得到一张小时分布表:
#!/usr/bin/perl use strict; use warnings; my $file = shift || 'access.log'; my %per_hour; # 小时 -> 行数 my $bad = 0; # 解析不出的行数 open my $fh, '<', $file or die "无法打开 $file: $!"; while (my $line = <$fh>) { # Nginx 组合格式的时间字段形如 [22/Aug/2026:03:14:57 +0800] if ($line =~ /\[\d+\/\w+\/\d+:(\d{2}):/) { $per_hour{$1}++; } else { $bad++; # 畸形行单独计数,不静默丢弃 } } close $fh; for my $h (sort keys %per_hour) { printf "%s时 %6d 行 %s\n", $h, $per_hour{$h}, '#' x int($per_hour{$h} / 100); } print "无法解析的行: $bad\n" if $bad;
正则 \[\d+\/\w+\/\d+:(\d{2}): 括住两位小时放进 $1;柱状图那点小把戏是 '#' x int(...)——字符串重复运算符 x 按行数除以一百画格子,终端里立刻能看出哪段时间流量异常。$bad 的存在是一个习惯问题:解析失败的行宁可数出来报告,也不要让它们无声消失,否则统计总数对不上时无从查起。
边界情况:换行、编码与最后一行
这个脚本在三种情况下会给出误导性数字,值得逐一交代。其一,Windows 编辑过的日志是 CRLF 换行,length($line) 会把 \r 也计入,跨平台对比字节数时先 s/\r?\n\z//。其二,最后一行可能没有换行符,<$fh> 仍会把它交出来,行数统计不受影响,但逐字符定长的解析要当心。其三,日志含 UTF-8 中文时,length 数的是字节还是字符取决于是否声明了 use utf8 和 binmode——第 5 章文件句柄一节会给完整方案,此刻先记住:字节数和字符数是两个指标,报告里要写清是哪个。
顺带把运行方式补全。类 Unix 上 chmod +x stat.pl 之后可以直接 ./stat.pl access.log;Windows 上关联了 pl 后缀时双击会闪退,老老实实在 cmd 里 perl stat.pl access.log。参数不传时脚本走默认值 access.log,这是给未来的自己留的退路——半夜被叫醒时少敲几个字符也是收益。
把输出重定向到文件时还有个新手常撞的墙:管道或重定向后 print 的内容迟迟不出现在文件里。这是行缓冲在起作用——输出到屏幕时 Perl 按行刷新,输出到文件时改成块缓冲,攒够一块才落盘。脚本正常结束时会自动刷出,但若中途 kill,尾巴上的数据可能丢。处置办法是在脚本开头对输出句柄显式开关:$| = 1; 让每次 print 立即落盘,代价是性能略降。排障守则:长跑脚本必设自动刷新。
本节要点回顾
use strict; use warnings;永远写上,它们把一类隐蔽错误变成显式报错open ... or die是标准开场,失败原因在$!里while (my $line = <$fh>)是逐行处理的惯用法printf负责对齐的数字报告,substr截断超长内容防止刷屏chomp去换行,别用 chop- 运行方式:
perl 脚本名 参数,类 Unix 上加执行权限后可./脚本名 参数