3.1 控制结构
3.1 控制结构
Perl 的分支与循环在 if/while 之外多了 unless/until 和语句修饰符两种本地风味,配合 last/next/redo 三个循环控制词,足以搭出任何日志分流逻辑。
分支:if 与 unless
if ($status >= 500) { push @errors, $line; } elsif ($status >= 400) { $warn_count++; } else { $ok_count++; } push @slow, $line if $elapsed > 500; # 语句修饰符 next if /^\s*#/; # 跳过注释行,最常见的单行守卫 $skip++ unless $parsed; # 反向条件的简写
语句修饰符(动作 if 条件)适合单行动作;动作一旦超过一行,回到块形式。unless 只在"只有一个否定条件"时用,unless/else 这种写法读起来拧巴,属于禁用姿势。
循环:while、for 与 foreach
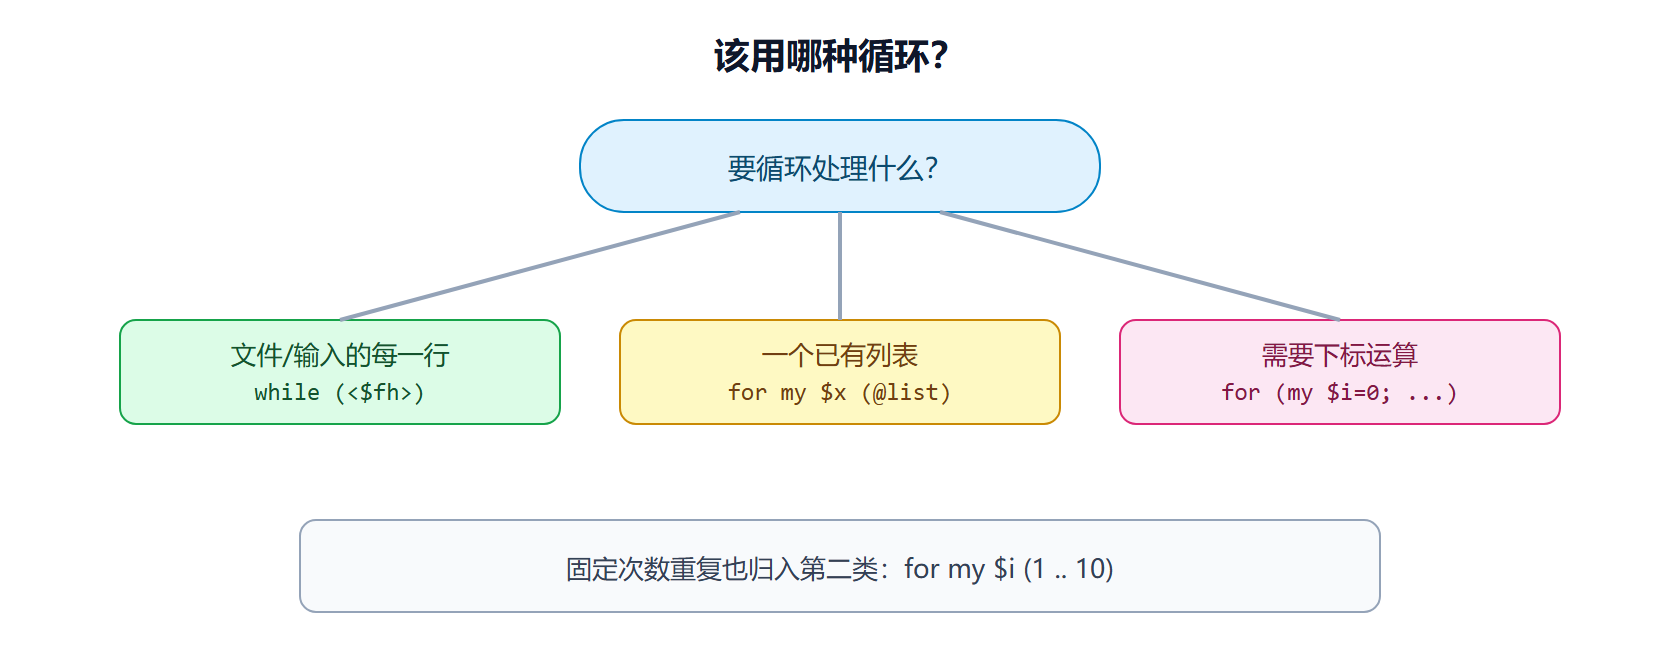
while (defined(my $line = <$fh>)) { ... } # 逐行经典写法 for (my $i = 0; $i < @top; $i++) { ... } # C 风格 for my $api (@apis) { ... } # 遍历列表,首选 foreach my $h (sort keys %stat) { ... } # foreach 与 for 同义
遍历列表永远用 for my $x (@list),C 风格循环只在确实需要下标运算时出现。
last、next、redo
while (my $line = <$fh>) { next if $line =~ /^\s*$/; # 空行跳过,进入下一轮 last if $. > 100_000; # 读满十万行提前收尾 redo if parse_and_retry($line); # 重读本行(少用,慎用) process($line); }
$. 是内建变量:当前读到的行号。用它做采样截断很方便。redo 不推进循环条件重新执行循环体,绝大多数代码用不到,知道它存在即可。
循环选择的决策路径
一个完整的分流骨架
while (my $line = <$fh>) { chomp $line; next if $line eq '' or $line =~ /^#/; if ($line =~ /^ACCESS/) { $access_count++; } elsif ($line =~ /^ERROR/) { push @errors, $line; last if @errors >= 1000; # 错误样本攒够就停 } else { $unknown++; } }
守卫(next if)放在最前、出口条件(last if)写在动作后,这段骨架可以直接套用到多数分类任务上。
given/when:一段值得记住的历史教训
Perl 5.10 引入过 switch 的等价物 given/when,配合智能匹配 ~~ 一度看起来很美:
use feature 'switch'; given ($code) { when (200) { $ok++ } when ([301, 302, 307]) { $redirect++ } # 智能匹配自动按"成员属于"解释 default { $other++ } }
但智能匹配的规则表庞大到没人能背(数字对数组、引用对正则各有不同语义),5.18 起被标记实验性并会告警,5.36 后基本劝退。这段历史的教训值得写进工坊规章:控制结构越简单越好,需要多路分发时,用哈希表派发或 if/elsif 链,语义一望即知:
my %dispatch = ( 200 => sub { $ok++ }, 301 => \&count_redirect, 404 => \&count_missing, ); my $action = $dispatch{$code} or $other++, next; $action->();
哈希派发还把"分支"变成了"数据",新增一种状态码只加一行表项,不动控制流本体。
循环的两个性能现场
第一个现场:逐行处理一个 2GB 的访问日志。while (my $line = <$fh>) 每次只在内存里放一行,这是默认正解;错误写法是 for my $line (<$fh>)——尖括号在列表上下文里先把整个文件读进内存再遍历,2GB 日志会直接把 32 位进程撑爆。同符号不同上下文,结果天差地别,这是 Perl 上下文机制最伤人的一处。
第二个现场:需要对同一批数据反复扫描多遍(比如先算总额再取 top N)。逐行读两遍文件不如一次 slurp 进数组再多次遍历:
open my $fh, '<', $log or die "打不开: $!"; my @lines = <$fh>; # 一次读入 my $total = scalar @lines; # 第一遍:计数 my @slow = grep { /elapsed=(\d+)/ && $1 > 500 } @lines; # 第二遍:过滤 my ($worst) = sort { $b <=> $a } map { /elapsed=(\d+)/ ? $1 : 0 } @lines; # 第三遍
内存装得下就 slurp、装不下就逐行,判断标准只有一个:数据量是否已知且可控。
do 块与裸块:被低估的控制工具
do { ... } 把一串语句折叠成一个表达式,配合语句修饰符能写出"先算再说"的紧凑代码:
my $level = do { if ($err > 100) { 'critical' } elsif ($err > 10) { 'warning' } else { 'notice' } }; # do 块的值是最后表达式 print "级别: $level\n" unless $quiet;
裸块(单独的一对花括号)配合循环控制词可以造出"受控重试"结构,last 充当 break:
RETRY: { for my $attempt (1 .. 3) { last RETRY if fetch_ok(); # 成功跳出整个块 sleep $attempt; # 退避后重试 } die "三次尝试均失败"; # 全部失败才走到这里 }
标签(RETRY:)平时用不上,但多层嵌套里要一次跳出多层时,它比连环布尔旗标干净得多。
本节要点回顾
- 单行守卫用语句修饰符:
next if ...是 Perl 最常见的一行代码 - unless 只用于单分支否定条件,不要写 unless/else
- 遍历列表用
for my $x (@list),C 风格留给下标场景 $.是当前行号,采样截断的顺手工具- last/next 表意清晰,比布尔旗标变量加一层 if 更直接