2.3 列表、数组与哈希
2.3 列表、数组与哈希
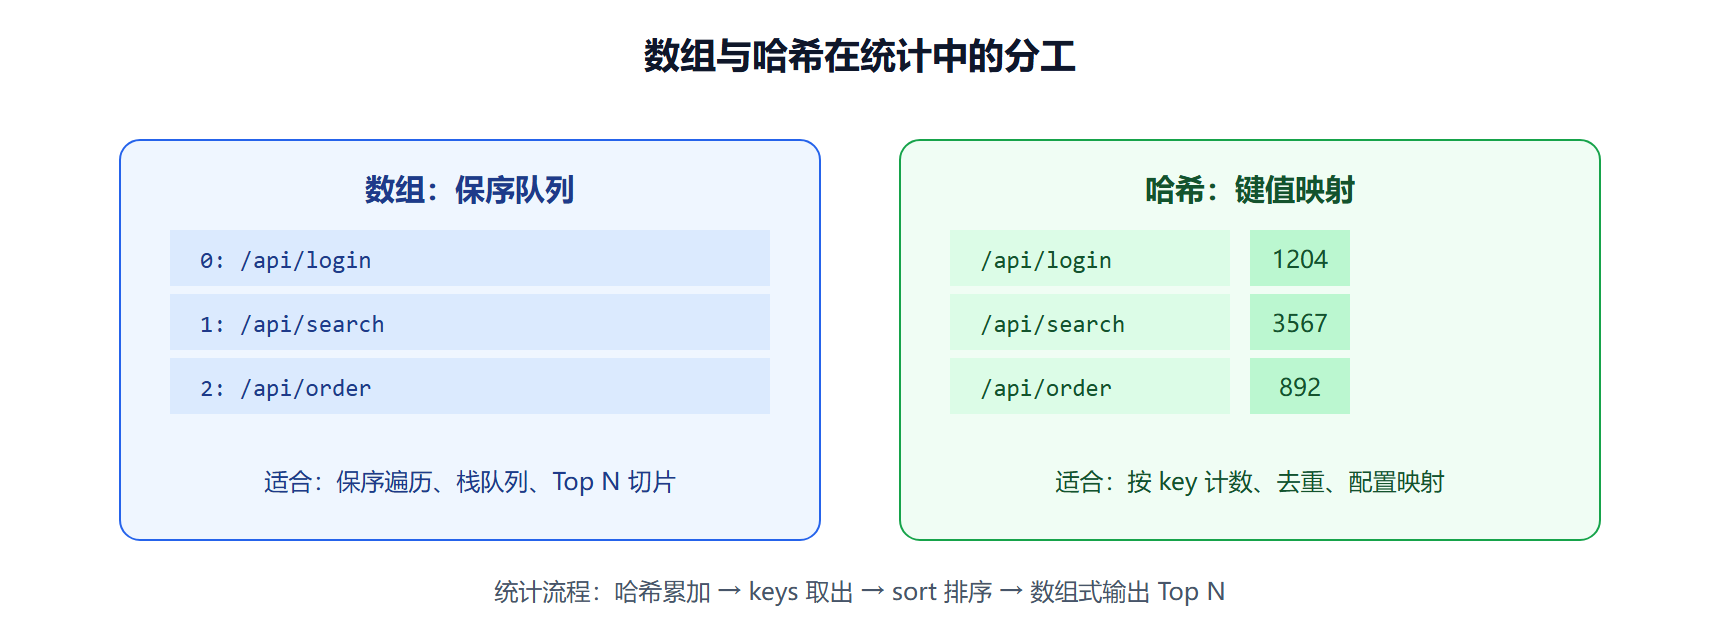
数组与哈希是日志统计的两大主力容器:数组保序装"Top N",哈希按键装"每个接口的计数"。本节用它们完成第一个真正的聚合统计。
数组:排队与切片
my @durations = (120, 35, 890, 42, 210); my @sorted = sort { $a <=> $b } @durations; # 数字升序 my $n = scalar @sorted; # 个数 my @top3 = @sorted[-1, -2, -3]; # 切片:最大三个 my $median = $sorted[int($n / 2)]; # 粗略中位数 push @durations, 66; # 尾部追加 shift @durations; # 头部取出
sort { $a <=> $b } 是数字排序的固定写法(默认 sort 按字符串排,9 会排在 10 前面)。@sorted[-1, -2, -3] 是数组切片,负下标从尾部数起。
哈希:按键聚合
统计每个接口被请求的次数,哈希是标准答案:
my %count; while (my $line = <$fh>) { my ($api) = $line =~ m{GET (\S+)}; next unless $api; $count{$api}++; } # 按次数降序取前五 my $rank = 0; for my $api (sort { $count{$b} <=> $count{$a} } keys %count) { printf "%2d. %-40s %6d 次\n", ++$rank, $api, $count{$api}; last if $rank >= 5; }
这段二十行的循环就是日志统计的原型:逐行提取、哈希累加、排序输出。后面的章节只是把"提取"换得更准(正则)、把"逐行"扩到多文件(文件流水线)、把"输出"升级成报表。
两类容器的分工图
⚠️ 常见坑:哈希的
keys顺序不保证稳定。要确定性输出,永远显式sort,别依赖遍历顺序。
从计数到排名:完整可运行的统计段
把 2.2 清洗好的字段接进来,做一次"背景→操作→结果→解读"完整的统计。背景:手头已有按接口提取的原始记录数组,每项是 [接口名, 耗时ms] 的二元列表。操作:
my @records = ( ['/api/search', 120], ['/api/login', 35], ['/api/search', 890], ['/api/order', 42], ['/api/search', 210], ['/api/login', 66], ); my (%count, %total, %max); for my $r (@records) { my ($api, $ms) = @$r; $count{$api}++; $total{$api} += $ms; $max{$api} = $ms if $ms > ($max{$api} // -1); } for my $api (sort { $total{$b} <=> $total{$a} } keys %total) { printf "%-14s 次数%3d 平均%6.0fms 峰值%6dms\n", $api, $count{$api}, $total{$api} / $count{$api}, $max{$api}; }
结果输出三行,search 排在首位。解读:($max{$api} // -1) 用"定义或"给首次比较一个必然更小的起点,这是处理"聚合时第一次见到这个键"的通用手法,比先 grep 键是否存在简洁得多。排序键选了总耗时而非次数——报表的排序键应该由业务问题决定,"哪个接口最拖慢用户"问的是总耗时,"哪个接口最热门"问的才是次数。
去重、翻转与两个内存边界
List::Util 是核心自带的工具箱(5.8 起无需安装),去重一行可用:
use List::Util qw(uniq max sum); my @apis = uniq map { $_->[0] } @records; # 接口名去重 my $worst = max map { $_->[1] } @records; # 全局最大耗时 my $sum = sum map { $_->[1] } @records; # 总耗时
哈希翻转是另一个高频动作:my %rev = reverse %count; 把"接口→次数"翻成"次数→接口"。但翻转会丢数据——两个接口次数相同时后者覆盖前者。安全做法是翻转成"值 → [键列表]"的引用结构,正好预习 2.4 的内容。
内存方面记住两条物理事实:数组按元素个数线性占内存,千万级标量尚可承受;哈希的键会额外复制一份存进哈希结构,键很长时内存翻倍不夸张。日志分析中途如果内存报警,第一反应不是换语言,而是检查是否把整份日志读进了数组——改成 while 逐行流式处理,内存立刻回到常数级。这个"数组随机访问、流式常驻内存"的取舍,第 5 章多文件处理时还会正式展开。
补一个并列名次的细节:Top N 输出里两个接口次数相同时,名次应该并列还是顺延,报表口径必须先说清。并列的实现思路是"次数相同给同一个名次":
my $rank = 0; my $prev; for my $api (sort { $count{$b} <=> $count{$a} } keys %count) { $rank++ if !defined($prev) || $count{$api} != $prev; $prev = $count{$api}; printf "%2d. %-20s %d\n", $rank, $api, $count{$api}; last if $rank >= 5; }
$prev 记住上一行的次数,只有变化时才递增名次。这类小逻辑在给业务方看报表时能省掉"为什么有两个第二名"的解释成本,属于典型的低成本专业度。
本节要点回顾
- 数字排序写
sort { $a <=> $b },默认 sort 是字符串序 - 切片
@arr[...]可用负下标,取尾部元素不必先算长度 $count{$key}++是聚合原子操作,首次自动从 1 起算keys %hash顺序随机,输出前必须显式排序- 数组问顺序、哈希问键:选容器先问"我关心位置还是关心名字"