5.1 文件句柄
5.1 文件句柄
文件句柄是 Perl 与文件之间的通道:
open建立通道,<$fh>逐行取货,close关门。三个方向(读、写、追加)、三个标准通道(STDIN/STDOUT/STDERR)构成文件 I/O 的全部基本盘。
三种打开模式
open my $in, '<', $src or die "读打开失败: $!"; open my $out, '>', $dst or die "覆盖写失败: $!"; open my $log, '>>', $app or die "追加写失败: $!";
三参数形式(句柄、模式、文件名)永远优于古老的两参数形式——后者会把 > foo 这样的文件名当重定向解析,是个安全窟窿。
钻石操作符:一个脚本通吃三种输入
while (my $line = <>) { $count++; } print "共 $count 行\n";
不带参数的 <> 依次读命令行给出的所有文件,一个文件都没有就读标准输入。于是同一个脚本三种用法都成立:
perl count.pl a.log b.log # 统计指定文件 cat big.log | perl count.pl # 接管道 perl count.pl < access.log # 接重定向
Unix 工具链"只管标准输入输出"的设计哲学,被 <> 原样继承——这也是 Perl 脚本能嵌进管道流水线的原因。
三类通道的数据流向
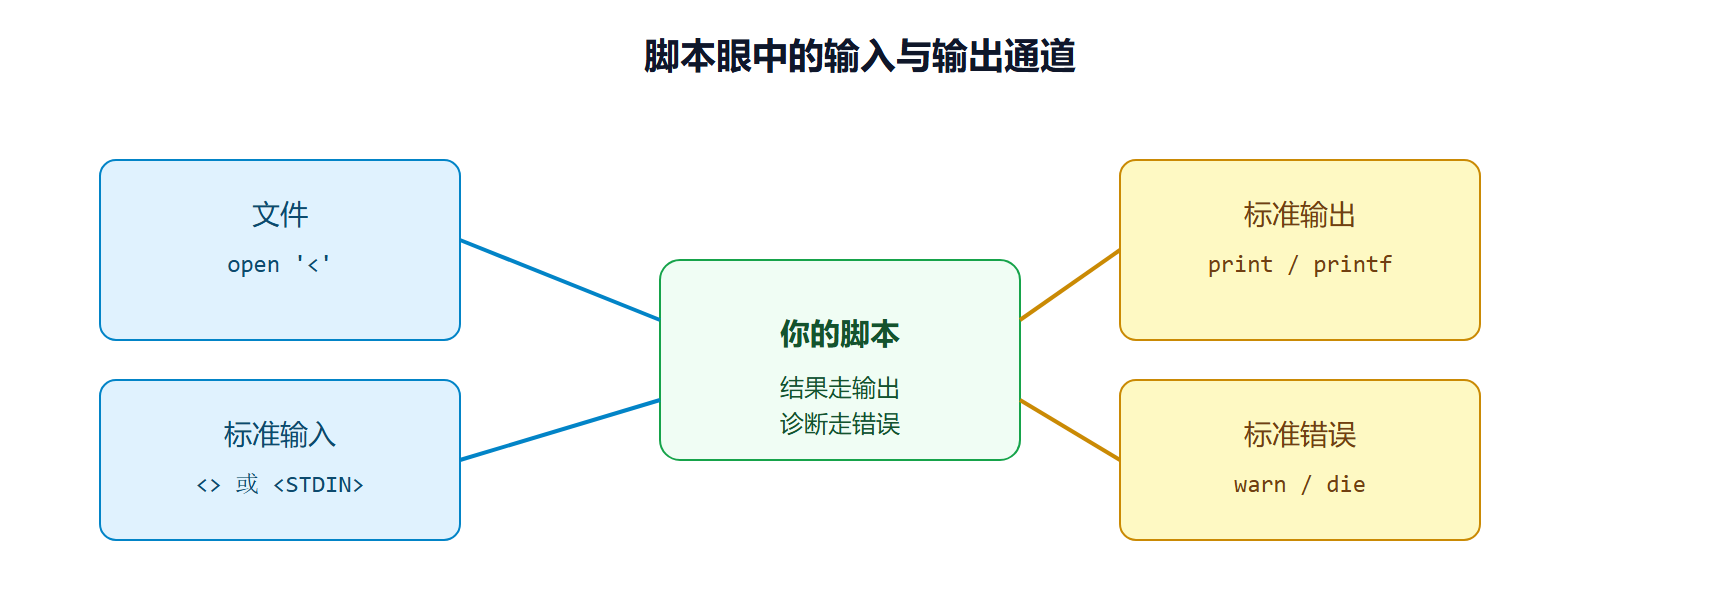
一次性读入与编码声明
use utf8; # 本脚本源码按 UTF-8 解 open my $fh, '<:utf8', $src or die; # 声明输入文件编码 { local $/; my $whole = <$fh>; # slurp:整文件读成一个字符串 }
老环境的 GBK 日志用 '<:encoding(gbk)' 打开,输出端同理声明。乱码问题的九成,都是"读入端和输出端有一边没声明编码"。
⚠️ 常见坑:写文件的缓冲在 close 或脚本退出时才落盘。写完不 close 就去读同一个文件,大概率读到旧内容。
现场排错:三类打开失败各是什么样
open 失败的报错信息值得逐类认识一次,现场才不会慌:
open my $fh, '<', '/var/log/app/nope.log' or die "1: $!"; # 1: No such file or directory -> 路径问题:拼错、文件还没生成 open my $fh, '<', '/root/secret.log' or die "2: $!"; # 2: Permission denied -> 权限问题:换用户或提权 open my $fh, '>', '/proc/version' or die "3: $!"; # 3: Invalid argument 等 -> 试图把普通写当特殊文件,方向就错了
$! 里的操作系统错误是排错的第一线索,die 消息务必带上它与文件名。另一个高频现场是"权限 denied 但 ls 看着正常"——多半是目录无执行位(目录要 x 才能进入),这类问题 ls 文件本身看不出来,得看目录权限。
自动关闭:作用域送走句柄
词法句柄(my $fh)在离开作用域时会被 Perl 自动关闭。把这个性质与裸块组合,就得到"用完即走"的紧凑写法:
sub count_lines { my ($path) = @_; open my $fh, '<', $path or die "打不开 $path: $!"; my $n = 0; $n++ while <$fh>; return $n; # $fh 随子程序返回而自动关闭 }
注意自动关闭发生的时机是变量销毁,不是语句结束——循环里反复 open 同一个词法变量,前一个句柄在新一次赋值时才关闭。要精确控制生命周期,还是显式 close,尤其写文件时必须检查 close 返回值(缓冲落盘失败只在此时报出)。
三个高频现场问答
把文件句柄的边角问题压成三个问答,都是工坊里被问过无数次的真实场景。第一问:怎么判断文件读完了?钻石操作符读到文件尾返回 undef,while (defined(my $l = <>)) 的循环条件自然终止,不需要 eof;反过来用 eof 做循环条件(while (!eof $fh))在空文件与最后一行上容易差一错,属于教科书反面写法。第二问:两个脚本同时写一个日志文件会怎样?各自缓冲互不感知,输出会交错撕碎——追加模式下单行 write 原子性由操作系统保证(单次 write 小于管道缓冲时),所以多进程写日志约定"一次 print 一行、行尾带换行",靠这个约定而非锁。第三问:读到的行带不带换行符?带,<$fh> 原样保留行尾,忘记 chomp 就拿去做哈希键,是统计莫名多出空白的第二大来源(第一大是编码)。三个问答的共同点:答案都藏在"通道里流动的到底是什么字节"这个视角里——把句柄看成字节流而非"行容器",这类问题都可以自己推出来。再补一个常被忽略的细节作为本节的收尾:STDOUT 在输出到终端时按行刷新、重定向到文件时变全缓冲,这就是"脚本直接跑能看到进度、重定向后日志迟迟不动"的原因。需要重定向下也实时,就在 print 后 $fh->autoflush(1)(STDOUT 用 $| = 1),进度类输出务必带上这一句。缓冲行为的差异还解释了另一个经典现象:脚本崩掉时最后几条 print 的内容"消失"了——它们还躺在未刷新的缓冲里。排查这类"日志比预期短一截"的问题,先怀疑缓冲,再怀疑逻辑,多数时候是前者。
# 问答一的验证代码:空文件与单行文件各试一次 open my $t, '<', \$empty_or_line; # 标量当文件,方便测试 while (my $l = <$t>) { print "[$l]\n" } # 方括号让行尾现形
本节要点回顾
- 三参数 open是唯一正确姿势,两参数形式有注入风险
<>让脚本通吃文件参数、管道、重定向三种输入- print 到 STDOUT、warn/die 到 STDERR,别把诊断混进数据流
- 编码在 open 时声明,输入输出两端都要
- 写完 close,或者用 5.3 节的自动关闭写法