6.4 面向对象实战:日志解析器对象
6.4 面向对象实战:日志解析器对象
Perl 的对象就是"被 bless 标记了所属包的引用":方法调用
$obj->foo等价于Class::foo($obj),第一个参数永远是对象自身。理解这一句话,就理解了全部机制。
从函数到对象的动机
第 5 章的流水线用零散哈希装状态:%stat、%bad_lines 在函数之间传来传去。文件一多,"哪个哈希归哪段逻辑管"开始含糊。对象把数据(解析器状态)和操作它的函数(方法)捆在一起,调用方只面对一个 $parser。
手写一个 LogParser
package LogParser; sub new { my ($class, %args) = @_; my $self = { stat => {}, # api -> [次数, 总耗时] bad_lines => 0, threshold => $args{threshold} // 500, }; return bless $self, $class; # 核心:标记引用的所属包 } sub feed { # 喂一行,内部更新状态 my ($self, $line) = @_; chomp $line; if ($line =~ /^(\S+)\ \[\S+\] "\w+\ (\S+)"\ (\d{3})\ (\d+)ms$/) { my ($api, $ms) = ($2, $4); $self->{stat}{$api}[0]++; $self->{stat}{$api}[1] += $ms; $self->{slow}++ if $ms > $self->{threshold}; return 1; } $self->{bad_lines}++; return 0; } sub slow_count { $_[0]->{slow} // 0 } sub bad_count { $_[0]->{bad_lines} } sub top { my ($self, $n) = @_; my $s = $self->{stat}; return map { [$_, @{$s->{$_}}] } (sort { $s->{$b}[0] <=> $s->{$a}[0] } keys %$s)[0 .. $n - 1]; } 1;
调用侧的世界随之变干净:
my $p = LogParser->new(threshold => 300); while (my $line = <>) { $p->feed($line); } for my $row ($p->top(5)) { printf "%-35s %6d 次 平均 %d ms\n", @$row; } printf "慢请求 %d 个,坏行 %d 行\n", $p->slow_count, $p->bad_count;
方法调用的真面目
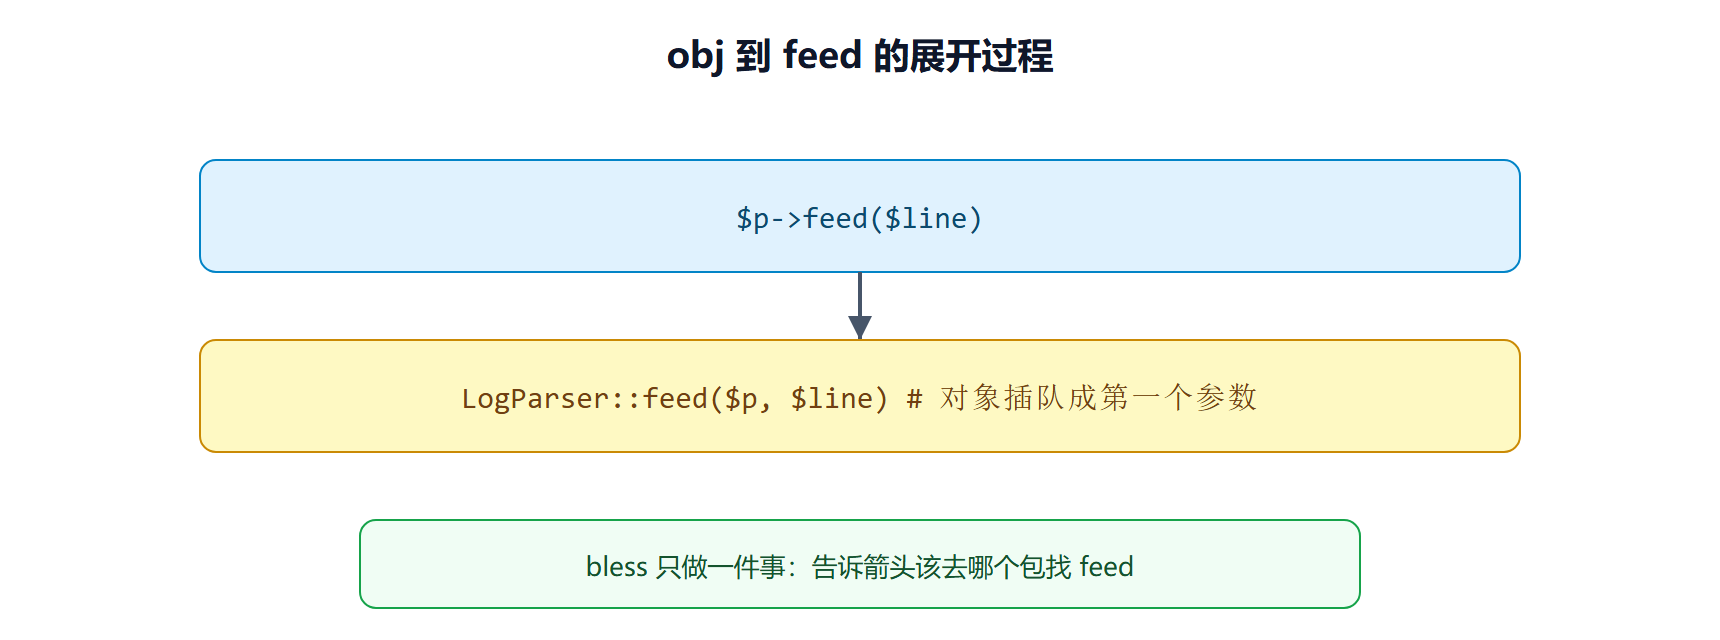
new 里 bless $self, $class 把普通哈希引用标记为 LogParser 家的;之后每次箭头调用,Perl 都按这个标记去对应包找方法,并把 $self 自动塞进 @_ 的第一位。没有隐藏字段、没有魔法语法,所谓对象不过如此。
💡 关键直觉:什么时候需要对象?当"状态"开始有多份(同时解析两种日志格式)、或状态与函数的对应关系开始需要注释来维护时。一次性脚本硬套对象只会更绕。
现代写法对照:Moo 一瞥
手写 bless 的价值在于看清机制,工程上更常用轻量对象框架 Moo,同样的解析器只需声明"有哪些属性":
package LogParser; use Moo; has threshold => (is => 'ro', default => 500); # 只读属性带默认值 has stat => (is => 'ro', default => sub { {} }); has slow => (is => 'rw', default => 0); # 可读写 has bad_lines => (is => 'rw', default => 0); sub feed { my ($self, $line) = @_; ... # 与手写版相同,状态改走 $self->stat 访问器 } 1;
Moo 替你生成 new 与访问器,还附送类型检查与构建钩子(builder、trigger)。要不要上它,判据与上一条直觉一致:属性超过四五个、或需要继承组合时,框架的省力开始显著;两三个属性的小对象,手写版反而更少一层依赖。知道两种写法的等价关系,读老代码(手写)与新代码(框架)就都能落地。
对象的测试钩子:为什么接口窄好测
LogParser 的接口只有 feed、slow_count、bad_count、top 四个方法,测试因此可以完全不碰文件系统:
my $p = LogParser->new(threshold => 100); is $p->feed('10.0.0.1 [t] "GET /a" 200 150ms'), 1, '正常行返回 1'; is $p->slow_count, 1, '超阈值计入慢请求'; is $p->feed('garbage'), 0, '坏行返回 0'; is $p->bad_count, 1, '坏行计数正确';
不 open 文件、不碰目录,喂字符串、查计数,测试毫秒级完成且不依赖环境——这是"接口只暴露方法、状态藏在 $self"带来的直接红利。第 7.3 节的测试实践将以这类对象为主角,此处先把接口设计成好测的样子。
继承一瞥:解析器家族的扩展方式
第二个解析需求出现时(比如错误日志格式),继承让 LogParser 不用改一行就长出变体:
package ErrParser; use parent 'LogParser'; # 声明父类 sub feed { # 只覆写格式相关的部分 my ($self, $line) = @_; chomp $line; if ($line =~ /^(\w+)\s+ERROR\s+(\S+)\s+(\d+)ms/) { my ($level, $api, $ms) = ($1, $2, $3); $self->{stat}{$api}[0]++; $self->{stat}{$api}[1] += $ms; return 1; } return 0; } 1; my $p = ErrParser->new(threshold => 1000); # new、top、计数全部继承
use parent 建立父子关系,方法查找沿继承链向上:ErrParser 有 feed 用自己的,没有的(new、top)用父类的。设计上的关键取舍是父类把"统计口径"与"格式解析"做成了两个耦合点——更好的演进是父类只管聚合,把单行解析声明为"子类必须提供"的抽象方法。这个重构留给读者:把 feed 拆成 parse(子类各写)与 record(父类通用),你会亲手摸到"模板方法"这个设计模式的雏形,也就理解了对象化真正的省力点——不是少写代码,而是让变化集中在该变的地方。
本节要点回顾
- 对象 = bless 过的引用,方法 = 首参为对象的子程序
- new 里组装哈希、bless、返回,三步是固定套路
$obj->method与Class::method($obj)完全等价- 状态进
$self,接口只暴露方法,调用方碰不到内部哈希 - 不盲从 OOP:单流水线用函数加引用传参往往更清爽