5.3 执行算子与并行查询
5.3 执行算子与并行查询
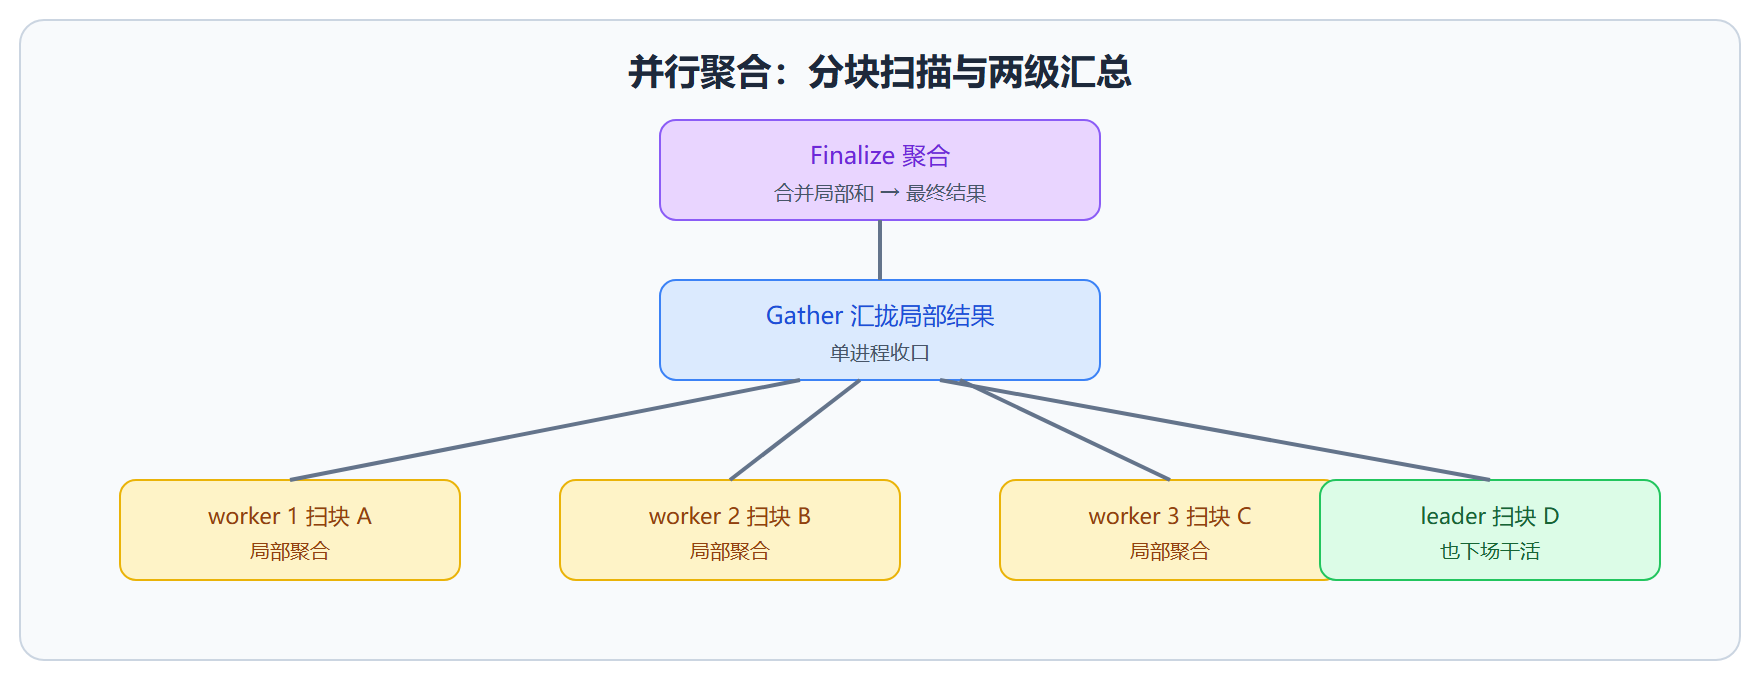
本节摘要:执行器按火山模型逐行拉动计划树,扫表有顺序与索引两条路,连接有嵌套循环、合并、哈希三种算法,聚合有分组聚合与哈希聚合两套打法。大表顺序扫描与大连接可由并行工作者分摊:leader 加 workers 各扫一块,结果汇总。读懂 EXPLAIN ANALYZE 的 loops 与实际时间,就能区分"估错了"与"真就这么贵"。
连接三算法的取舍
EXPLAIN ANALYZE SELECT o.id, c.name FROM orders o JOIN customer c ON o.cid = c.id WHERE o.created_at > now() - interval '1 day';
| 算法 | 工作方式 | 吃谁 |
|---|---|---|
| 嵌套循环 | 外层每行去内层找匹配,内层有索引时极快 | 内层索引 + 外层结果小 |
| 哈希连接 | 小表建哈希表,大表流式探测 | work_mem,等值连接 |
| 合并连接 | 两输入按连接键排序后归并 | 已排序输入或愿意付排序成本 |
经验法则:外层几百行、内层有索引,嵌套循环无脑赢;两边都大且是等值,哈希连接是主战场;work_mem 装不下哈希表时,哈希连接会分批落盘,代价骤增——EXPLAIN 里出现 Batch 字样就是警报。
并行查询:分块扫表再汇总
-- 大表聚合自动并行 EXPLAIN ANALYZE SELECT customer_id, sum(amount) FROM orders GROUP BY customer_id;
Finalize GroupAggregate (actual time=8231.2..8246.1 rows=982) -> Gather (actual ... loops=1) Workers Planned: 4 Workers Launched: 4 -> Partial HashAggregate (actual ... loops=5) -> Parallel Seq Scan on orders (actual ... loops=5)
解读三要点:
- loops=5:leader 加 4 个 worker 各自执行了一遍该节点,actual time 是单次时间,总行数是五份之和
- Partial 与 Finalize:各 worker 先算局部聚合,Gather 汇拢后由 Finalize 收尾——聚合函数必须是可合并的
- Workers Launched < Planned:并发太高或 max_worker_processes 顶满时实际起不满,并行收益打折
并行的大门只对够贵的计划打开(min_parallel_table_size 等阈值),且只惠及顺序扫描、哈希连接、归并连接等少数算子——索引点查天然便宜,没有并行的必要。
图:并行聚合的数据流
EXPLAIN ANALYZE 的两把尺子
估算行数与实际行数的偏差,是判读的第一把尺子:
Seq Scan on orders (rows=1000 ...) (actual ... rows=852131)
预估一千、实际八十五万——规划器基于错误情报做的任何选择都可疑,先 ANALYZE 再重跑计划,往往问题自愈。第二把尺子是 actual time 的自顶向下累积:找出计划中"本节点自身耗时"(去掉子节点)最大的那个,它就是真凶,不需要猜测。
💡 关键直觉:并行不是提速万金药。启动 worker、汇拢结果都有固定开销,小表并行反而更慢;它真正的舞台是"必须扫完全表"的聚合与分析场景。
work_mem 实验:一行参数改变计划形态
哈希连接与排序是 work_mem 的两大客户,用 EXPLAIN 的一行输出就能看到内存大小如何改写计划:
SET work_mem = '4MB'; EXPLAIN (ANALYZE, BUFFERS) SELECT o.id, c.name FROM orders o JOIN customer c ON c.id = o.cid WHERE o.created_at > now() - interval '30 days';
Hash Join (actual ... loops=1) Hash Cond: (o.cid = c.id) -> Seq Scan on orders (rows=89000) (actual rows=89213) -> Hash (rows=50000, buckets: 65536 batches: 4)
batches 为 4 是警报:哈希表装不进四兆内存,被切成四批轮转落盘,大表侧要反复读写临时文件。同一个查询改一行:
SET work_mem = '128MB'; -- 重跑后 Hash 行变为 (buckets: 65536 batches: 1),临时文件消失
但别急着全局调大:work_mem 按连接、按操作节点分配,全局 128MB 乘以两百个连接就是灾难预算。正确姿势是会话级或事务级定点投放——只给确认受益的报表会话设大,业务连接保持默认。
排序落盘与临时文件观测
排序同样受 work_mem 约束,装不下时外排落盘。落盘量有全局观测面:
-- 哪些语句在写临时文件、写了多少 SELECT temp_files, pg_size_pretty(temp_bytes) AS temp_written, left(query, 60) FROM pg_stat_statements WHERE temp_bytes > 0 ORDER BY temp_bytes DESC LIMIT 5;
temp_bytes 高的语句就是 work_mem 投放或查询改写的候选名单。另一个常被忽略的点:EXPLAIN ANALYZE 本身会真实执行并落盘,生产大查询上慎用,必要时改用裸 EXPLAIN 加 pg_stat_statements 交叉判断。
并行参数三件套与失效边界
max_parallel_workers_per_gather(单查询每收集点最多几个 worker)、max_parallel_workers(全库并行 worker 总池)、max_worker_processes(操作系统级进程上限)三层嵌套,任何一层满载都会让 Workers Launched 低于 Planned。失效边界同样要记住:带锁的操作(SELECT FOR UPDATE)、游标、暂停的查询、写 CTE 与函数体内的语句多数场景不并行;并行扫描还要求表大小超过阈值。诊断并行问题的固定三步:确认计划里有没有 Gather 节点、Launched 是否等于 Planned、loops 倍数与耗时是否匹配。三步都对,再谈调 worker 数;否则先解决"为什么没并行"。
本节要点回顾
- 连接三算法各有主场:嵌套循环吃索引、哈希吃内存、合并吃有序
- loops 乘法:并行计划里 actual 行数与时间是各 worker 之和
- 两把尺子:估错行数先修统计,找最大自耗时定位真凶
- 并行有门槛:只惠及大扫描与大连接,点查无份