5.1 解析、分析与规则重写
5.1 解析、分析与规则重写
本节摘要:SQL 文本到可规划对象要过三关:解析器只管语法产出原始语法树;分析器把表名、列名、类型绑定到系统目录里的真实对象,产出查询树;重写器再应用视图与查询重写规则。三关各有各的报错口径,理清它们,一半的"SQL 为什么报这个错"迎刃而解。
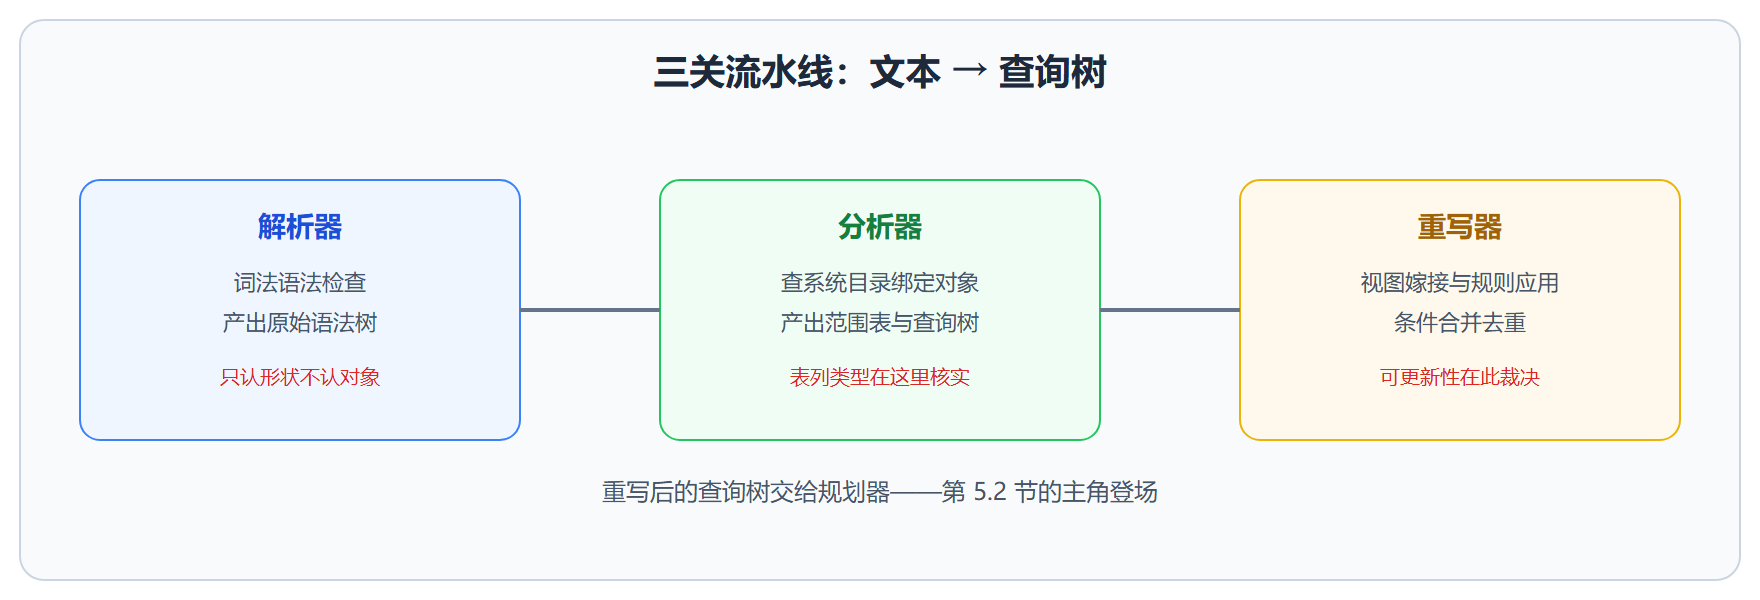
三关的输入输出
SELECT u.name, count(o.id) FROM usr u JOIN orders o ON o.uid = u.id WHERE u.status = 'active' GROUP BY u.name;
| 关卡 | 做什么 | 关键产物 | 典型报错 |
|---|---|---|---|
| 解析器 | 词法语法检查 | 原始语法树 | syntax error at or near |
| 分析器 | 查系统目录绑定对象与类型 | 查询树(RangeTblEntry 清单) | relation不存在、column不存在、类型不匹配 |
| 重写器 | 应用重写规则、展开视图 | 改写后的查询树 | 对不可更新视图做增删改时报错 |
分析器的产出 RangeTblEntry(范围表项)列出查询涉及的所有表——包括子查询、连接、函数返回集——规划器后续所有估算都围绕范围表展开。
视图展开就发生在这里
CREATE VIEW active_user AS SELECT * FROM usr WHERE status = 'active'; -- 这条查询在重写阶段被改写为对 usr 基表的直接查询 SELECT name FROM active_user WHERE id = 7;
重写器把视图定义的查询树嫁接进外层查询树,再合并 WHERE 条件。规划器看到的已经是"usr 表 + 两个过滤条件",不存在"视图层"的性能损耗。
反过来,对视图做 INSERT/UPDATE/DELETE 也由重写器裁决:简单视图(单表、无聚合、无窗口)自动改写到基表;复杂视图默认拒绝,除非用 INSTEAD OF 触发器手工接管。
用 DEBUG 眼见为实
SET client_min_messages = log; SET debug_print_parse = on; -- 看原始语法树 SET debug_print_rewritten = on; -- 看重写后的查询树 SELECT name FROM active_user WHERE id = 7;
日志里会先打印解析产物,再打印重写后的树——后者里已经找不到 active_user,只剩 usr 与合并后的条件。两棵树的差异就是重写器的工作量。
图:从文本到查询树的三关
💡 关键直觉:绑定发生在分析阶段意味着——同一条 SQL 反复执行时可以走预备语句跳过前两关;而表结构变更后旧预备语句会因快照失效而重新分析,这是"prepared statement 为什么偶尔变慢"的深层原因之一。
search_path:分析阶段的身份解析器
分析器把不合格的表名解析成模式全名,靠的是 search_path 这份查找顺序。默认值是公共模式加系统模式,多数单租户应用从不感知它——直到多模式架构(按租户分模式)或迁移工具介入:
-- 查看当前解析顺序 SHOW search_path;
search_path --------------------- "$user", public
这里的 "$user" 是一个占位符:若存在与当前用户同名的模式,优先解析到它。两个由此衍生的事故形态值得记住。其一,两条会话用不同角色连接、同名表在不同模式下,同一条 SQL 在两个会话里解析到不同表——数据"莫名的"不一致,查了半天应用代码,其实是身份解析在捣乱。其二,删除了 search_path 里排在前面的模式后,裸表名开始命中公共模式下的同名旧表,读写悄悄换了对象。防御做法:应用连接串里显式固化 search_path 到唯一模式,并在代码里对关键表用模式全名,把解析的模糊空间关死。
一次报错的三段定位实操
把分段定位的思路走成完整案例。现象:发布后某接口开始报 operator does not exist: text = integer。
第一步判断阶段:这个错发生在分析阶段——操作符绑定属于类型检查,还没走到重写,更没执行。依据是错误类别:对象与类型绑定类错误全在分析段。第二步定位成因:排查新代码里的拼接条件,发现一处把用户输入的数字直接与 text 列比较。第三步选择修法:改应用侧做类型转换,而不是在数据库里造一个 text = integer 的隐式转换操作符——后者会让全库所有同类错误静默通过,把小错养成大错。
同款思路可以推到重写段:如果错误消息里出现视图名或规则名,且把语句里的视图换成其定义的基表后错误消失,那就是重写段在展开视图时撞上的问题(最典型:对含聚合的视图做更新)。三段各留下什么样的指纹,做过几轮案例后自然形成手感,这正是"报错信息是分段定位的第一证据"的含义。
预备语句的两个翻车现场
现场一:长连接应用上某语句间歇性变慢,日志显示偶尔出现全表扫计划。机制:该语句参数分布极不均匀,定制计划(按实际参数值规划)与通用计划(参数化一次成型)各有擅长;执行一定次数后规划器会尝试切换到通用计划,若通用计划恰好对热门参数不友好,就表现为间歇性慢。处置:对该语句关闭通用计划(应用层或语句级参数),或把该查询改写让参数不敏感。
现场二:大促前批量变更表结构后,应用的预备语句大面积失效重编,瞬间 CPU 尖刺。机制:结构变更令缓存的计划失效,所有会话的前三段缓存作废,短时间内集中重做解析分析。这本身是保护机制(旧计划引用不存在的列会出错),要做的不是阻止失效,而是把结构变更摊到低峰分批做,并预热关键语句。两个现场共同的教训:预备语句不是"设置完就忘"的开关,它是带行为的缓存,缓存就有一致性与命中率两本账。
视图可更新性的判定细则
重写器裁决"对视图能不能做增删改"有明确细则,记两条主干即可应对绝大多数场景。单表、无聚合、无窗口函数、无 DISTINCT、无返回集函数的视图自动可更新——重写器把修改语句直接改写到基表。带上述任何元素的视图默认拒绝,想接管就得给视图写 INSTEAD OF 触发器,把每种修改动作翻译成对基表的手工操作。介于两者之间的是分区视图与带条件的简单视图:能改,但插入可能落在视图条件之外,行为由 WITH CHECK OPTION 控制——开启后,修改结果若会让行脱离视图可见范围,语句报错而非静默成功。这条选项是多租户"按视图切片读写"方案的安检门,默认不开就是默认留了一个静默缺口,值得在架构评审时专门点名。
本节要点回顾
- 解析管形状,分析管身份,重写管改写:三关三套报错口径
- 范围表是规划地基:所有表、子查询、函数都在其中登记
- 视图零开销:重写阶段已展开合并成基表查询
- 预备语句省前两关:结构变更后会触发重新分析