4.2 四种补充索引结构选型:HASH、GiST、SP-GiST、BRIN
4.2 四种补充索引结构选型:HASH、GiST、SP-GiST、BRIN
本节摘要:B 树只吃"可排序"的键。等值-only 的长键、空间与近邻查询、前缀类数据、物理顺序相关的大表,各有更合身的索引结构:HASH 等值定长寻址、GiST 通用搜索树、SP-GiST 非平衡空间树、BRIN 块范围摘要。选型错了不是慢一点,而是根本用不上。
一张表押注一种数据分布
| 结构 | 押注的分布 | 擅长 | 不擅长 |
|---|---|---|---|
| HASH | 键长且只做等值 | 定长哈希定位,无排序负担 | 范围、排序、唯一性约束 |
| GiST | 可定义"包含/相交"谓词的域 | 地理框、近邻、范围类型 | 精确等值略逊 B 树 |
| SP-GiST | 天然分区结构(前缀、四象限) | IP 前缀、字符串前缀 | 无分区特征的数据 |
| BRIN | 物理存储与键强相关 | 时序大表按时间过滤 | 随机写入的表,摘要失真 |
HASH:只为等值而生
CREATE INDEX ON user_token USING hash (token); SELECT * FROM user_token WHERE token = 'a3f9...';
几百字符的随机令牌表,只为等值查询服务时,HASH 索引体积远小于把整个键按序摆开的 B 树。代价:不支持范围、排序,也不支持唯一约束;且崩溃后需重建(旧版本遗留限制,近年已改善但选型理由不变)。
GiST:地理与近邻的主场
GiST 是"可插拔谓词"的框架:地理扩展用它实现包围盒相交,范围类型用它实现区间重叠。
-- 近邻查询:离该点最近的十家门店 CREATE INDEX ON store USING gist (location); SELECT id, location <-> point '(116.4,39.9)' AS dist FROM store ORDER BY dist LIMIT 10;
<-> 距离操作符配合 GiST 才能避免全表排序——这是"找最近"类需求的唯一正解。
SP-GiST:按前缀分家的树
适合天然分区数据:IP 地址按位前缀、字符串按字典前缀。
CREATE INDEX ON ip_log USING spgist (ip inet); SELECT count(*) FROM ip_log WHERE ip << '10.0.0.0/8';
radix 树按位展开,前缀匹配的路径长度只与键长有关,与总量无关。
BRIN:给超大表记"页区间账"
BRIN 不索引每一行,而是每一段连续页面(默认 128 页)记一个最小最大摘要。查询时跳过不可能命中的段,代价是极小的体积。
-- 时序表:时间与物理写入顺序高度相关 CREATE INDEX ON events USING brin (created_at) WITH (pages_per_range = 64); SELECT count(*) FROM events WHERE created_at >= now() - interval '1 hour';
十亿行的表,BRIN 索引可能只有几 MB——因为最新数据永远在文件尾部,摘要能精准圈出候选段。反之,如果数据是随机乱序写入的,每段摘要都覆盖全值域,BRIN 退化成无用的账本。
图:四种结构的形状直觉
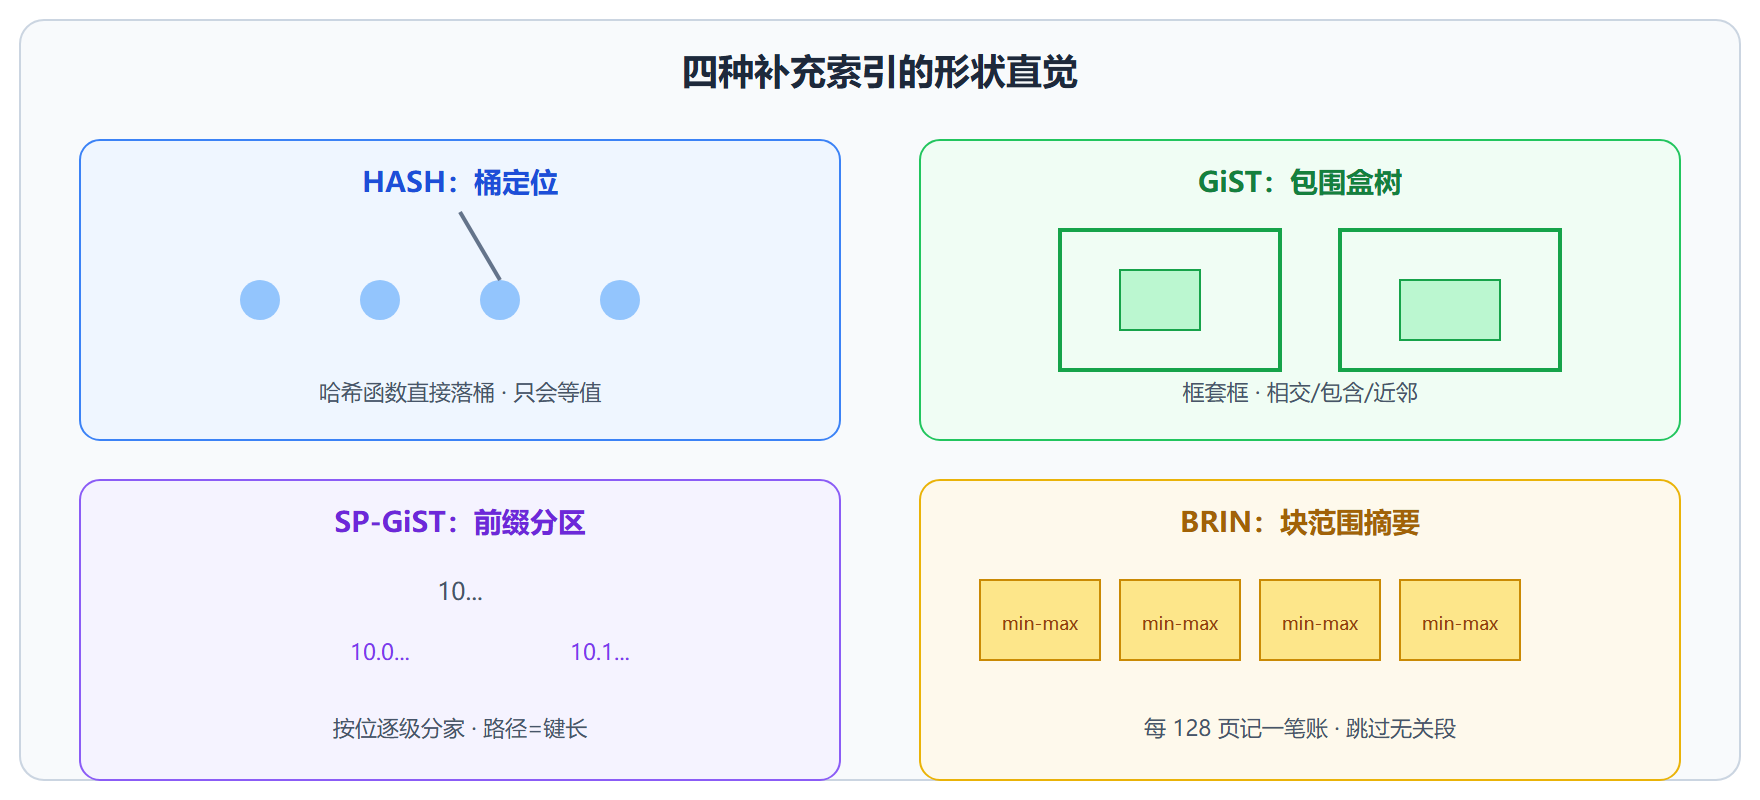
💡 关键直觉:索引结构是在赌"数据长什么样"。自增时序赌 BRIN,空间点赌 GiST,前缀键赌 SP-GiST,长随机键等值赌 HASH。赌对结构,十亿行也只是几 MB 索引。
体积对比实验:同四种索引各建一遍
选型讲再多不如亲手建一遍。一张千万行的访问日志表,同一列建四种索引量体积:
-- 访问时间列:物理顺序与时间高度相关的时序表 CREATE INDEX ON access_log USING btree (ts); CREATE INDEX ON access_log USING brin (ts) WITH (pages_per_range = 64); CREATE INDEX ON access_log USING hash (client_ip); CREATE INDEX ON access_log USING spgist (path text_pattern_ops);
SELECT c.relname, pg_size_pretty(pg_relation_size(c.oid)) AS size FROM pg_class c WHERE c.relname IN ('access_log_ts_idx', 'access_log_ts_idx1', 'access_log_client_ip_idx', 'access_log_path_idx') ORDER BY pg_relation_size(c.oid) DESC;
relname | size ------------------------+--------- access_log_ts_idx | 214 MB access_log_client_ip_idx| 268 MB access_log_ts_idx1 | 264 kB
同一个 ts 列:B 树 214MB,BRIN 264KB——差三个数量级,因为 BRIN 只记每 64 页的最小最大值。代价出现在查询选择度上:B 树精确定位命中页,BRIN 给出"候选段"后仍要段内扫描。时间范围查询命中最近数据时 BRIN 候选段极少,几乎追平 B 树;查"三个月前的某一天"(历史段被回填过)时候选段变多,差距拉开。这组数字应当刻进选型直觉:BRIN 便宜到可以随手建,但要核对数据物理顺序与查询模式是否匹配。
BRIN 失效的现场复现
把同一批数据随机顺序插入(模拟乱序到达),BRIN 的摘要立即失真——每段的 min/max 都覆盖全时间范围,任何查询的候选段都是全部段。此时 EXPLAIN 里 BRIN 索引"被使用了",但实际扫描量与全表扫无异,比没有还多一层索引开销。这是 BRIN 最险的地方:失效是静默的,计划看起来正常,只有 buffers 计数暴露真相。防护手段:乱序明显的表要么重建索引(BRIN 重建极快),要么老实回 B 树;判断依据是 pg_stats 里该列的 correlation(物理相关度,越接近 1 越适合 BRIN,接近 0 则放弃)。
-- 选型前先看这一列的物理相关度 SELECT attname, correlation FROM pg_stats WHERE tablename = 'access_log' AND attname = 'ts';
HASH 索引的复活与现代定位
HASH 索引历史上背过"崩溃后失效、不被复制"的恶名,那是一零年代的老黄历——现代版本里它已是日志化的成熟结构。但它的定位从未变过:只在"键长且只做等值"时才可能赢过 B 树。等值场景下两者性能差距通常在两三成以内,而 HASH 不支持唯一约束与范围;因此它的适用面极窄——超长随机键(如令牌、指纹)的等值探测,且该表没有范围需求。工程上的替代方案是"表达式索引缩短键"(4.3 节的 md5 方案),往往比直接上 HASH 更稳妥。把 HASH 看成工具箱角落里的专用扳手:知道它修什么,但别第一个伸手拿它。
本节要点回顾
- HASH 等值专用,体积小但无范围无唯一
- GiST 谓词框架,地理与近邻的不二人选
- SP-GiST 前缀分区,IP 与字符串前缀利落
- BRIN 赌物理相关性,时序大表的性价比之王,随机写入则失效