6.2 隔离级别在 PostgreSQL 里的真实含义
6.2 隔离级别在 PostgreSQL 里的真实含义
本节摘要:PostgreSQL 实现四个标准隔离级别,但底座是 MVCC 快照:读已提交每条语句拍新快照,可重复读整个事务一张快照,串行化在快照之上再加"危险结构"检测并回滚冲突事务。脏读在任何级别都不存在;标准里的"幻读"在可重复读下也不会出现——这是快照语义的馈赠,代价是序列化冲突要靠重试消化。
级别与快照的对应表
| 级别 | 快照粒度 | 不可见的现象 | 仍会发生 |
|---|---|---|---|
| 读未提交 | (等同于下一行) | 脏读(实现上不存在) | 不重复读、幻读 |
| 读已提交(默认) | 每语句一张 | 脏读 | 不重复读、幻读 |
| 可重复读 | 每事务一张 | 脏读、不重复读、幻读 | 写偏斜(序列化异常) |
| 串行化 | 快照 + 冲突检测 | 以上全部 | ——(冲突方被回滚重试) |
两个事务的实验,一图胜千言:
-- 默认读已提交下 BEGIN; SELECT sum(amount) FROM account WHERE uid = 1; -- 返回 100 -- 另一会话: UPDATE account SET amount = 300 WHERE uid = 1; COMMIT; SELECT sum(amount) FROM account WHERE uid = 1; -- 返回 300:同一事务两次读不一样 COMMIT; -- 换成 REPEATABLE READ 再试:两次都返回 100,世界定格在 BEGIN 时刻
读已提交还有个隐蔽行为:UPDATE 重新读目标行。事务 A 更新某行时,若该行刚被已提交的 B 改过,A 的 UPDATE 会在新版本上重新评估 WHERE 条件——同一条语句用了两张快照,这是 EvalPlanCheck 机制的直接后果,也是"为什么我的 UPDATE 看到的数据和 SELECT 不一样"的答案。
串行化:用回滚换严格
串行化快照隔离(SSI)不靠加锁排队,而是追踪读写之间的依赖:当检测到"两个并发事务的读写依赖可能构成非串行化结果"(危险结构)时,主动中止其中一个,应用层重试。
BEGIN ISOLATION LEVEL SERIALIZABLE; SELECT count(*) FROM ward WHERE nurse_on_duty; -- 读 -- 若并发事务也读了同一批行并先提交了写 UPDATE ward SET nurse_on_duty = false WHERE id = 3; COMMIT; -- 可能收到 could not serialize 异常 → 应用捕获并重试整个事务
代价清晰:冲突热点高时重试风暴会压垮吞吐。它的正确场景是普通快照隔离下会出现写偏斜的正确性敏感业务(值班表、余额约束类),而不是拿来当性能开关。
图:写偏斜——可重复读防不住的异常
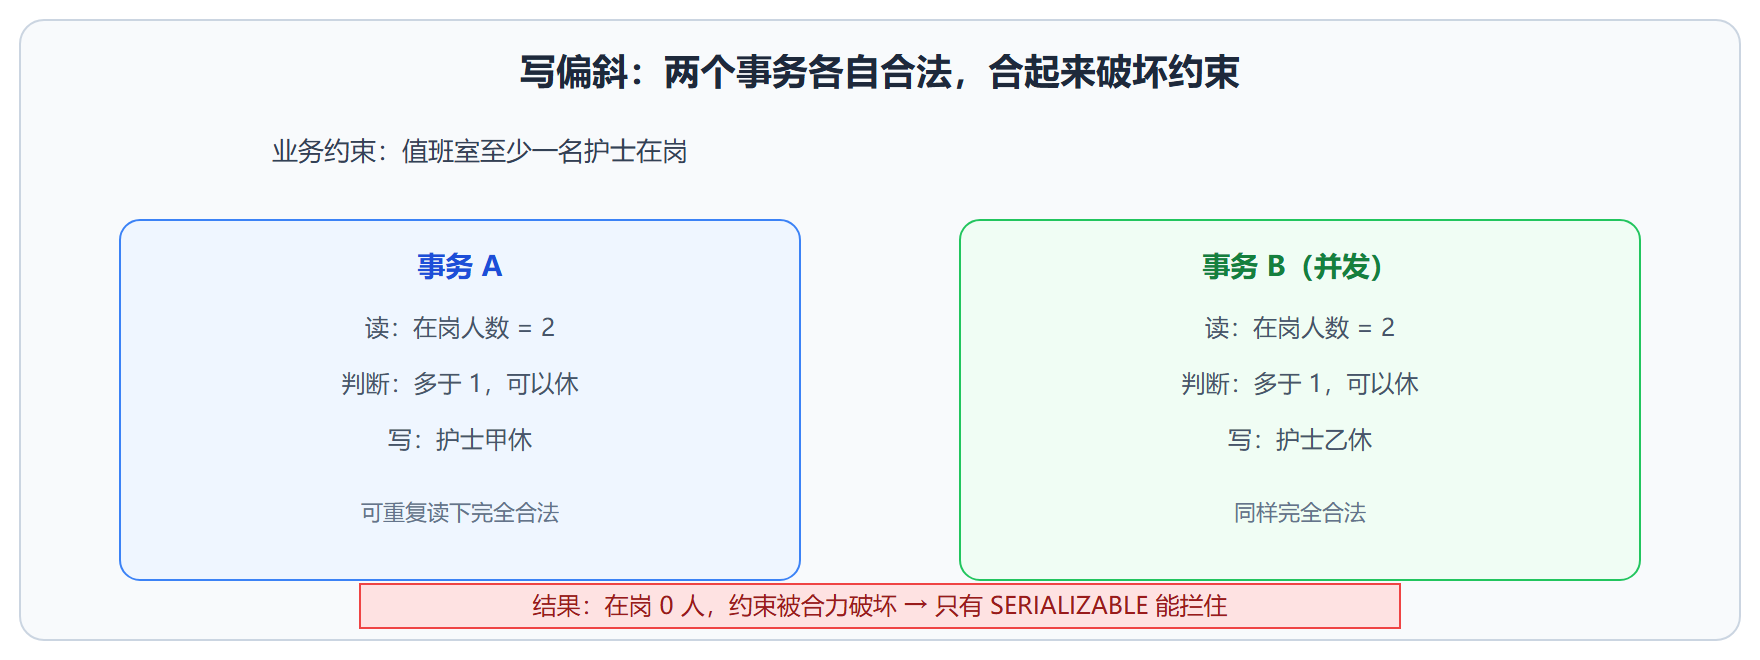
💡 关键直觉:PostgreSQL 的隔离级别本质是"快照的新鲜度"加"是否检测危险结构"。选级别的依据是业务能否容忍哪种异常,而不是级别越高越高级——默认的读已提交适合绝大多数 Web 业务。
串行化冲突的实测与重试纪律
串行化的回滚不是理论威胁,写一个两事务交错就能实测:
-- 会话 A BEGIN ISOLATION LEVEL SERIALIZABLE; SELECT count(*) FROM ward WHERE nurse_on_duty; -- 读:1
-- 会话 B BEGIN ISOLATION LEVEL SERIALIZABLE; SELECT count(*) FROM ward WHERE nurse_on_duty; -- 读:1 UPDATE ward SET nurse_on_duty = false WHERE id = 2; COMMIT; -- B 先提交成功
-- 回到会话 A 完成对称的写 UPDATE ward SET nurse_on_duty = false WHERE id = 3; COMMIT;
ERROR: could not serialize access due to read/write dependencies among transactions
A 的提交被拒——它读过的世界已经被 B 改写,两者串行执行不可能都成立(业务约束"至少留一名值班护士"被并发绕过,正是写偏斜的原型)。应用侧的纪律由此产生:串行化下每个写事务都要包一层捕获重试,指数退避,并设最大重试次数;没有这层包装就开串行化,等于把正确性换成了随机报错。
级别选择的决策路径
四级别的选择可以走一条务实路径。第一问:业务能否容忍同事务内两次读到不同值?绝大多数 Web 业务(读展示、写各自独立)可以,留在默认读已提交。第二问:是否存在"读后按读到的值做条件写"的逻辑(余额、库存、配额)?有,且冲突低频——把条件写改成单条原子语句或 SELECT FOR UPDATE,仍不必换级别。第三问:约束跨多行且并发绕过会造成资损(值班、对账、审计类)?这才考虑可重复读或串行化,前者防读取漂移,后者防写偏斜但要配重试。跳过前两问直接拉高级别是常见反模式:快照旧了读到的数据更陈旧,序列化冲突的重试还会放大负载——级别是正确性工具,不是性能旋钮。
概念辨析:两条"可重复读"血统
标准 SQL 的可重复读允许幻读,PostgreSQL 的可重复读不允许——这不是实现瑕疵而是快照语义的天然延伸:事务级快照下,后插入的行 xmin 晚于快照上界,物理上就不可见,防幻读不需要任何额外工作。反过来,标准定义里可重复读"应该出现"的幻读在 PostgreSQL 要主动降级才能复现(退回读已提交)。迁移团队从其他引擎转来时,最需要校准的正是这份差异表:同一级别名下,不同引擎兑现的异常集合并不相同,跨库迁移的隔离审查应当以"防什么异常"为清单,而不是以级别名为清单。
级别切换的成本账
切换隔离级别不是免费的。读已提交升到可重复读,每个事务持有的快照从"一条语句的寿命"延长到"整个事务的寿命"——事务越长,VACUUM 需要保留的死元组越多,这是把 2.3 节的长事务税进一步放大。串行化再加一层:每个事务要在共享内存里登记读写依赖追踪结构(活跃事务两两之间的依赖边),并发事务数量巨大时这层簿记本身消耗 CPU 与内存,监控视图里表现为 SSI 相关的等待事件占比上升。
实务上的组合拳因此常见两种:全库保持读已提交,仅对少数正确性敏感的业务表的操作走显式串行化事务;或整库可重复读加应用侧原子写改造,完全不开串行化。两种都比"整库拉满串行化"活得舒服。隔离级别的成本不是查询变慢那么线性,它是"快照寿命、依赖追踪、重试风暴"三张账单一起到付,升级级别前把这三张账单都过一遍,才不会按下葫芦浮起瓢。
本节要点回顾
- 脏读从未存在:MVCC 天然免疫,读未提交只是别名
- 默认读已提交:语句级快照,两次读可能不同
- 可重复读:事务级快照,防住幻读但防不住写偏斜
- 串行化 = 快照 + 回滚重试:正确性敏感场景专用,应用必须处理重试