7.3 R学习路径与常用包速查
7.3 R 学习路径与常用包速查
本节摘要:结案不是终点。本节按三种身份给出后续路线——学生打语法地基、业务分析师练工具链、研究者攻统计建模——并附一张常用包速查卡与获取帮助的标准动作,把"接下来学什么"变成可以勾选的清单。
三条身份路线
学生 / 转行入门者:先把本册第 1、2 章的语法与清洗练到肌肉记忆,再补概率统计基础(不然第 5、6 章的检验与回归只是"会用函数"而非"懂原理")。里程碑:独立完成一份"导入到报告"的小案卷。
业务分析师:工具链是重点——dplyr 与 tidyr 的整理功夫、ggplot2 的表达功夫、R Markdown 的交付功夫,三者形成闭环即可覆盖日常八成需求。进阶方向是把周报参数化,把自己从重复劳动里赎出来(第 7 章第 2 节的做法)。
统计 / 科研方向:本册只到回归与逻辑回归的门口。往里走是混合效应模型、生存分析、贝叶斯方法,配套的建模生态与出版物级排版工具都值得投入;再往机器学习方向则衔接第 6 章第 3 节的选型档案。
常用包速查卡
数据导入 readr · haven · readxl 数据整理 dplyr · tidyr · data.table 可视化 ggplot2 · corrplot · patchwork · plotly 建模 MASS · glmnet · nnet · rpart · lme4 报告交付 rmarkdown · knitr 质量保障 testthat · lintr
(包名皆为公开生态中的工具,用途即检索关键词。)
获取帮助的标准动作
?median # 函数说明书 ??robust regression # 关键词全文检索 example(mean) # 直接跑示例代码 args(t.test) # 只看参数表
报错信息本身就是文档:把错误原文拿去检索,通常前几条就是对症答案。读源码也不神秘——包中函数按名字直接敲出来就能看到定义,这是理解作者意图最硬的证据。
能力自检清单
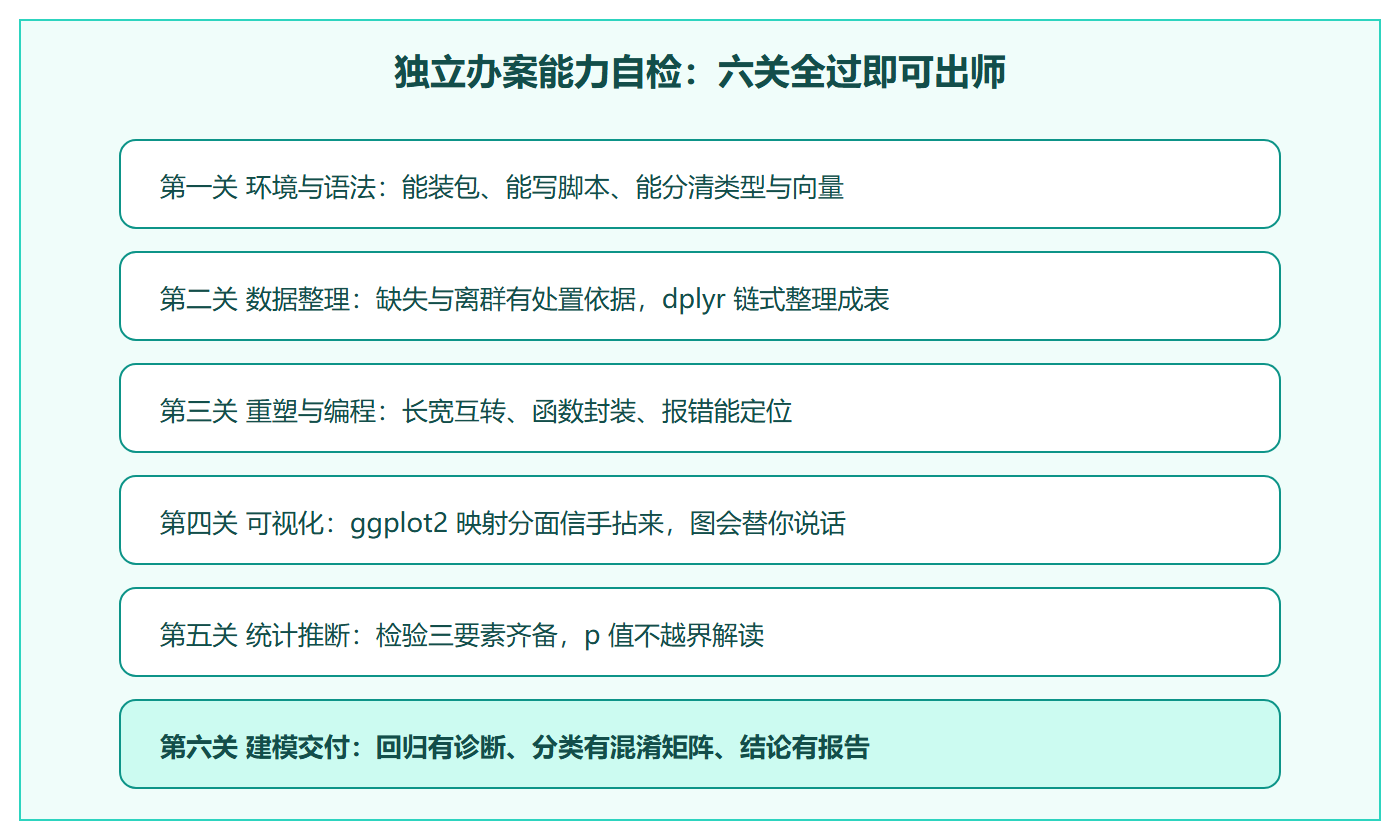
💡 关键直觉:学习路线不是直线而是螺旋——每接一个新案卷,前五关都会被重新过一遍,但每次都过得更深。与其囤教程,不如持续接真案子:数据就在那里,等你开工。
十二周训练计划:从结案到独立办案
把三条路线折成一份可勾选的十二周计划,每周一个交付物:
第 1-2 周 重跑鸢尾花案与乘客名单案,不看教程独立复现 交付:两份带注释的脚本 第 3-4 周 找一份自己领域的真实 CSV,完成导入到清洗 交付:问题清单与干净数据集 第 5-6 周 用 ggplot2 给清洗结果出四张定稿图(分布、关系、组差、相关矩阵) 交付:一张 patchwork 图墙 第 7-8 周 对一个两群体差异做完整检验,按三要素格式写结案 交付:一页检验报告 第 9-10 周 拟合一个回归模型并完成四联诊断与留出验证 交付:模型卡(系数、诊断、误差三段) 第 11-12 周 用 R Markdown 把以上全部组装成参数化结案报告 交付:可一键重渲染的卷宗
这份计划的关键在"每周有交付物"——R 的技能只在产出物里沉淀,看不坏教程,只看教程等于没学。十二周后你手里应有一份完整的个人办案档案,求职与述职都比"学过 R"三个字有说服力得多。
函数提速卡:高频函数的进阶替代
| 基础函数 | 进阶替代 | 适用场景 |
|---|---|---|
| sapply | vapply | 要类型保证的生产代码 |
| ifelse 长链 | case_when 或 dplyr 的 if_else | 多分支派生 |
| 中括号逐列处理 | across 配 tidyselect | 批量同型变换 |
| for 拼结果 | purrr 的 map 系列 | 函数式批量 |
| setwd 相对路径 | here 包定位 | 项目可移植 |
替换的原则不是追新,而是当旧写法开始"疼"(报错难查、代码难读、换目录就崩)再换。比如 map 系列的价值在类型稳定与管道衔接,一两处 sapply 不必动;而项目一旦多人协作,here 包几乎是必需品。
读源码与读报错:两条硬核求助路
# 看一个函数的真身:直接敲函数名(不加括号) t.test # 泛型则先 methods 列方法,再看具体实现 methods(summary) getS3method("summary", "lm") # 报错复现的最小化:把出问题的代码剥到最小可复现 # 三行以内仍报错,病因已经暴露一半
读源码是 R 的独特福利——核心包全是 R 代码写就,敲个函数名就能看到作者怎么处理边界。把"读源码"当求助的最后一级:问号文档、关键词检索、示例代码、报错原文检索、源码,五级火箭逐级点火,绝大多数问题在第二三级就已解决。
结业自测:七问对答
合卷前用七个问题做一次全册体检,每题都应能不假思索地答出要点:
- 向量混入一个字符会发生什么?为什么?——整条降级为 character,同类型铁律。
- 缺失值处理的三种策略与各自代价?——删行损样本、插补压方差、成类需转因子。
- 长表与宽表各自的"主场"?——分组汇总与映射上色用长表,人眼横比与互通表格用宽表。
- 分面解决什么问题?——把类别变量拆成小图阵,拆穿混杂制造的错觉。
- 配对设计与独立样本检验用错会怎样?——个体差异计入噪声,证据强度打折。
- 残差图弯曲说明什么、怎么处置?——线性假设报警,加二次项或取对数。
- R Markdown 为什么能保证报告与证据同步?——渲染时代码现场执行、结果现场嵌入。
七问全过,这本手记可以真正合上了;哪问卡壳,回对应章节的易错点地图再走一遍。
一张按季更新的建议:每年回头重做一遍七问自测,并挑当时最生的一问对应章节重跑代码——R 的生态每年都在变,速查卡里的包名也可能换代,但"证据、口径、可复现"三条主线不会过时。把本页当年度复训的起点,手记的生命周期就延伸下去了。
本节要点回顾
- 三条身份路线:学生补地基、分析师练闭环、研究者攻建模
- 速查卡七类:导入、整理、可视化、建模、报告、质量保障
- 帮助四动作:问号、双问号、example、args
- 报错原文即检索词:第一手资料往往就是答案
- 读源码是最后一级求助:泛型先 methods 再取实现
- 螺旋式成长:案子驱动学习,六关反复过、越过关越深
- 按季复训:每年重做七问自测,手记生命周期延伸下去