1.3 第一份判词:HelloWorld与编译流程
1.3 第一份判词:Hello World 与编译流程
本节摘要:解剖最短的 Rust 程序,讲清 fn main、宏调用、分号与花括号的规则;再给出一幅编译流水线图,标出"借用检查"发生在哪一站。读完你对"代码怎么变成可执行文件、法官在哪一步介入"有完整地图。
最短程序的解剖
fn main() { println!("Hello, World!"); }
四件事各就各位:
fn main()是入口函数,程序从这里开始执行,无参数无返回值;println!是宏而不是函数——感叹号是宏调用的制服。为什么是宏?因为格式化参数要在编译期检查,函数做不到,宏在第 9 章开庭;- 分号把语句隔开,花括号界定作用域——作用域正是后面所有权释放的"结案时刻";
- 字符串字面量是
&str类型,存在程序只读区,细节第 2、4 章展开。
编译流水线
图:从源码到可执行文件的五站
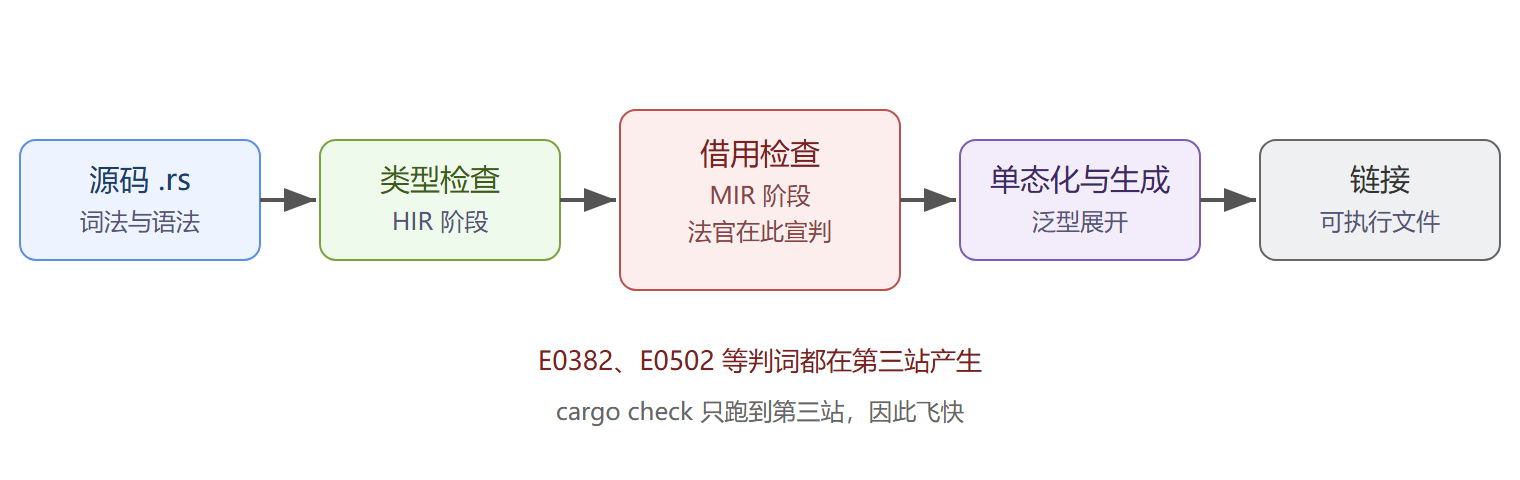
法官(借用检查器)工作在 MIR 中间表示上,位于类型检查之后、代码生成之前。这就是为什么 Rust 报错总在"跑之前"——判决本就排在执行前面。
故意输一场:见识判词格式
把下面这段放进 main 里编译一次,值得逐行读报错:
let s1 = String::from("证物"); let s2 = s1; println!("{}", s1.len());
判词分四段:错误编号(E0382)、出错位置、原因陈述(value borrowed here after move)、修复建议。Rust 的报错常直接给出候选改法,读报错的能力从此开始练。
💡 关键直觉:把编译器当对手是错的,把它当最严格的代码评审员——它不通过的代码,事故率确实更高。
从源码到二进板的五道工序
HelloWorld 虽小,rustc 内部的流水线一步不少。理解每道工序的产物,后面遇到"类型不匹配""借用冲突""链接失败"时才知道该在哪道工序里找证据。
main.rs │ ① 解析:词法+语法 → AST │ ② 展开:处理宏与 derive → 完整 AST │ ③ 类型检查与借用检查 → HIR 上标注判决 │ ④ 中端优化(MIR)→ 借用检查在此执行 │ ⑤ 代码生成 → LLVM → 目标文件 → 链接 → 可执行文件
关键认知有两点。其一,宏展开发生在类型检查之前,所以宏看不到类型,只做文本级的规则替换——第 9 章会回到这一点。其二,借用检查跑在 MIR 上,基于控制流图而非文本顺序,这就是为什么"先写可变借用后写读取,但读取在控制流上更早"能通过检查:NLL 按实际执行顺序判案。
不经 Cargo 的直接开庭
单文件实验可以绕开 Cargo 直接找 rustc,体会两件事:编译期检查与链接期检查是分开的。
$ rustc --edition 2021 probe.rs -o probe && ./probe warning: unused variable: `exhibit` --> probe.rs:3:9 3 | let exhibit = 1; | ^^^^^^^ help: try `_exhibit` error[E0308]: mismatched types --> probe.rs:4:24 | 4 | let n: i32 = "证物"; | -- ^^^^^^ expected `i32`, found `&str`
错误信息的三段结构(结论、位置、期望对实际)是所有 E 编号的通用格式,越早习惯读原文越好。若报错落在 cannot find crate 一类,则是第 ⑤ 道链接工序的问题,跟类型判例无关。
审判记录:cargo run 背后发生了什么
cargo run 不是解释执行,它等价于"若源码比产物新则重新编译,然后运行产物"。判断依据是 target 目录里的文件指纹(Fingerprint)。由此可以解释两个日常现象:改了非本项目代码却不生效,多半是依赖被缓存锁定,需 cargo build -p 依赖名;而在 CI 里想全量重审,cargo clean 清空整个档案室即可。把 HelloWorld 项目里加上一条打印语句再运行,观察"Compiling / Finished / Running"三行日志的次序,这道工序就落地了。
判读报错的四个固定动作
面对任何一条 E 编号报错,动作顺序固定成习惯后,排错就从考古变成流程。第一步读首行结论句,用一句话向自己复述"什么错了";第二步看位置标注的行号与箭头,确认现场是定义处还是使用处;第三步读"期望与实际"对照表,类型不匹配类报错的答案几乎总在这里;第四步才看建议改法,并判断它是否符合你的真实意图——编译器建议"加 clone"时,很多时候正确答案其实是改借用。建议只是建议,采纳前先过一遍第 3 章的产权思维,否则容易养成见红就 clone 的坏习惯。
一个刻意制造的五连报错练习
新建空项目,在 main 里依次写下这五行,每写一行编译一次,收集五条报错:给变量标错类型(E0308)、把 String 赋给另一个变量后再用原变量(E0382)、对不可变变量调用 push_str(E0596)、match 少写一个分支(E0004)、调用未定义函数(E0425)。五条报错覆盖类型、所有权、可变性、穷尽性、解析五个方向,是全书后续所有章节报错的索引样本。做完这个练习,第 2、3 章的学习速度会明显加快——因为你已经见过判词的格式,剩下的只是补法条本身。
判例档案:一次完整的报错结案过程
下面这条真实报错值得逐段精读,它是"期望与实际"格式的标准样本。
error[E0308]: mismatched types --> src/main.rs:4:24 | 4 | let total: u32 = items.len(); | ----- ^^^^^^^^^^^^ expected `u32`, found `usize` | | | expected due to this | help: you can convert an `usize` to a `u32` and panic if the converted value doesn't fit | 4 | let total: u32 = items.len().try_into().unwrap(); | ++++++++++++++++++++
四个信息区依次是:编号与结论、现场行号、期望对实际(含归因箭头)、建议改法。这条报错的建议是 try_into 加 unwrap——采纳与否要看语境:容器规模受控时可以,处理外部数据时应改为返回 Result 的 try_into 并传播错误。养成"先读归因、再审建议"的顺序,编译器就从对手变成合议庭。
增量编译的观察练习
在 HelloWorld 项目里连续运行三次 cargo build,观察日志差异:第一次列出全部 Compiling,第二次若未改代码只有 Finished,第三次改一行注释再编译——只有本包重编,依赖不动。这个三分钟的观察建立对增量编译边界的直觉:以 crate 为最小单位,包内任何改动触发整包重编,这正是第 7 章讨论"何时拆 crate"的物理基础。理解了这一点,大项目上"改一行等五分钟"的现象也就有了诊断方向。