5.2 泛型:通用条款与单态化
5.2 泛型:通用条款与单态化
本节摘要:泛型让一份代码服务多种类型,Trait 约束声明通用条款的适用范围;编译期单态化为每个实际类型生成专用代码,抽象零运行时成本。读完你能写出带约束的泛型函数与结构体,并解释"泛型不比手写慢"的原因。
从重复到通用
fn largest_u32(list: &[u32]) -> u32 { ... } fn largest_char(list: &[char]) -> char { ... } // 复制粘贴的案发现场
合并成泛型版本,约束写明"要比大小":
fn largest<T: PartialOrd>(list: &[T]) -> &T { let mut max = &list[0]; for item in &list[1..] { if item > max { max = item; } } max }
约束三写法:尖括号内 T: PartialOrd、where 子句(约束多时更清晰)、impl Trait 参数位置(fn print(s: impl Display),简洁但不可指名 turbofish 调用)。多重约束用加号:T: PartialOrd + Clone。
泛型结构体与方法
struct Vault<T> { items: Vec<T> } impl<T: Clone> Vault<T> { fn duplicate_first(&self) -> Option<T> { self.items.first().cloned() } } let v = Vault { items: vec![1, 2, 3] };
impl<T> 里的 T 与结构体的 T 对应;也可以为具体实例化单独实现(impl Vault<u8>),这是泛型特化的粗粒度替代。
单态化:零成本的机制
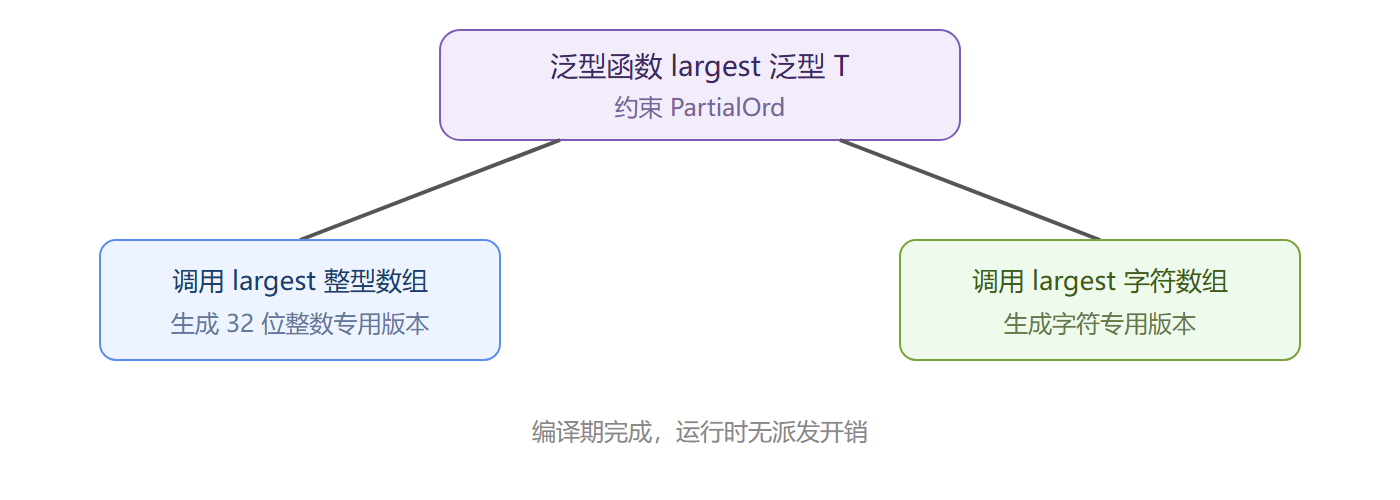
第 1 章编译流水线的第四站在做这件事:largest 被 u32 与 char 调用时,编译器生成两份机器码。代价转移到编译时间与二进制体积,运行时与手写两份函数完全一致。这解释了 Rust 的泛型为什么不拖性能,也解释了为什么泛型函数在库里大量存在而调用方毫无感知。
图:单态化展开示意
要点回顾
- 约束声明契约,无约束的泛型几乎什么都干不了,这不是限制而是文档;
- 三种约束写法按复杂度选用;
- 单态化让泛型性能等同手写专用代码,代价是编译时间;
- impl Trait 参数是最轻量的泛型入口,返回位置的 impl Trait 则承诺"某个实现了该契约的类型"。
单态化:通用条款的执行方式
泛型不是运行期多态。编译器为每个实际用到的类型生成一份专属代码,这叫单态化——零抽象成本的理论根基,也是泛型库编译变慢的元凶。
fn larger<T: PartialOrd>(a: T, b: T) -> T { if a >= b { a } else { b } } fn main() { println!("{} {}", larger(9u32, 4), larger('甲', '乙')); // 编译产物里实际存在两份 larger:larger_u32 与 larger_char let nums = vec![3u8, 1, 2]; println!("{:?}", nums.iter().copied().fold(u8::MIN, larger)); // 显式选用 u8 版 }
E0308 出庭时注意读"期望与实际"里的类型参数:larger(1u8, 2u16) 报错不是说泛型不能用,而是 T 只能绑定一个具体类型。现场写法 larger::<u32>(a, b) 的 ::<...> 被称作 turbofish,在 collect 等推断不出目标类型的场合是法定补救。
约束的三种写法与 where 子句
use std::fmt::Debug; use std::hash::Hash; // 内联写法:适合一两个约束 fn dup<T: Clone>(v: &T) -> T { v.clone() } // where 写法:约束多、嵌套深时仍可读 fn index_of<T>(items: &[T], key: &T) -> Option<usize> where T: PartialEq + Debug + Hash, { items.iter().position(|x| x == key) } fn main() { let codes = [101u32, 102, 103]; println!("{:?}", index_of(&codes, &102)); println!("{}", dup(&String::from("原件"))); }
约束写多厚要克制:每个约束都是对调用方的一道要求。实践中优先选最弱约束——只需要判等就写 PartialEq,不要顺手加 Eq;只需要读就写 &[T],不要拿走 Vec。泛型 API 的质量几乎就等于约束清单的精确度。
常量泛型:把长度写进类型
struct Sealed<const N: usize> { cells: [u8; N], } impl<const N: usize> Sealed<N> { fn full(&self) -> bool { self.cells.iter().all(|&b| b != 0) } } fn main() { let a = Sealed { cells: [1, 2, 3] }; // Sealed<3> let b = Sealed { cells: [1, 0] }; // Sealed<2>,与 a 不同类型 println!("{} {}", a.full(), b.full()); }
定长数组由此摆脱"长度不同的数组是不同类型导致泛型难写"的老麻烦,嵌入式缓冲、密码学分组这类长度敏感的场景收益最大。注意 Sealed<3> 与 Sealed<2> 是完全不同的类型,互相赋值会 E0308,这是特性而非缺陷。
一道泛型综合判例
use std::fmt::Display; fn report<T, U>(first: T, second: U) -> String where T: Display + PartialOrd, U: Display, { if first >= first { format!("{} 与 {}", first, second) } else { unreachable!() } } fn main() { println!("{}", report(9u32, '甲')); println!("{}", report("卷宗A", 173)); }
这份代码的可取之处在签名:两个类型参数、各自最小约束、where 排版。要挑剔的是 first >= first 这种自比——它只为了用上 PartialOrd,真实代码应比较两个同类型入参。练习:把签名改成比较两个 T 并返回较大者的 Display 字符串,保持最小约束原则。泛型设计的成熟度就看约束清单:每一条都说得出"为什么必须有",就是合格线。