1.1 为什么Scala值得攀:语言定位与环境搭建
1.1 为什么 Scala 值得攀:语言定位与环境搭建
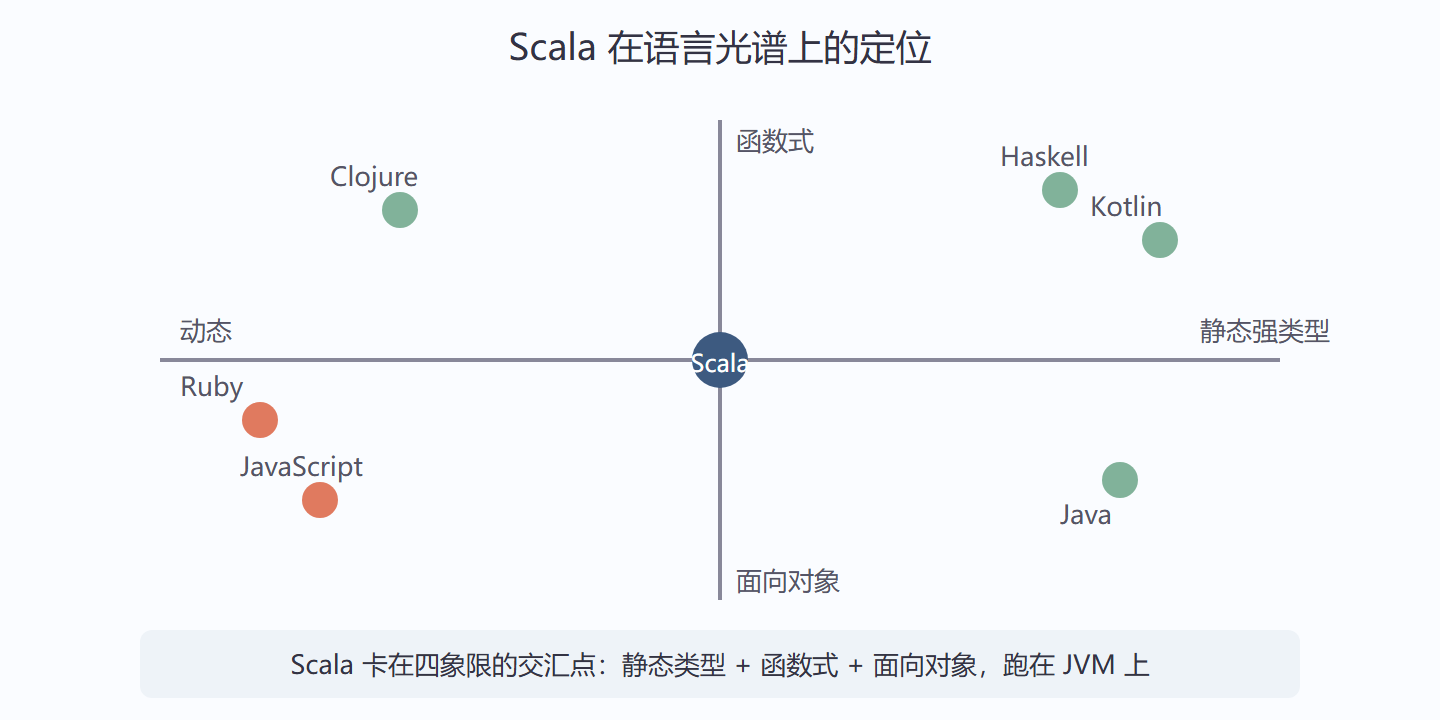
Scala 是 2004 年由 Martin Odersky 创建、运行于 JVM 的多范式语言,与 Java 无缝互操作,同时提供函数式编程的完整能力。本节交代它的定位、版本分野(Scala 2 与 Scala 3),并完成环境搭建。
从一次迁移说起
Twitter 在 2009 年前后把核心搜索从 Ruby 迁到 Scala,理由不是语法漂亮,而是:既有 JVM 的运维体系与库生态,又能用不可变数据与 Actor 应对高并发。这个组合至今没有替代品——Kotlin 取了简洁但收敛了类型表达力,Haskell 表达力强但进不了存量 JVM 系统。Scala 的定位就在这条窄缝里。
三个我认为值得学的理由:
- 类型系统是全行业的天花板之一,学懂它再学 Kotlin、Swift、Rust 的类型特性都是降维。
- Spark、Flink、Akka、Kafka 生态里 Scala 仍是第一公民,大数据岗位绕不开。
- 函数式 + 面向对象双范式在一个语言里共存,能训练"按问题选范式"的判断力。
Scala 在语言生态里的坐标
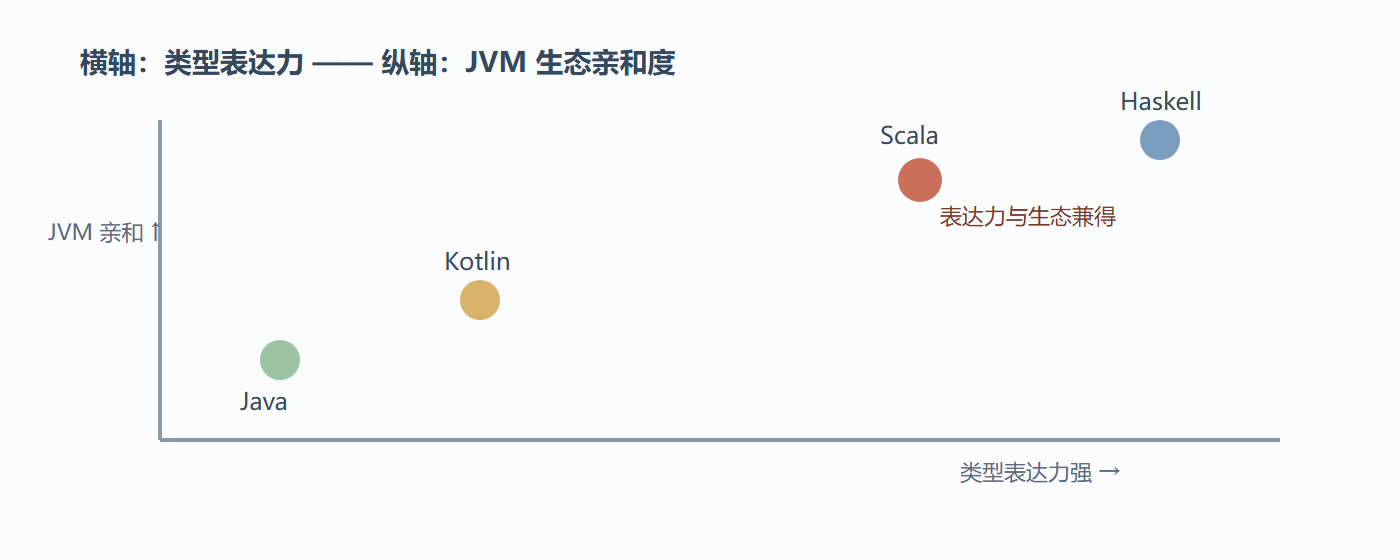
版本上直接选 Scala 3。Scala 2.13 与 3 可以混编译,老资料大多能对照理解,差异点(given/using 替代 implicit)本书第五章会专门讲。
环境搭建:三条路
| 方式 | 适合 | 说明 |
|---|---|---|
| coursier 安装器 | 日常开发 | 一条命令装齐 scala、sbt、scalafmt |
| 手动安装 | 受限环境 | 装 JDK 8 以上 + 官方发行包 |
| 在线 scastie | 零安装体验 | 浏览器里直接跑,适合前两章练手 |
用 coursier 的话,装完在终端验证:
java -version # 需要 JDK 8+ scala -version # 应显示 Scala 3.x sbt about # 构建工具就绪
IDE 两选一:IntelliJ IDEA 装 Scala 插件(推荐),或 VS Code 装 Metals 扩展。两者对 Scala 3 的类型推导展示都已成熟。
第一个程序:REPL 优先
不建议从"新建项目"开始,先打开交互式解释器:
$ scala Welcome to Scala 3. scala> 1 + 1 val res0: Int = 2
注意 REPL 回显的 val res0: Int = 2——它同时告诉你三件事:结果是值、名字、类型。这个回显格式本身就是 Scala 世界观的缩影:每个表达式都有类型,编译器永远知道它。
传统一点的写法:
@main def hello(): Unit = println("Hello, Scala")
@main 注解是 Scala 3 生成程序入口的方式,不再需要旧教程里 object Hello extends App 的样板。
常见问题
编译很慢? Scala 编译器确实比 javac 慢,这是类型推断与宏展开的代价。工程上用增量编译(sbt 默认开启)缓解,第五章之后你会理解这代价买来了什么。
该学 Scala 2 还是 3? 新项目无脑 3;读老代码需要认识 2 的语法,本书会在差异处标注。
图 1-1 Scala 在语言光谱上的定位
第一次启动:REPL 里的三分钟
环境装好后,终端敲 scala 进入 REPL(Scala 3 默认带彩色输出与 Tab 补全)。先做三件事,确认一切正常:
scala> 1 + 2 val res0: Int = 3 // 每个表达式都有值、有类型 scala> "abc".map(_.toUpper) val res1: String = ABC // 字符串也是集合,直接 map scala> :type List(1, 2, 3) List[Int] // :type 只问类型不求值
三个输出各有讲究:res0 证明"一切都是表达式";res1 预告了第四章的集合统一操作;:type 是你以后爬类型系统主峰时最常用的探针。退出用 :quit,多行粘贴用 :paste 模式,否则缩进会被逐行解释报错。
常见的第一天报错
- scalac 不是内部或外部命令:PATH 里没有 bin 目录,回到 Coursier 的 setup 确认安装路径。
- 找不到或无法加载主类:JDK 版本过低(Scala 3 要 8 以上,建议 17),java -version 先查一遍。
- sbt 第一次启动长时间卡住:它在下载依赖与编译本身,挂上镜像仓库配置后重试即可,不是装错了。
这些坑都过一遍,山脚营地才算扎稳——后面所有章节默认你已经能在 REPL 与 sbt 之间自由切换。
scala-cli:单文件时代的顺手工具
除了传统的 scala 与 sbt,Scala 3 官方主推 scala-cli 作为轻量入口。它允许在文件头声明依赖,一个 .scala 文件就是一个可运行项目:
//> using scala 3.4.2 //> using dep com.github.tototoshi:scala-csv_3:1.3.10 @main def hello() = println("带着依赖直接跑")
命令行执行 scala-cli run hello.scala,它会解析头部声明、拉取依赖、编译并运行。学习期用它跑例子,进项目再换 sbt(第八章),工具复杂度就不会在第一天挡路。传统 JVM 语系的"先建工程再写代码"在这里被反转成"先写代码,工程按需生长",这也是 Scala 3 吸引新手的实际改进之一。
定位再确认:什么时候不该用 Scala
诚实列出反面:团队全是 Python 数据分析背景、脚本生命周期两周、部署环境只有一台无 JVM 的设备——这些场景 Scala 都是杀鸡用牛刀。它的启动开销(JVM 冷启动)与学习曲线都真实存在。判断标准回到本节开头的定位:当"类型系统带来的重构安全"值钱时,才值得为它付出攀登成本。
再补充一个判断坐标:如果你的项目要同时处理"结构化业务规则"与"海量数据管道",Scala 是少数不用换语言就能覆盖两端的选项——业务侧用类型建模,数据侧直接上 Spark(见第八章生态)。
本节要点回顾
- 定位:JVM 上的双范式语言,价值在类型系统与存量生态的交集。
- 版本:直接学 Scala 3,兼容 2.13 的生态。
- 环境:coursier 一键装齐,REPL 是前几章最好的练习场。
- 回显即世界观:REPL 的"值 + 类型"回显贯穿全书,养成读类型的习惯。