7.1 宏:编译期代码生成
7.1 宏:编译期代码生成
宏在编译期读取代码的形状(AST 与类型信息),生成新代码顶替原处。Scala 3 用 inline + 引用(quotes)重做了整套宏体系,比 Scala 2 的黑魔法清晰一个量级。本节以"读懂并敢用"为目标,不追求"从零写宏"。
从 inline 说起
宏的入口是 inline:
inline def twice(inline n: Int): Int = n + n twice(21) // 编译期直接展开为 21 + 21,乃至常量折叠为 42
inline 保证"调用处展开",inline n 参数要求编译期已知。这是宏的最低一级:零成本的代码粘贴。日志库用它消灭"字符串拼接后才发现日志级别关了"的浪费:
inline def debug(msg: => String): Unit = if Logger.level >= Debug then println(msg) // 级别不够时 msg 根本不求值
再上一级是引用宏——编译器把参数的 AST 交给你,你返回新 AST:
import scala.quoted.* inline def typeNameOf[T]: String = ${ typeNameOfImpl[T] } def typeNameOfImpl[T: Type](using Quotes): Expr[String] = import quotes.reflect.* Expr(TypeRepr.of[T].show) // 拿到 T 的精确类型名,运行期反射做不到
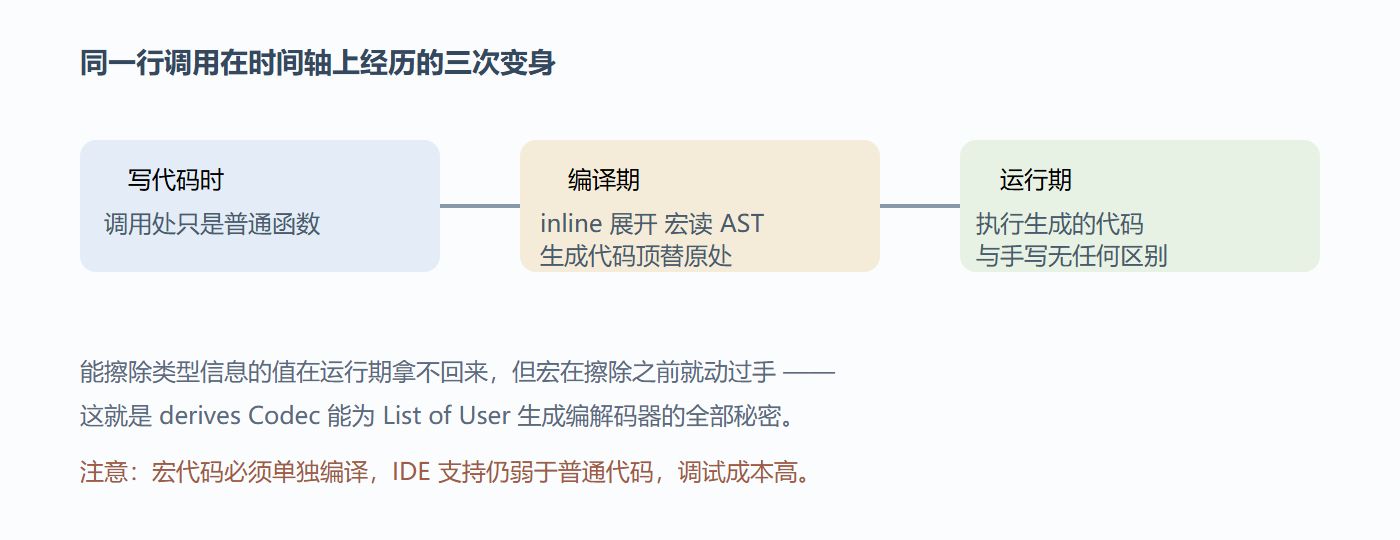
它能实现运行期反射做不到的事:读取只在编译期存在的类型信息(泛型擦除前的参数、样例类字段清单),生成序列化器、equals、验证器。8.3 里的 JSON 库一行 derives Codec 背后正是这套机制在遍历样例类的字段。
宏的三个作用时刻
什么时候别用宏
宏的代价真实存在:错误信息难读、编译变慢、跨编译器版本脆弱(Scala 2 宏与 Scala 3 不互通是当年迁移的最大痛点)。我的决策线:
| 需求 | 方案 |
|---|---|
| 消除调用开销、惰性求值参数 | inline 就够,别上宏 |
| 给样例类派生编解码器/相等性 | 用库的 derives,不手写宏 |
| 读取编译期类型信息做代码生成 | 引用宏,值得 |
| 运行期能用反射解决的问题 | 用运行期反射,别借宏 |
一句话:先用库(别人调试过的宏),其次 inline,最后才是自写宏。元编程是山脊路段,风景好但风大,结伴(用成熟库)再走。
完整案例:用 inline 与宏做编译期日志开关
背景:调试日志要在生产包里彻底消失,运行时 if 判断总归还有一次开销。Scala 3 的 inline 让分支在编译期被裁掉:
import scala.compiletime.* inline def debugLog(inline cond: Boolean)(inline msg: String): Unit = inline if cond then println(msg) else () val verbose = true debugLog(true)("boot ok") // 编译后只保留 println 这一支 debugLog(false)(expensive()) // expensive 调用整棵被删,参数求值也不会发生
操作与结果:inline 参数按调用点字面代入,inline if 在条件为常量时直接丢弃死分支。解读:这是宏体系最安全的入口——不做语法树操作,只做编译期常量折叠,零学习成本换来零运行时开销。变式:把 cond 换成编译期读配置的编译期常量(如 buildLevel),即可做到"一份代码两种发行包"。
Quotes 与 Splices 的分工
真正的宏在编译期拼装语法树:引号 quote 把代码变成 Expr 树,splice $(...) 把树插回代码。典型 Macro.scala:
import scala.quoted.* inline def typeName[T]: String = ${ typeNameImpl[T] } def typeNameImpl[T: Type](using Quotes): Expr[String] = import quotes.reflect.* Expr(TypeShow[T].show) // 编译期取类型名,产出一个字符串字面量
调用 typeName[(Int, String)] 展开后就是字面量 "(Int, String)"——没有任何运行时反射。理解 macros 的钥匙只有一句:引号内是树、splice 是洞,宏就是带洞的树在编译期被填好。
派生宏实战:derives 如何一行搞定 JSON
Circe 的Encoder派生是元编程最成功的落地。手写三个字段的编解码器要二十行,派生只要一个子句:
import io.circe.*, io.circe.generic.auto.*, io.circe.syntax.* case class Reading(day: Int, hour: Int, celsius: Double) derives Encoder.AsObject Reading(182, 14, 36.6).asJson.noSpaces // {"day":182,"hour":14,"celsius":36.6}
背后机制:derives 触发 Encoder.AsObject 的 companion 宏,宏在编译期读取 Reading 的字段清单,逐字段生成编码表达式并拼装成完整编解码器。任何字段改名,生成的 JSON 同步变化,编译期全部对齐——对照 Java 时代注解加反射的运行时惊喜,这是代差优势。同理,5.4 节手写的 Show 类型类也能用 derives 半行接管。
什么时候不该用宏
三条刹车:团队没有第二个人能读懂宏实现时(可维护性悬崖);逻辑本质是运行期数据驱动时(配置解析、规则引擎,宏在编译期无数据可用);调试成本超过收益时(宏展开错误信息常以编译器内部术语呈现)。经验配比:项目里 inline 与 derives 常见,手写 Expr 级宏应当稀有——稀有才是健康信号。
本节要点回顾
- 宏活在编译期:inline 展开是入口,引用宏读写 AST 生成替换代码。
- 独门能力是读取擦除前的类型信息,derives 的全部基础。
- 代价:错误信息、编译速度、版本耦合;Scala 2 与 3 宏不互通。
- 决策线:库优先、inline 次之、自写宏殿后。