8.3 生态选型与社区走向
8.3 生态选型与社区走向
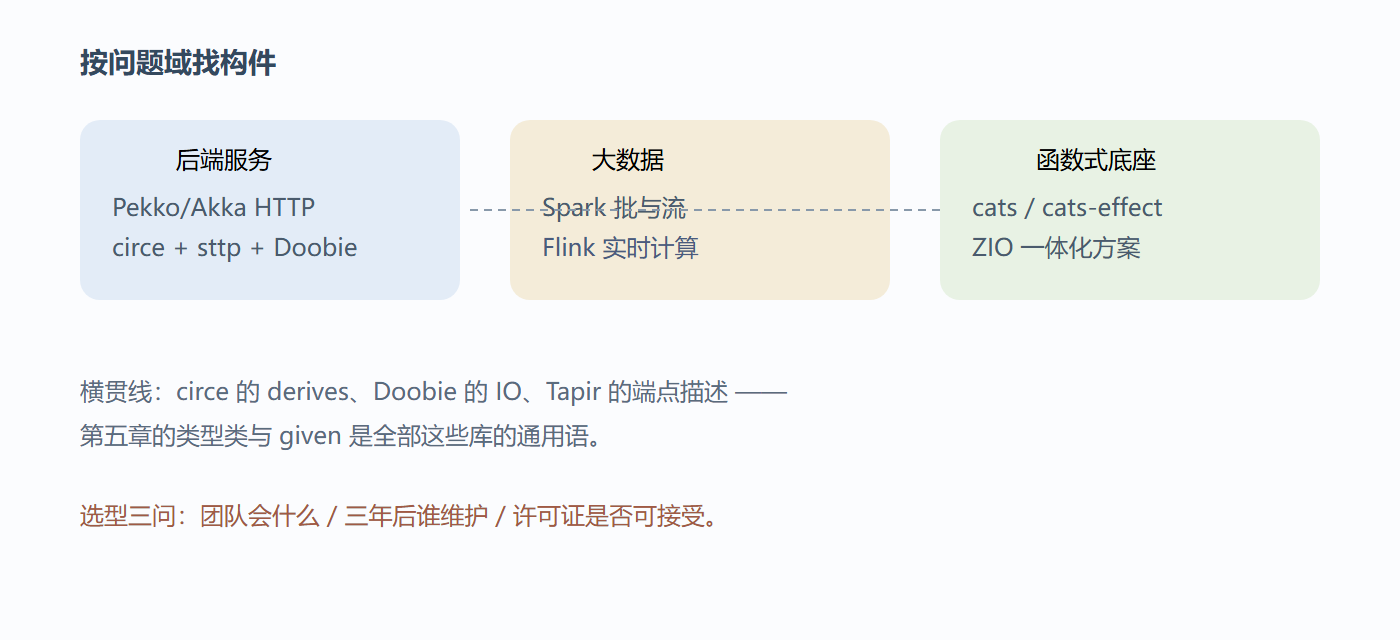
Scala 生态按领域分化清晰:后端服务、大数据、函数式库三条主线各有主力构件。本节给出选型地图与决策线索,并交代 Scala 3 时代社区的重心迁移——这是路线终点的"下山地形图"。
三条主线的构件地图
| 领域 | 主力 | 备选/说明 |
|---|---|---|
| Web 框架 | Akka HTTP / Pekko HTTP | Play 适合全栈,http4s 函数式纯粹派 |
| JSON | circe / upickle | circe 配合 5.4 类型类派生 |
| 数据库访问 | Slick / Doobie | Doobie 建在 cats-effect 上,函数式团队偏好 |
| 大数据 | Spark、Flink | Scala 是两者的原生 API 语言 |
| 并发/流 | Akka / Pekko、ZIO、cats-effect | 见下文取舍 |
| 配置 | PureConfig | 样例类与配置文件的类型安全映射 |
| HTTP 客户端 | sttp | 同步异步多后端一套 API |
Akka 在 2022 年改许可证后,社区孵化了 Apache Pekko(同源分支)——新项目选型时这是必答题:需要商业支持选 Akka,要 Apache 协议选 Pekko,API 几乎兼容。
ZIO 与 cats-effect 的取舍是函数式社区的经典站队:两者都提供"纯函数式的并发与资源管理",ZIO 一体化、学习曲线集中;cats-effect 是类型类风格的标准库底座、组合更碎但更自由。我的建议:新团队从整体框架(Tapir+http4s 或 ZIO HTTP)入手,先跑通再谈纯粹性。
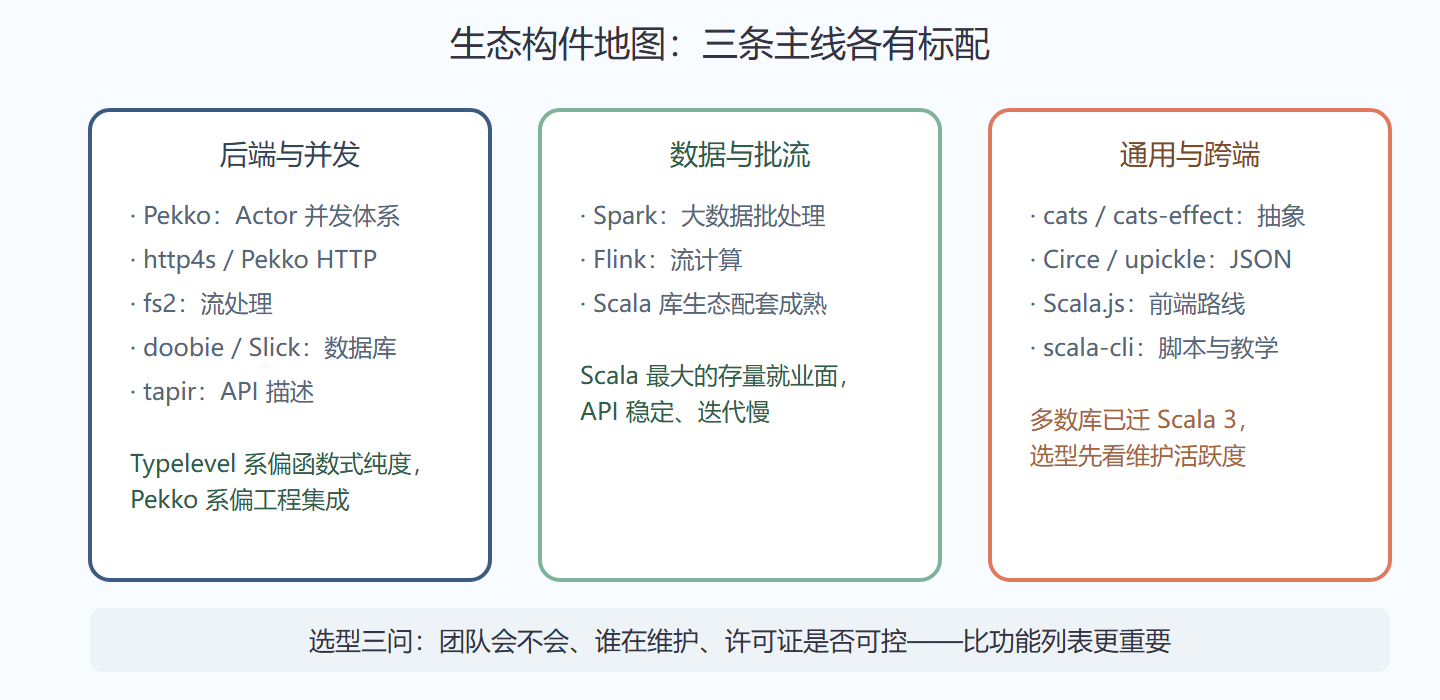
生态地图
社区走向与学习资源分布
Scala 3 已是默认主线:新库(如 http4s 1.x、Tapir)均以 Scala 3 为第一目标、Scala 2.13 兼容发布。语言层面社区在收敛复杂度——given/using 取代 implicit、quiet syntax 降低嵌套噪声,方向是"表达力不变、心智负担下降"。
学习资源的分布特征:官方文档(含 Scala 3 书与导览)质量近年大幅提升;课程以 func-prog 体系(含大学课程)与各库官方教程为主;中文资料相对 Java 稀疏且版本陈旧者多,读时先核对版本是否 Scala 3——这也是这份教程按 3 为主线重写的原因。社区讨论集中在平台特定的几个 Scala 板块与各库的官方讨论区,提问前查库的版本兼容矩阵能省一半周折。
下山之后
路线到终点,攀登没有。三个方向任选:读 cats 源码(类型类的工业级实现)、给 Spark/Flink 项目贡献(第八章工具链实战)、或用 Pekko 搭一个完整服务(全书装备总装)。无论哪条,你在第五章主峰获得的那套类型直觉,都会是其余路线共用的一副好冰镐。
图 8-1 Scala 生态三条主线构件地图
选型实战:三类任务的决策链
用一个简单框架过一遍真实选型。JSON 处理:默认 Circe(派生宏成熟、生态最广),追求极致性能或简单场景选 upickle 或 jsoniter。HTTP 服务:轻量选 sttp(客户端)加 http4s 或 Pekko HTTP(服务端);要 OpenAPI 一体化就上 Tapir。并发与流:标准库 Future 起步,需要背压管道再上 fs2 或 Pekko Streams。三条决策的共同形状:
// 选型不是选最强,是选"最小够用再加一档预留" libraryDependencies ++= Seq( "io.circe" %% "circe-core" % "0.14.x", // JSON:默认项 "com.softwaremill.sttp.client3" %% "core" % "3.9.x" // HTTP 客户端:最小够用 )
反例同样重要:单人小工具上 ZIO 全家桶,维护成本立刻压过收益;团队没有 Cats 功底就全面函数式化,三个月后没人敢改代码。生态选型的第一原则是"团队能驾驭的上限",不是 GitHub 星数。
社区走向速读
三条主线:Scala 3 成为默认、Scala 2 库加速迁移完毕;Akka 商业化后社区转向 Apache Pekko(同源分叉,API 兼容);数据工程侧 Spark 4 逐步站稳 Scala 3。给新项目的建议也随之简单:直接 Scala 3 起步、流处理优先评估 fs2 与 Pekko、大数据管道仍以 Spark 为主战场。
避坑补充:依赖治理三条军规
第一,二进制兼容看 %%与版本尾缀:Scala 2.13 与 3.0 共享后缀 _3 之前的兼容层,混用前先查兼容矩阵;第二,传递依赖每年至少清一次,dependencyTree 输出贴进评审,删掉没人用的 starter;第三,锁版本用 version.sbt 或 dependencyLock 插件,让构建可复现——这三条做到,"我机器上能跑"的尴尬能消掉大半。
社区信息源保持小而精:官方发行说明、Scala 中文社区的月度动态、两三个核心库的变更日志,足够跟上节奏;信息面铺太宽反而每个都学一半。
一个真实的选型复盘
某日志平台初创时选了最小组合:Circe 加 sttp 加 munit,三个月后需要流式接入 Kafka,评估 fs2-kafka 后只加了两个依赖就接上——因为 sttp 底层本就构建在 fs2 之上,此前的"最小够用"无意中铺对了路。反向案例是同团队另一个项目起步就上 Akka 全家桶做纯 CRUD,两年后没人能说清路由层那堆 Actor 的分工。两个项目对照出的结论与本节开头一致:选型决策链的第一问永远是"这个能力现在是刚需吗",而不是"它强不强"。
迁移期的小技巧:新旧并存的版本协商
混编 Scala 2.13 与 3 的项目里,同一个库两个版本可能同时被传递依赖拉进来。处理姿势:
// build.sbt 里显式声明统一走 2.13 兼容版,让 Scala 3 侧读 2.13 的产物 libraryDependencies += ("org.typelevel" %% "cats-core" % "2.10.0").cross(CrossVersion.for2_13Use3)
for2_13Use3 这个交叉版本标记的意思是:给 Scala 2.13 的 classpath 用,但让它被 Scala 3 代码消费。迁移期看到满屏NoSuchMethodError 先想到这一招,多半就是版本没协商好。
本节要点回顾
- 三主线:后端(Pekko/circe/Doobie)、大数据(Spark/Flink)、函数式底座(cats/ZIO)。
- Akka 与 Pekko 分家是许可证事件,新项目按协议与支持需求选边。
- ZIO vs cats-effect:一体化 vs 组合自由,先跑通再纯粹。
- 社区重心在 Scala 3,选型三问:团队、维护、许可证。