1.3 Serverless 的典型应用场景
1.3 Serverless 的典型应用场景
本节摘要:Serverless 在"事件驱动、流量不平稳、单次处理快"的场景里如鱼得水。本节给出一张场景地图——哪些是 Serverless 的主场,哪些是它的客场,并用一张矩阵帮你快速定位自己的业务。
学习目标
阅读完本节,你应当能够:
- 列出 5 个以上 Serverless 特别擅长的场景
- 列出 3 个以上明显不适合的场景并说明原因
- 用一张矩阵判断自己的业务落在哪一栏
- 理解为什么某个场景适合或不适合
一、Serverless 的主场
下面这些场景,Serverless 的优势会被放大到极致。
Web API 与移动后端。 RESTful 或 GraphQL 接口、用户登录、数据读写——这些请求往往短小、流量不平稳、需要弹性。函数处理一个请求几百毫秒,正好落在 FaaS 的甜点区。移动端的后端尤其合适,白天流量大、夜里几乎为零,"缩放至零"帮你省掉一大笔夜间空转费用。
事件处理与异步任务。 文件上传后自动生成缩略图、用户注册后发欢迎邮件、数据库变更触发下游同步——这类"某件事发生后做点事"的场景,天然就是事件驱动的,和 Serverless 是同一个模子。
实时数据处理。 日志清洗、IoT 设备遥测数据过滤、点击流分析。数据是一波一波来的,函数跟着数据量自动伸缩,比常驻的流处理服务更省。
定时与批处理任务。 每天凌晨跑一次报表、每小时清理一次临时数据。这种低频任务用常驻机器是纯浪费,用函数定时触发,跑完即归零,成本几乎可忽略。
聊天机器人与语音助手后端。 请求完全由用户行为驱动,波峰波谷明显,单次处理快,典型的事件驱动。
机器学习推理。 模型训练放在专门的 GPU 集群,但推理(拿到输入算输出)这种"短、频、弹性"的活,用函数承载很合适。
二、Serverless 的客场
下面这些场景,要么 Serverless 撑不住,要么硬撑代价太大。
长时间运行的任务。 大文件视频转码、海量数据批处理、复杂科学计算——单次动辄几十分钟几小时,超出函数执行时长上限。这种要么拆成多次触发,要么干脆用专用的批处理/容器服务。
常驻、长连接服务。 实时聊天、WebSocket 推送、多人游戏状态同步这类需要保活长连接的,函数"跑完即归零"的模型和它天然冲突。这类更适合用容器或专门的长连接服务。
极低延迟的在线接口。 比如高频交易、对 P99 延迟要求在几毫秒且极其稳定的场景,冷启动哪怕偶发一次都不可接受。
需要本地状态频繁读写的应用。 函数无状态,状态都得绕外部存储,频繁读写会让延迟和复杂度都上来。
重度依赖底层控制的场景。 需要特定硬件、内核调优、特殊网络配置的,Serverless 给不了你这些旋钮。
三、一张判断矩阵
把"流量形态"和"单次处理时长"两个维度交叉,能很快定位:
| 单次处理短(秒级) | 单次处理长(分钟级+) | |
|---|---|---|
| 流量不平稳/突发 | ✅ 最佳区(Web API、事件处理) | ⚠️ 拆分或用批处理服务 |
| 流量平稳且大 | 🟡 可用,但常驻方案可能更划算 | ❌ 不适合(超时长、成本高) |
| 流量很低/间歇 | ✅ 省钱(定时任务、内部小工具) | ❌ 不适合 |
💡 一句话口诀:"短、频、变"适合 Serverless——处理短、触发频、流量变。 占不住这三条的,多想想。
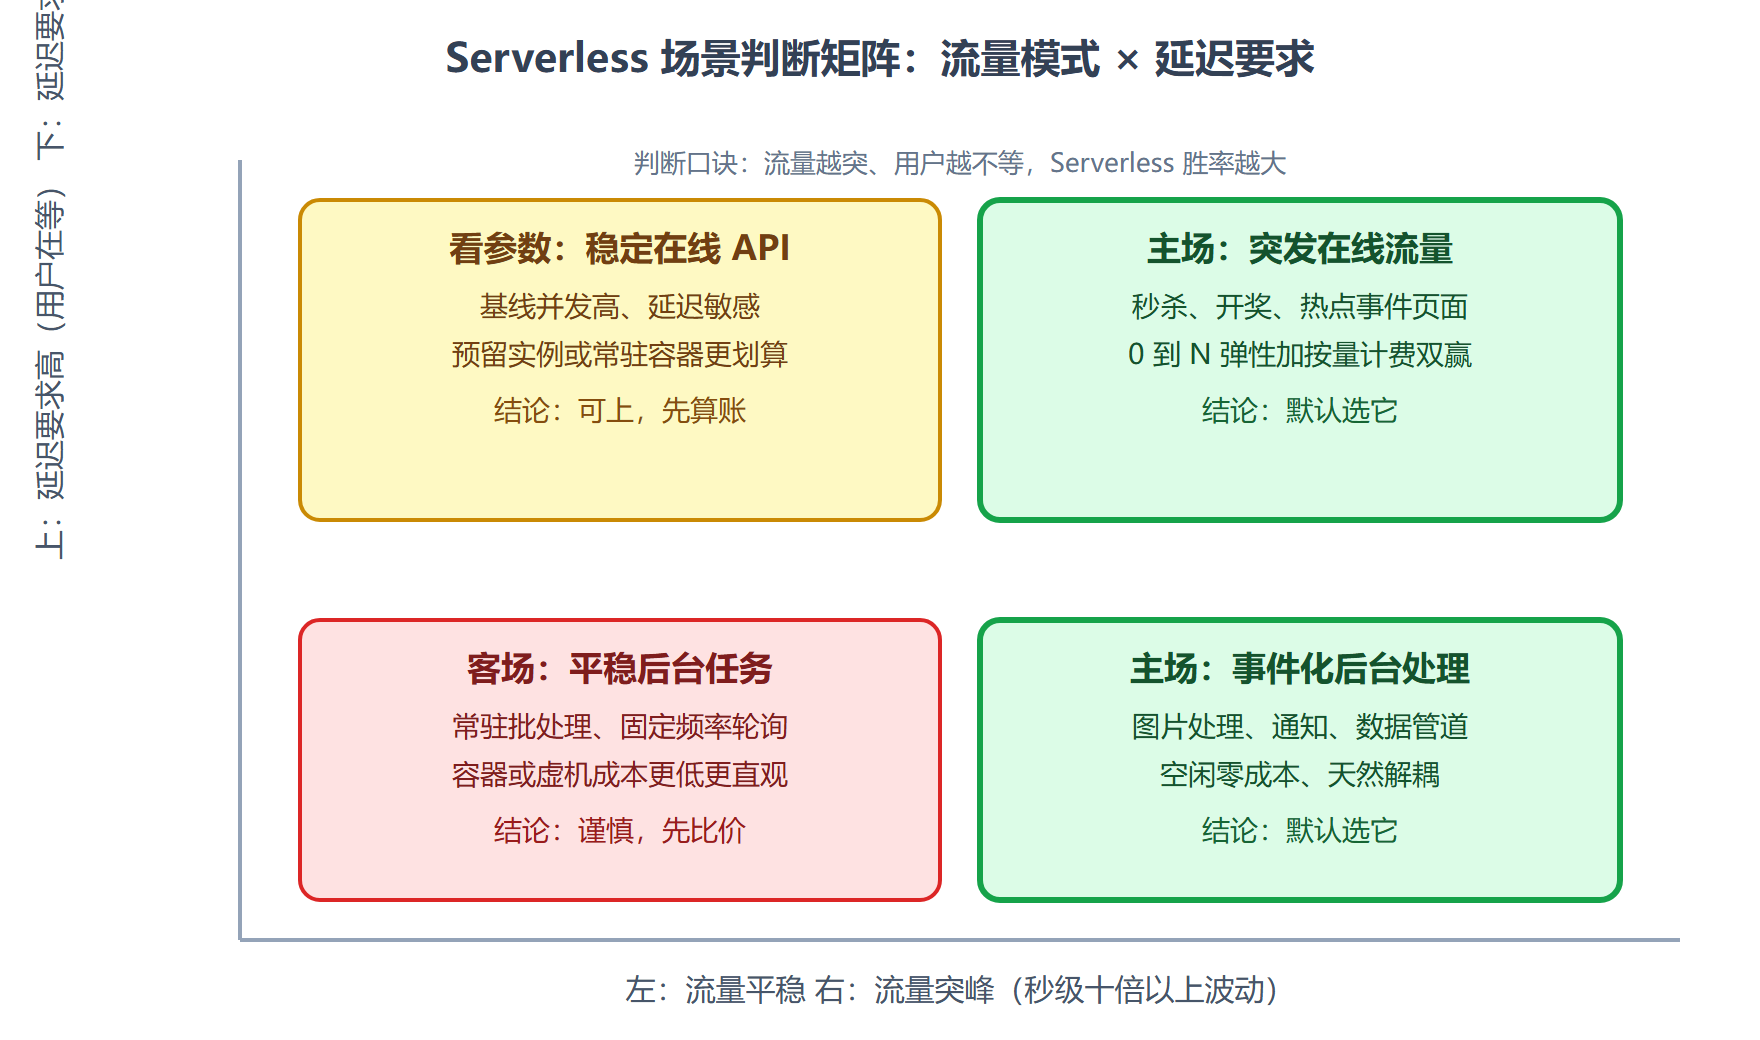
上面的表按"处理时长"切,再换一个更贴近用户体验的轴——延迟要求(用户在不在等结果)——和流量模式交叉,四个象限的结论会更直观:
图:Serverless 场景判断矩阵(流量模式 × 延迟要求)
四、别只看技术,还要看团队和成本
选 Serverless 不只是技术决策。还有两个现实因素:
一是团队技能。Serverless 要求团队会"拼服务"——配触发器、编排 BaaS、做可观测性。如果团队只会传统部署,上手有学习曲线,但一旦越过,迭代速度会明显快。
二是成本拐点。Serverless 在低流量下极便宜,但流量大到一定程度后,按调用次数 + 执行时长的计费会超过一台常驻机器的钱。每个云厂商都有"成本交叉点",过了这个点,传统方案反而更省。所以高频大流量业务上线前最好做个成本测算。
⚠️ 常见误区:以为"上了 Serverless 就一定省钱"。低频场景确实省,但高频大流量场景可能更贵——一定按自己的调用量算笔账。
五、场景的演化:昨天的客场,今天的主场
场景地图不是静态的——平台能力的演化一直在挪动主场和客场的边界,这条动态变化本身就是一部微缩的技术史。
早期最典型的例子是图片处理。函数最初的单次执行上限只有几十秒、内存也就一两 GB,视频转码彻底无缘;后来各家陆续放宽到分钟级、支持更大内存与临时磁盘,中等规模的视频处理开始进入主场,业界甚至出现了专门为 FaaS 优化的转码实践——把视频按时间切片,并行触发一批函数各转一段,最后拼接。同一个业务,从"不可能"变成"并行加速的教科书案例",靠的不是业务变化,是平台参数的演化。
另一个方向的例子是长连接。WebSocket 推送原本是铁打的客场,函数跑完即走,握不住长连接。但厂商为这块需求专门造了新组件——网关侧维持连接、消息到达时触发函数处理,函数仍是短生命周期,长连接由 BaaS 层扛住。注意这个模式的普适性:Serverless 阵营应对客场需求的惯用招数,不是把函数变长,而是造一个新的托管组件替函数扛住它扛不住的部分。 数据库连接池被专门代理接管、有状态会话被托管缓存接管,都是同一招。
💡 给读者的实操建议:判断场景适不适合,别只查今天的文档结论,再看一眼这个场景过去两年的演化方向。一个正在从客场移向主场的场景(比如流处理、状态机编排),现在切入可以吃到平台红利;一个长期稳定客场、厂商也无心投入的场景,别赌它会突然变天。
六、三个场景的深入剖析
场景一:电商大促的库存扣减接口。 流量形态是极端突发——平时每秒几十请求,大促零点每秒数万。传统架构要提前一个月压测、预扩容、活动结束再缩容,预测不准要么浪费要么宕机。函数方案下接口天然跟随流量伸缩,配合限流与队列削峰,大促前的准备从"扩机器"变成"验证配置上限和降级路径"。但要诚实指出代价:库存扣减对一致性要求高,函数无状态意味着每次扣减都要走外部存储的原子操作,热点商品的行级竞争仍要靠存储侧设计解决——Serverless 管弹性,不管你的数据模型对不对。
场景二:物联网设备数据接入。 十万台传感器每分钟上报一次,数据清洗后入库。流量是平稳的大流量,但单条处理极轻,且夜间与白天差异明显。函数按消息触发做清洗过滤,配合流式接入服务,规模从一万台涨到五十万台时接入层几乎不用改。这个场景教会人一件事:"流量平稳不适合"的刻板印象,在单次处理极轻的场景里并不成立,判断矩阵的两个维度要一起看。
场景三:企业内部的审批流后端。 一天几十个审批请求,流程包含多级会签、条件分支。这是低频场景的典型:常驻服务九成九时间在空转,函数方案成本几乎为零。但它同时也暴露了 Serverless 的一个真实短板——流程有状态(走到哪一步了、谁还没签),必须外置到状态存储或专门的编排服务,若硬用函数加数据库手搓状态机,复杂度很快失控。低频不等于简单,状态复杂度才是这类场景真正的难点。
场景判断要点
- 主场:Web API、移动后端、事件处理、实时数据处理、定时/批处理、聊天机器人后端、ML 推理。
- 客场:长任务、长连接服务、极低延迟接口、频繁本地状态、重度底层控制。
- 判断矩阵的两个维度:流量形态 × 单次处理时长。
- 口诀:"短、频、变"适合 Serverless。
- 别只看技术——团队技能和成本拐点同样要算进决策。
下一节钻进 Serverless 的两大组成 FaaS 和 BaaS,看它们各自负责什么、怎么协作。
五、场景判断的三个信号
应用场景清单之外,给三个可操作的判断信号,用于评估"这个需求适合 Serverless 吗"。信号一,流量画像:把预期流量画成时间曲线——锯齿状(峰谷比大于五比一)、偶发尖峰、明显的时段性,都是计费模型的甜区;平稳的高水位曲线则相反。信号二,任务时长与状态:单次任务在分钟级以内、任务间无共享状态(或状态可外置到托管存储),完美契合函数模型;长任务与重状态需要先做架构拆解再谈迁移。信号三,事件源丰富度:需求的触发方式天然多样(上传、消息、定时、HTTP),事件驱动的生态红利能兑现;纯长连接、纯流式场景则要谨慎评估平台的流式支持成熟度。三个信号都绿,迁移的收益基本确定;两个以上黄灯,先做单模块试点再全量。判断框架比场景清单重要的原因:清单会过时,信号不会——新平台能力层出不穷,但"负载形态决定技术形态"这条第一性原理,一直是这门技术所有决策的底座。
补充第四类高价值场景:突发流量型 API——营销页、秒杀入口、突发热点接口,流量形态是"平时涓流、峰值洪峰",按峰值备机在传统模式是巨大浪费,函数的按需扩容天然匹配;配合前端的静态化与缓存分层,这类场景常能以传统方案零头的成本扛住十倍峰值。把它加进你的场景清单,并在提案时用"峰值与均值之比"这个单一指标论证——峰均比大于十的接口,Serverless 的经济性几乎不需要额外辩护。
再补一个反例清单帮避坑:实时对战与语音视频的长连接网关(连接生命周期与函数模型相悖)、超大数据集的单机批处理(分钟级时长限制与内存天花板)、强本地状态的遗留系统(改造成本高于重写)——三类场景的常见特征是"先改造业务形态再谈 Serverless";把反例写进选型材料,能挡住大部分"看别人用了我们也上"的从众项目。
再多说一句场景判断的动态性:场景适配不是一次性结论——业务流量形态会演化(涓流变洪峰、突发变稳态),去年的甜区今年可能变成成本陷阱;建议每年用三信号重评一次核心负载,该迁回常驻架构的坦然迁回——Serverless 与传统架构是工具箱里的两把工具,切换不是失败,是对业务变化的正确响应。