3.1 主流云厂商 Serverless 平台
3.1 主流云厂商 Serverless 平台
本节摘要:主流云厂商几乎都提供函数计算服务,名字不同、模型相通。本节横向比较 AWS Lambda、Azure Functions、Google Cloud Functions、阿里云函数计算、腾讯云云函数,帮你按业务、成本、生态做选型,而不是被名字绕晕。
学习目标
阅读完本节,你应当能够:
- 说出五大云厂商各自的函数计算服务名称
- 列出各平台的特色与触发器生态
- 给出一个选型决策的考量清单
- 理解为什么"模型相通"让跨平台迁移可行(但有成本)
一、名字不同,模型相通
先破除一个心理障碍:各家函数计算服务名字五花八门,但底层模型高度一致——都是"事件触发、无状态函数、自动伸缩、按需付费",入口都是"接收 event + context、返回响应"。你在一家学会的 FaaS 思维,换一家基本通用;要重新熟悉的只是具体的 SDK、事件格式和配置语法。
| 云厂商 | 服务名 | 支持运行时(典型) | 特色 |
|---|---|---|---|
| AWS | Lambda | Python、Node.js、Java、Go、.NET 等 | 生态最全,触发器最多,事实标准 |
| Microsoft Azure | Azure Functions | Python、Node.js、Java、.NET、PowerShell 等 | 与 Azure 生态、.NET 深度集成 |
| Google Cloud | Cloud Functions | Python、Node.js、Go、Java 等 | 与 Firebase、GCP 数据产品联动紧密 |
| 阿里云 | 函数计算 FC | Python、Node.js、Java、Go、PHP 等 | 国内节点丰富,对接国内生态 |
| 腾讯云 | 云函数 SCF | Python、Node.js、Java、Go、PHP 等 | 国内节点丰富,与微信生态打通 |
二、选型考量:不只看技术
选哪家不是个纯技术问题,得综合看:
生态与触发器。AWS Lambda 的触发器生态最全(S3、DynamoDB、API Gateway、SQS、EventBridge…几乎覆盖所有 AWS 服务),如果你的应用重度依赖某家云的其它服务,那家云的函数计算就是顺理成章的选择——同云调用延迟低、配置简单、权限好管。
节点与合规。面向国内用户、要求数据不出境的应用,阿里云、腾讯云的国内节点和合规资质是刚需。面向海外用户则 AWS、Azure、GCP 更合适。
成本。各家计费粒度和免费额度不同。低流量下免费额度能覆盖很多;高流量下要按自己的调用量和执行时长分别算。别忘了把"配套 BaaS 的费用"也算进去,别只比函数本身。
团队熟悉度。团队已经重度用某家云,那就在那家云上做 Serverless 最省学习成本。为了 Serverless 单独引入一家新云,运维和账号管理的额外负担未必划算。
💡 务实建议:除非有强需求,否则跟着你现有的云走。Serverless 的价值在架构模型,不在某一家云。先把模型用好、把业务跑通,比纠结选哪家更值。
三、各家一点小特色
- AWS Lambda:最成熟,文档和社区最多。冷启动优化、Provisioned Concurrency(预热并发)等能力较全。绑 AWS 生态也最深。
- Azure Functions:.NET 用户的舒适区;Premium 计划提供预热实例缓解冷启动。
- Cloud Functions:与 Firebase 配合做移动/Web 后端特别顺;gen2 基于 Cloud Run,支持更长执行时间和并发。
- 阿里云函数计算 / 腾讯云 SCF:国内访问快;腾讯云与微信小程序、企业微信生态打通是独门优势。
四、迁移可行,但有成本
因为模型相通,跨厂商迁移是可行的——但"可行"不等于"轻松"。要重新对接的事件源、要替换的 BaaS 调用、要改写的部署配置,加起来工作量不小。所以上一章反复强调:把业务逻辑和平台 SDK 解耦,核心逻辑写成纯函数,只在入口层接平台事件对象。这样迁移时核心代码不动,只改入口适配层。
⚠️ 常见误区:把所有逻辑(包括事件解析、SDK 调用)全塞进 handler 一个函数里。一旦要迁移或换 BaaS,就得大改。把"入口适配"和"数据访问"抽薄层,业务逻辑保持干净。
五、平台格局的演化史
今天的五强格局是一段合纵连横史的产物,了解它能让"跟着现有云走"这类建议显得更有依据,也能帮你判断各家下一步往哪走。
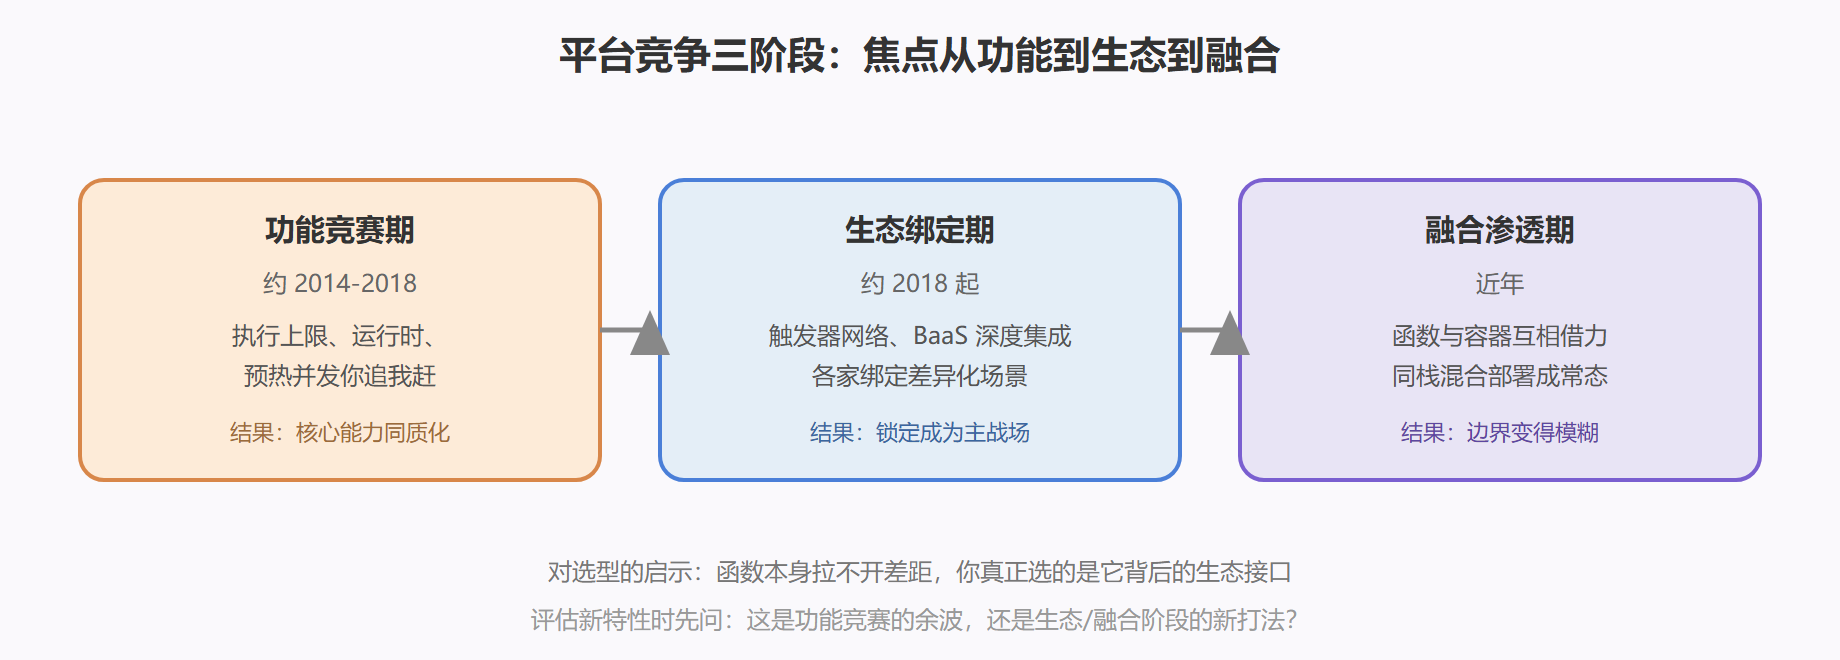
故事的开端是 2014 年 Lambda 的发布。它最初的功能放到今天看简陋得可笑:单一语言、五分钟执行上限、没有并发控制台,但它第一次把"缩放至零 + 按毫秒计费"做成商品,整个行业的中枢被击中。随后两年Azure 和 Google 相继跟进,产品形态在互相追赶中快速对齐——执行上限放宽、运行时扩充、预热并发出现,某家出的杀手特性半年内必被别家复制。这个"特性竞赛"阶段大致在 2018 年前后进入平台期,各家函数计算的核心能力趋于同质,竞争焦点转向生态。
生态阶段的打法各不相同。AWS 把函数嵌进自家几十个服务的事件网格,走"深度集成"路线;Google 押注 Firebase,把"前端直接拼后端"的 BaaS 故事讲圆;国内两家的路径与本土需求咬合——阿里云把函数计算与电商大促的弹性场景、内容处理的 media 处理管线绑定,腾讯云借微信生态打通了小程序云开发的捷径。这个阶段的启示是:选平台实际上是在选生态接口,函数计算本身已经很难拉开差距,你真正绑定的是它周围那圈 BaaS 和触发器。
再往后是"容器与函数融合"的阶段。Knative 这类开源项目试图在 Kubernetes 上复刻 Serverless 体验,云厂商则反过来让容器服务具备"缩放至零"能力,两条技术路线开始互相渗透。对用户的实际影响是:函数和容器不再是二选一——同一个应用里,事件处理的轻逻辑放函数、常驻的重服务放容器,用同一套事件总线粘合,成了混合部署的常见形态。评估平台时多看一眼它的函数与容器边界是否顺滑,就是在为这种混合形态预留空间。
图:平台竞争三阶段的焦点迁移
六、选型的三个真实场景
场景一:出海 SaaS 初创。 用户在欧美,团队三个人,没有运维。首选海外大云——节点近、合规成熟、文档社区厚。函数加托管数据库加网关的全家桶起步,月成本在几百美元内可以支撑到数千日活。要点是第一天就用 IaC 框架管理全部配置,不是为迁移,是为了三人的团队不靠口头传承基础设施。
场景二:微信小程序电商。 客户端锁死在微信生态,腾讯云 SCF 加小程序云开发的组合几乎是默认解——登录鉴权、支付回调、订阅消息这些微信侧能力与云函数的打通是别家给不了的顺畅。此场景的"选型"其实是承认约束:生态绑定在这里不是代价,是需求本身。
场景三:传统企业的内部系统改造。 已有自建机房和一个十人运维团队,想把几个审批、报表类低频系统 Serverless 化。两条路:全上公有云(省心但要过合规与数据出境的关),或在私有集群上部署开源 Serverless 平台(Knative 一类)。后者保留了"缩放至零"的体验但运维复杂度回到了自己手里——它更像是给存量团队的概念过渡。多数此类组织的现实选择是折中:低敏系统上公有云函数,核心数据留在原有体系,中间用专线与企业级事件总线缝合。
平台选型要点
- 各家函数计算名字不同、模型相通:事件触发、无状态、自动伸缩、按需付费。
- 五大厂商:Lambda / Azure Functions / Cloud Functions / 阿里云 FC / 腾讯云 SCF。
- 选型看:生态触发器、节点合规、成本、团队熟悉度——务实做法是跟着现有云走。
- 跨厂商迁移可行但有成本,靠"入口适配层 + 数据访问层 + 干净业务逻辑"缓解锁定。
下一节看帮你开发部署、并降低锁定的工具链。
五、平台能力的评估框架
厂商清单会过时,评估框架不会,给一个四维框架。维度一,事件生态的广度:平台原生触发器覆盖多少服务、第三方事件接入的成熟度——这决定"事件驱动"的生态红利能兑现几成。维度二,冷启动的实际表现:用你自己的最小函数实测(不同运行时、不同包大小),别信厂商的平均值——你的场景画像才是真相。维度三,观测与调试工具链:分布式追踪的集成深度、本地开发与远程调试的体验、日志查询的效率——开发体验的差距在项目后期会被放大十倍。维度四,成本模型的透明度:计费维度(调用次数、执行时长、内存)与预估工具的精度、免费额度的实际覆盖——"能算清账"的平台才谈得上成本治理。四维框架的使用方式:给自己的业务场景画像(流量形态、事件源、延迟要求),按维度加权打分——没有 universally 最好的平台,只有与你的画像最匹配的。选型结论建议保留评分过程,一年后平台演进了,重新评分比重新吵架便宜。
补一个多云环境的补充视角:多云部署的 Serverless 应用要额外评估"平台差异的抽象成本"——抽象层(跨平台框架)能统一开发体验,但也会挡住平台新特性的快速采用(等框架跟进)与增加一层的调试复杂度;务实的选择是"主平台深用、次平台浅用、核心逻辑与平台解耦"——解耦的正确位置在代码分层(业务逻辑纯函数化、平台粘合层薄壳化),而不是在框架层强行抹平差异。这条经验的价值在多云从"政治正确"落地为工程方案时尤其明显。
再补一个评估的公平性提醒:给平台打分时,"你熟悉的平台"总会在工具链体验维度占便宜(肌肉记忆的加成)——纠正的办法是把每个维度的评分都落到可复现的动作上(冷启动跑了什么测试、工具链完成了什么任务),评分依据可复述,直觉的加成就被挤了出去;选型的最大敌人从来不是信息不足,是对熟悉路径的偏心。
再补一条平台演进的跟踪法:订阅所选平台的版本发布说明,每季度通读一遍——新特性(新触发器、新区域、运行时更新)常悄悄改变选型时的结论(去年不够用的配额今年翻倍了);十五分钟的季度阅读,让选型决策保持新鲜度——平台在动,你的评分表也要跟着动。
补一个合同期的复评提醒:平台选型的"保质期"建议按两年管理——两年后重跑一次四维评分(平台动了你也要动),重评成本是两天,不重评的风险是把新出现的三分平台当五分用两年;把复评日期写进当初的决策备忘,让未来的你有据可依。
再补最后一个实操建议:选型试跑时务必测一次"最不喜欢的场景"——你业务里最重的那个函数(最大的包、最长的执行、最冷的启动)在候选平台上的表现,而不是只测玩具函数;平台间的差距在常规场景常常很小,在极端场景才拉开——用你自己的最坏情况选型,选出来的才是能陪你去生产的那一个。