4.1 Serverless 应用开发全流程
4.1 Serverless 应用开发全流程
本节摘要:把前几章的所有概念收口到一个可执行的流程。从需求拆解、架构设计、本地编码、部署上线,到可观测与持续优化,每一步讲清做什么、注意什么、怎么避坑。读完你能独立走通一个 Serverless 应用的完整生命周期。
学习目标
阅读完本节,你应当能够:
- 列出 Serverless 应用开发的完整步骤
- 把一个业务需求拆成"函数 + 触发器 + BaaS"
- 制定部署、监控、优化的基本策略
- 识别并规避常见工程坑
一、第 1 步:需求拆解——先想清"事件流"
很多人拿到需求就开写函数,这在 Serverless 下是反模式。正确顺序是先把事件流画出来:谁是事件源、触发哪些函数、函数调用哪些 BaaS、函数之间怎么用事件解耦。
举个例子,需求是"用户上传图片,系统自动生成缩略图并通知用户"。先拆成事件流:
- 事件源:用户上传图片到对象存储。
- 函数 A:被"对象创建"事件触发,生成缩略图,写回存储,并发一个"缩略图就绪"事件。
- 函数 B:被"缩略图就绪"事件触发,调通知服务(BaaS)告知用户。
事件流一旦画清,"要写几个函数、配哪些触发器、用哪些 BaaS"就自然浮现了。架构对了,代码就顺;架构错了,代码再好也乱。
💡 关键直觉:Serverless 设计的核心是"画清事件流",而不是"写好函数"。函数是叶子节点,事件流是骨架。
二、第 2 步:架构设计——粒度与解耦
拆函数时要拿捏粒度。太粗(一个函数干所有事)失去弹性和可维护性;太细(每个小操作一个函数)管理成本爆炸、调用链拉长。经验法则:一个函数做一件完整的业务动作,能独立测试、独立部署。
解耦原则前面讲过:函数之间用事件流转,不直接互调。需要编排复杂流程(有分支、有重试、有补偿)时上编排服务,别在函数里手写状态机。
还要定状态外置方案:哪些数据进数据库、哪些进对象存储、哪些该缓存。函数保持无状态,所有持久化都给 BaaS。
⚠️ 粒度坑:别把传统应用的一个大服务原样搬成一个函数。传统服务里的多个模块,在 Serverless 下往往该拆成多个函数 + 事件串联,才能享受弹性。
三、第 3 步:本地开发——先纯函数,再套入口
按前面说的分层写代码:
- 业务逻辑层:纯函数,输入进、输出出,不碰云 SDK。最好写、最好测。
- 入口适配层:薄薄一层,把平台事件对象解析成业务逻辑的输入,把输出包装成平台响应。
- 数据访问层:薄薄一层,封装 BaaS 调用。
先对业务逻辑层写单元测试,本地跑通;再用框架的本地调用能力套上入口层、传模拟事件联调。尽量把"必须连云"的环节留到最后,能本地解决的就本地解决,效率和质量都高。
别忘了幂等:从设计就考虑事件重复投递,靠业务唯一键去重或状态标记。
四、第 4 步:部署——配置声明 + CI/CD
用第 3 章选的框架,把函数 + 触发器 + BaaS 资源写成配置文件,一条命令部署到测试环境。建议:
- 配置进 Git,环境间用同一份配置 + 不同参数。
- CI 跑测试 → 构建 → 部署测试环境,全自动化。
- 部署后用别名/版本管理,便于灰度和回滚。
部署时特别注意权限最小化:函数的执行角色只给必需的 BaaS 权限,别图省事用全权限。
五、第 5 步:可观测——日志、指标、追踪
Serverless 不好调试,可观测必须从第一天就上:
- 结构化日志:每条日志带请求 ID,方便串起一次调用的全过程。
- 指标:调用次数、错误率、执行时长、冷启动次数,设告警。
- 分布式追踪:一个请求跨多个函数和 BaaS 时,靠追踪看清链路、定位瓶颈。
⚠️ 最大的坑:上线后才想起来加可观测。等出问题再补日志和追踪,往往定位不到根因——因为出问题那一刻没埋点。第一天就把这三件套搭好。
六、第 6 步:持续优化
上线后持续盯几个方向:
- 冷启动:观察高频函数的冷启动比例,必要时用预热并发、减小包体积、换轻运行时。
- 成本:监控按月费用,识别异常增长(某函数调用暴增可能是 bug 触发了死循环)。
- 执行时长:慢函数排查——是不是同步调用了本该异步的下游、是不是依赖太重。
- 错误率:错误突增通常是部署或上游事件格式变化引起,靠告警第一时间发现。
优化是持续的、数据驱动的循环:监控 → 发现问题 → 改代码 → 部署 → 再监控。
七、把全流程串起来
这套流程不是一次走完就定型的,而是"上线 → 监控 → 优化 → 再迭代"的循环。Serverless 的好处是每一环改动都小而快——改个函数、加个触发器、调个配置,都能独立部署,迭代节奏比传统应用快得多。
开发实践要点
- 第 1 步需求拆解:先画清事件流(事件源→函数→BaaS),再写代码。
- 第 2 步架构设计:函数粒度适中、用事件解耦、状态外置。
- 第 3 步本地开发:分层(业务逻辑/入口/数据访问),先单测纯函数。
- 第 4 步部署:配置声明进 Git + CI/CD,权限最小化。
- 第 5 步可观测:结构化日志 + 指标 + 分布式追踪,第一天就搭好。
- 第 6 步优化:盯冷启动、成本、执行时长、错误率,持续数据驱动迭代。
这是本教程的最后一节。回头看你已经从"Serverless 是什么"走到了"怎么独立交付一个 Serverless 应用"。接下来最好的练习是:挑一个你自己的小需求,按这六步走一遍,亲手部署一个函数到云上。
五、Serverless 代码的六条军规
把开发实践浓缩成六条可背诵的军规。军规一,函数无状态:任何内存与本地磁盘的状态都视为随时消失(实例回收是常态),状态外置到托管存储。军规二,幂等是义务:至少一次的触发语义下,重复执行必须无害,幂等键设计进第一版代码而不是事后补。军规三,超时与重试显式声明:函数超时、下游调用的超时与重试、重试的退避策略,三者都要显式配置——默认值是给演示用的,不是给你的生产环境。军规四,快速失败优于慢速等待:依赖不可用时快速报错触发上游重试,比拖着长连接拖垮并发好。军规五,冷启动预算前置:首字延迟敏感的函数,包体积与初始化清单在设计期就过一遍(第 2 章的对策)。军规六,可观测先行:结构化日志加追踪标记在写第一行业务代码前就位——没有观测的函数等于闭眼飞行。六条军规贴在代码评审模板里,新人的第一周就能建立正确的直觉——Serverless 的开发不难,难的是这些反直觉习惯的养成(无状态、幂等、快速失败,条条都与传统开发的"优化直觉"相反)。
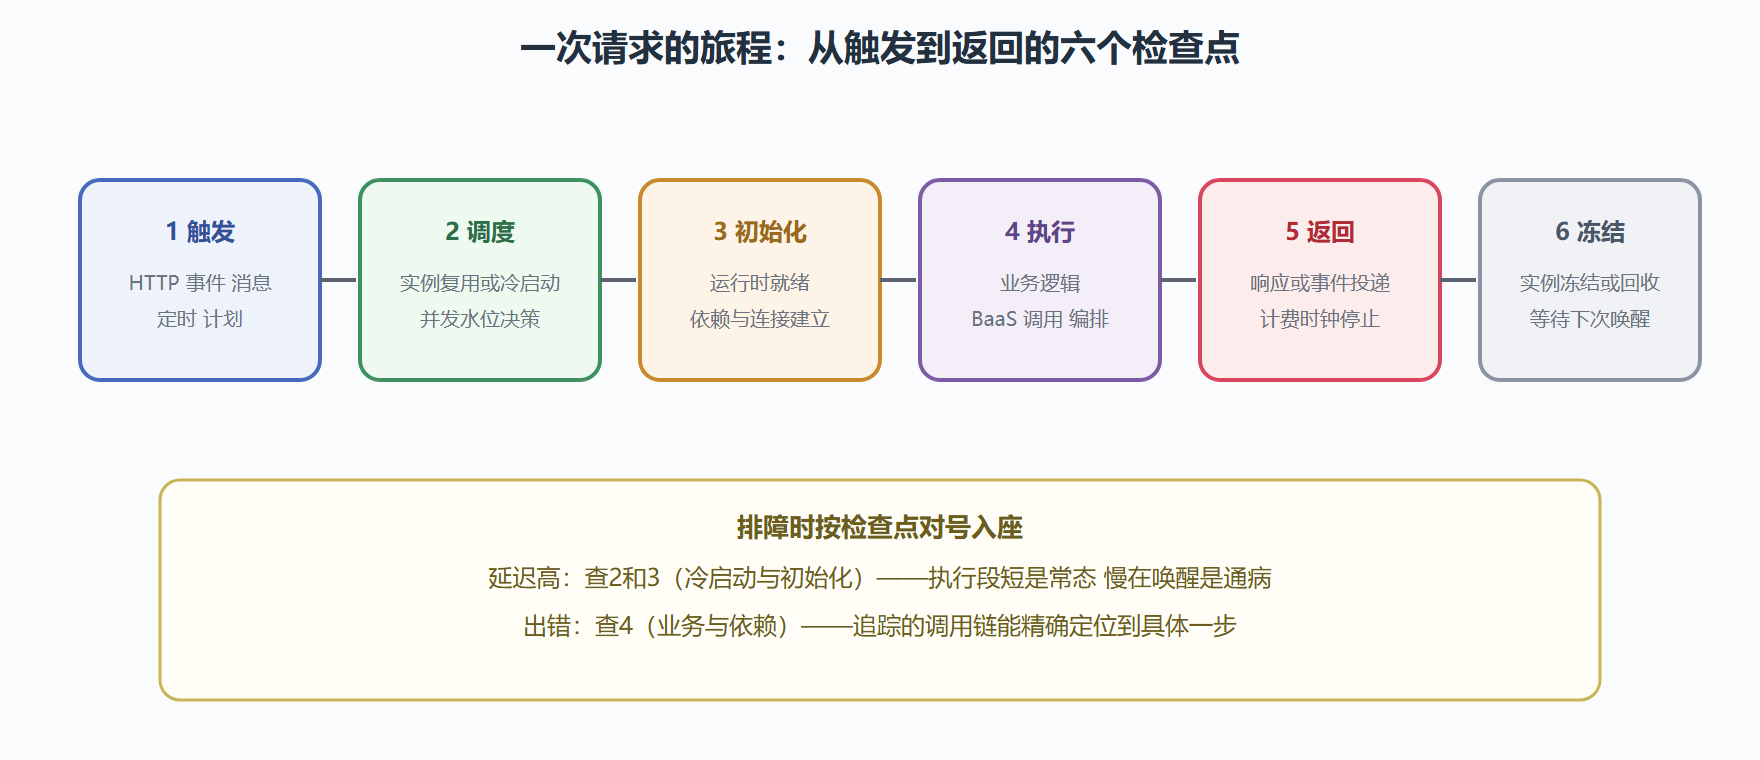
图:Serverless 应用的请求生命周期
六、一个完整的实战示例:图片处理流水线
给一个完整示例把全流程串起来。需求:用户上传图片后自动生成缩略图与水印,存回另一个桶。架构:对象存储的上传事件触发处理函数,函数读原图、生成两种尺寸、写回目标桶、发一条完成事件(下游通知函数消费)。开发:本地用事件模拟器调通主逻辑;依赖精简(图像库选用精简版,包体积控制——冷启动预算前置);初始化段建立输出桶的客户端(复用当奖励)。测试:单元层覆盖尺寸计算与命名规则;集成层用仿真事件跑全链;端到层上传真实图片验产物。部署:基础设施即代码定义函数、触发器、权限(最小策略:只读源桶、只写目标桶的两个前缀);灰度发布(按事件的一成流量路由到新版本)。观测:结构化日志记录处理耗时与产物大小;追踪贯穿"上传-处理-通知"三段;告警设在错误率与队列积压。成本:按上传量估算月账单,出口流量趋零(同区内网读写)。这条流水线是 Serverless 的"你好世界进阶版",覆盖了全书所有核心概念——建议作为你的第一个周末项目,亲手跑通它。
最后补一条全流程的加速技巧:把"可观测就绪"做成脚手架的一等公民——模板生成的项目自带日志规范、追踪接入与告警占位,第一个函数写完时观测已经在看它了;这个顺序与"先写功能后补观测"的传统习惯相反,但它是黑盒平台上的唯一安全姿势——把这条写进团队的模板仓库,全流程的其余环节都会跟着顺。
再补一条灰度的实操细节:函数的灰度按流量比例切分时,记得给两个版本打上可区分的标记(版本号进日志与追踪)——没有标记的灰度等于没灰,出问题时你分不清流量走的是谁;这个五分钟的标记动作,是灰度机制里最容易被忽略的保险丝。
再补一条环境管理的实践:至少三环境(开发、预发、生产)的隔离要彻底——独立的函数与资源命名空间、独立的密钥与权限、独立的数据;"共用生产资源省环境"的捷径是事故清单的常客——环境隔离的成本是几个前缀命名,收益是炸不到生产的安心。
最后补一句给赶时间的读者:如果只能记住全流程的一个环节,记住"部署的原子性与回滚"——它是发布信心的来源,而发布信心决定了团队的迭代胆量;其他环节的欠缺可以慢慢补,回滚没把握的团队会在每次发布前反复试探,敏捷就死在这份犹豫上。
最后再补一条环境变量的实践细节:配置项全部走环境变量与配置服务、绝不硬编码——函数的代码在版本间不可变,环境却要多变(不同环境、不同区域、灰度开关);把"代码不变、配置万变"当成铁律,回滚与灰度才有干净的抓手——配置纪律是全流程里最便宜也最常被忽视的那块基石。