1.1 表、行、列与主键:数据的安放方式
1.1 表、行、列与主键:数据的安放方式
本节摘要:关系型数据库把数据组织成一张张二维表——列定义"存什么",行承载"一条记录",主键给每行一个身份证。理解表结构是写任何 SQL 之前的第一步,本节用一张图书表把这套结构讲透,并解释为什么 Excel 思路在这里会碰壁。
一、从一张图书名册说起
想象你在管理一家网上书店的库存。最直觉的做法是建一张 Excel:第一行写"编号、书名、分类、价格、库存",下面每一行填一本书。关系型数据库的第一直觉和你完全一样——它把数据放进表(table),表里每一列(column)规定一类信息,每一行(row)承载一条完整记录。所谓"关系模型",说白了就是"用规范的二维表存数据,表与表之间靠共同的列建立联系"。
但只要继续往下用,Excel 和数据库很快分道扬镳。Excel 允许你在价格列里随手输入"待定",允许两本书用同一个编号;数据库则会在建表时就把规则写死:价格必须是数字,编号必须唯一。这个差别决定了后面所有 SQL 的行为——列的类型和约束先于数据存在,写错了不是"格式不好看",而是直接被数据库拒绝。
先看一张真实存在的表长什么样。连接数据库后问它要表结构:
-- 查看当前库中有哪些表 SHOW TABLES;
+---------------------+ | Tables_in_bookstore | +---------------------+ | books | +---------------------+
-- 查看 books 表的结构:每一列的名字、类型、是否可为空、键信息 DESCRIBE books;
+--------------+-----------------------+------+-----+---------+----------------+ | Field | Type | Null | Key | Default | Extra | +--------------+-----------------------+------+-----+---------+----------------+ | id | int unsigned | NO | PRI | NULL | auto_increment | | title | varchar(120) | NO | | NULL | | | category_id | int unsigned | NO | MUL | NULL | | | price | decimal(10,2) | NO | | NULL | | | stock | int unsigned | NO | | 0 | | | published_at | date | YES | | NULL | | +--------------+-----------------------+------+-----+---------+----------------+
DESCRIBE 的输出就是一张"表的身份证":六列字段,每列有名字、类型、能否为空、默认值。PRI 标记的 id 列是主键,MUL 标记的 category_id 上建了普通索引(第 10 章细讲)。看到一张陌生表,第一件事永远是 DESCRIBE 它——这相当于动手之前先看清地形。
二、主键:每一行的身份证
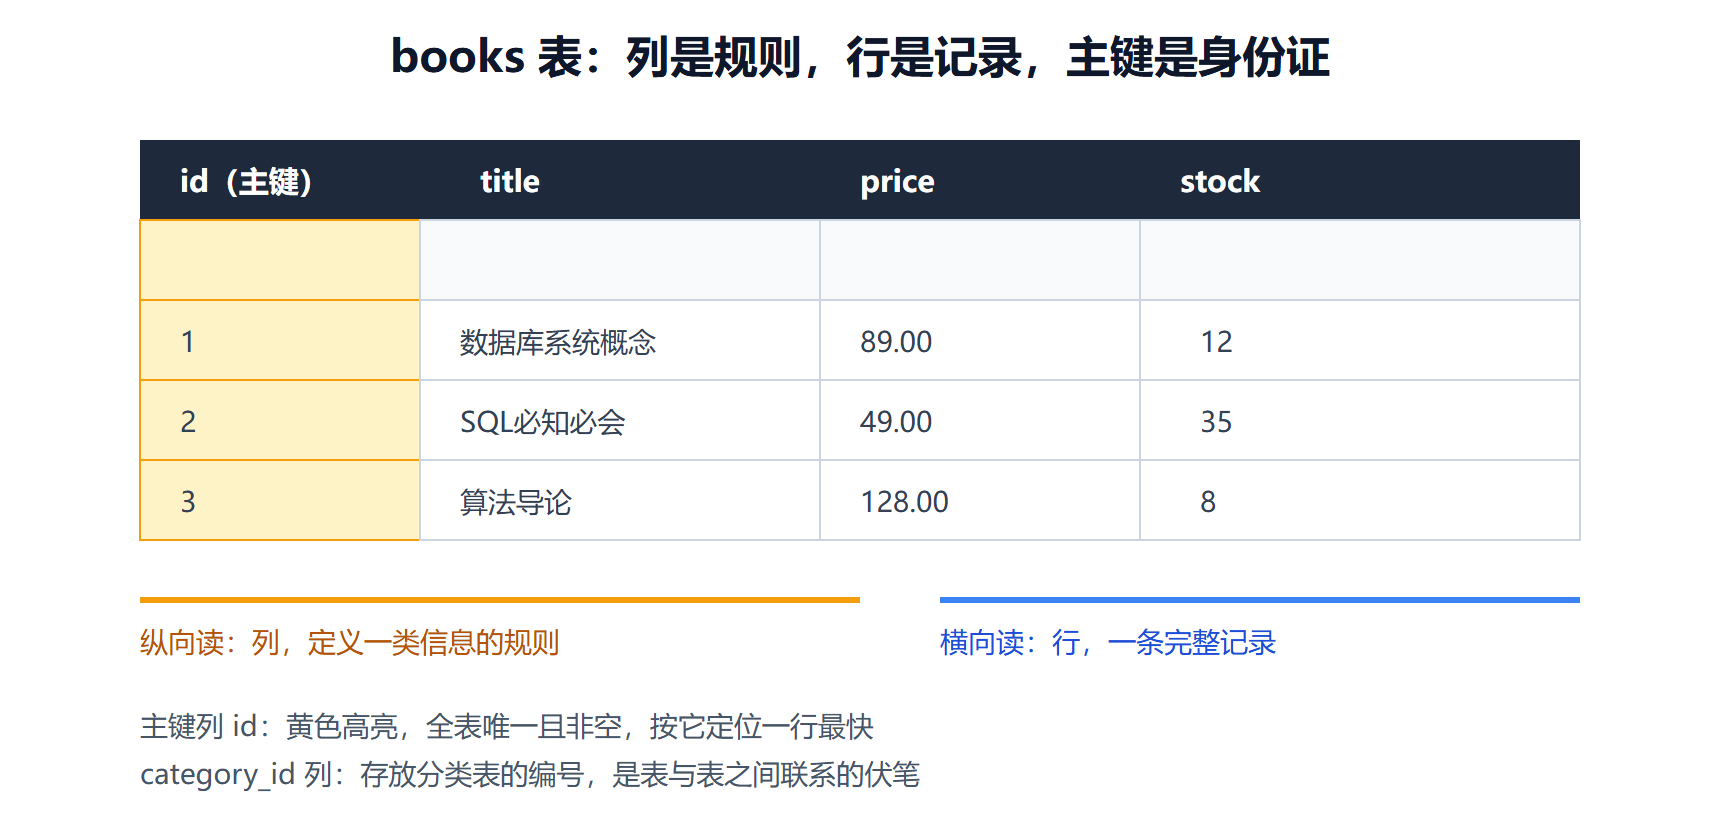
三万本书的表里,怎么指认"某一本"?书名会重复,价格会变动,库存天天在改。主键(PRIMARY KEY)解决的就是"行的唯一标识":它的值在整张表里不重复、不为空,并且数据库会自动为它建索引,按主键找一行数据极快。
上表里 id 列的 auto_increment 是 MySQL 的常见做法——你不必自己编号,插入一行时数据库自动分配 1、2、3……这种"和数据本身无关、专门用来当标识"的主键叫代理键。与之相对,如果用身份证号、ISBN 这类现实世界中本来就唯一的列当主键,叫自然键。工程上更倾向代理键:ISBN 可能重号、可能修订换号,而 id 一经分配永不变更,业务怎么折腾都不影响数据库内部的关系。
两类主键的取舍:
| 主键类型 | 例子 | 优点 | 风险 |
|---|---|---|---|
| 代理键 | 自增 id | 稳定、无业务含义、永远够用 | 需要多 join 一次才能拿到业务字段 |
| 自然键 | ISBN、身份证号 | 直观,少建一列 | 现实规则一旦变化(换号、重号)整库跟着遭殃 |
还有一种情况:单列撑不起唯一性。订单明细表里"订单号 + 行号"合在一起才唯一,这时可以把两列共同声明为主键,称为复合主键。判断标准只有一条:这几列的组合是否在任何情况下都不重复。
图 1-1 一张表的结构解剖
三、行与列的阅读纪律
写 SQL 之前养成两个阅读习惯,后面能少踩很多坑。
第一,纵向想规则,横向想事实。看到 price decimal(10,2),读出两层信息:这一列只接受数字(规则),每行在这里记录这本书的价格(事实)。后面学到 WHERE 过滤时,你会发现过滤条件永远作用在"列"上——"价格大于 50 元"筛选掉的是一整行一整行的书,而不是把价格列里的某些格子抠掉。
第二,行没有内在顺序。Excel 里第 3 行永远在第 5 行上面,但数据库的表是一堆行的集合,谁先谁后没有承诺。今天查出来 id=1 排在最前,明天磁盘整理后可能就换了个位置。想让结果有序,必须在查询里用 ORDER BY 明说——这也是 1.3 节的伏笔:没有 ORDER BY 的查询,结果顺序不可依赖,把分页逻辑建立在默认顺序上迟早出事故。
顺手做第一次"取数",感受行的存在:
-- 从 books 表取出所有行、所有列,先睹为快 SELECT * FROM books;
+----+-----------------------+-------------+----------+-------+--------------+ | id | title | category_id | price | stock | published_at | +----+-----------------------+-------------+----------+-------+--------------+ | 1 | 数据库系统概念 | 1 | 89.00 | 12 | 2019-03-01 | | 2 | SQL必知必会 | 1 | 49.00 | 35 | 2020-06-15 | | 3 | 算法导论 | 2 | 128.00 | 8 | 2012-01-01 | +----+-----------------------+-------------+----------+-------+--------------+
三行数据,六列信息,主键 id 清晰可辨。注意 published_at 的类型是 date,允许为空(Null 列显示 YES)——某本书还没定出版日期时可以先不填,这个"没填"在 SQL 里叫 NULL,它是第 3 章的主角之一,现在只需记住:NULL 不是 0,也不是空字符串。
⚠️ 常见坑:把 Excel 的"合并单元格"习惯带进数据库。表里不存在"某个格子横跨三行"的说法,每行必须独立完整;想让多行共享信息,正确做法是另建一张表存共享部分,再用编号关联——这正是第 5 章"拆表"的起点。
本节要点回顾
- 表由列和行构成:列在建表时定义类型与约束,行是运行期不断追加的记录;
- 主键唯一且非空:代理键稳定无业务含义,自然键直观但受现实规则牵制,复合主键用于单列撑不起唯一性的场景;
- DESCRIBE 是看清地形的第一步:陌生表先看结构再写查询;
- 行没有内在顺序:需要顺序就必须 ORDER BY,分页逻辑不能建立在默认顺序上;
- NULL 是"未知/未填":既不是 0 也不是空串,遇到它的判断规则第 3 章展开。
下一节把镜头从"一张表"拉远到"一门语言":SQL 究竟由哪几类语句组成,为什么它被称为声明式语言。