1.4 建库建表与数据类型:搭好全书练习场
1.4 建库建表与数据类型:搭好全书练习场
本节摘要:CREATE DATABASE 与 CREATE TABLE 属于 DDL,是搭建练习场的手艺。本节从"图书电商该存哪些信息"倒推出七张表的骨架,建出核心的 books 表,并讲清字符串、数值、日期三大类数据类型的选型规则——类型选错,轻则浪费存储,重则精度丢失、比较失真。
从一个需求倒推建表
开一家网上书店,业务能说出来的事实有这些:书有书名、定价、库存、出版日期;书属于某个分类,分类还能套子分类;顾客有昵称、所在城市、会员等级;顾客下单生成订单,订单包含多本书各买几本;内部还有员工与部门,员工有上级。把这些事实拆开,尽量让一张表只描述一类实体,就得到全书练习场的骨架:
- books 存书,categories 存分类,customers 存顾客;
- orders 存订单头,order_items 存订单明细(一个订单多本书);
- employees 存员工,departments 存部门。
为什么不建一张"什么都有"的大宽表?直觉的回答是"会重复到爆炸":一本《算法导论》被买过一百次,书名和定价就在大表里抄一百遍,改个定价要更新一百行。严格论证要等到第 5 章的范式理论,现在先记住工程结论:拆表是常态,大宽表是临时拼出来的查询结果。
建库、切库、建分类表,三步走:
-- 建库:IF NOT EXISTS 防止重复执行时报错 CREATE DATABASE IF NOT EXISTS bookstore DEFAULT CHARACTER SET utf8mb4; -- utf8mb4 才能存 emoji 与生僻字 USE bookstore; -- 切换到 bookstore,后续语句都在这里执行 -- 分类表:parent_id 指向本表,形成"分类树",第8章递归查询的主角 CREATE TABLE categories ( id INT UNSIGNED PRIMARY KEY AUTO_INCREMENT, name VARCHAR(50) NOT NULL, parent_id INT UNSIGNED NULL, CONSTRAINT fk_cat_parent FOREIGN KEY (parent_id) REFERENCES categories (id) );
Query OK, 1 row affected (0.03 sec) -- 建库成功 Database changed -- 切库成功 Query OK, 0 rows affected (0.10 sec) -- 建表成功
三大类数据类型的选型规则
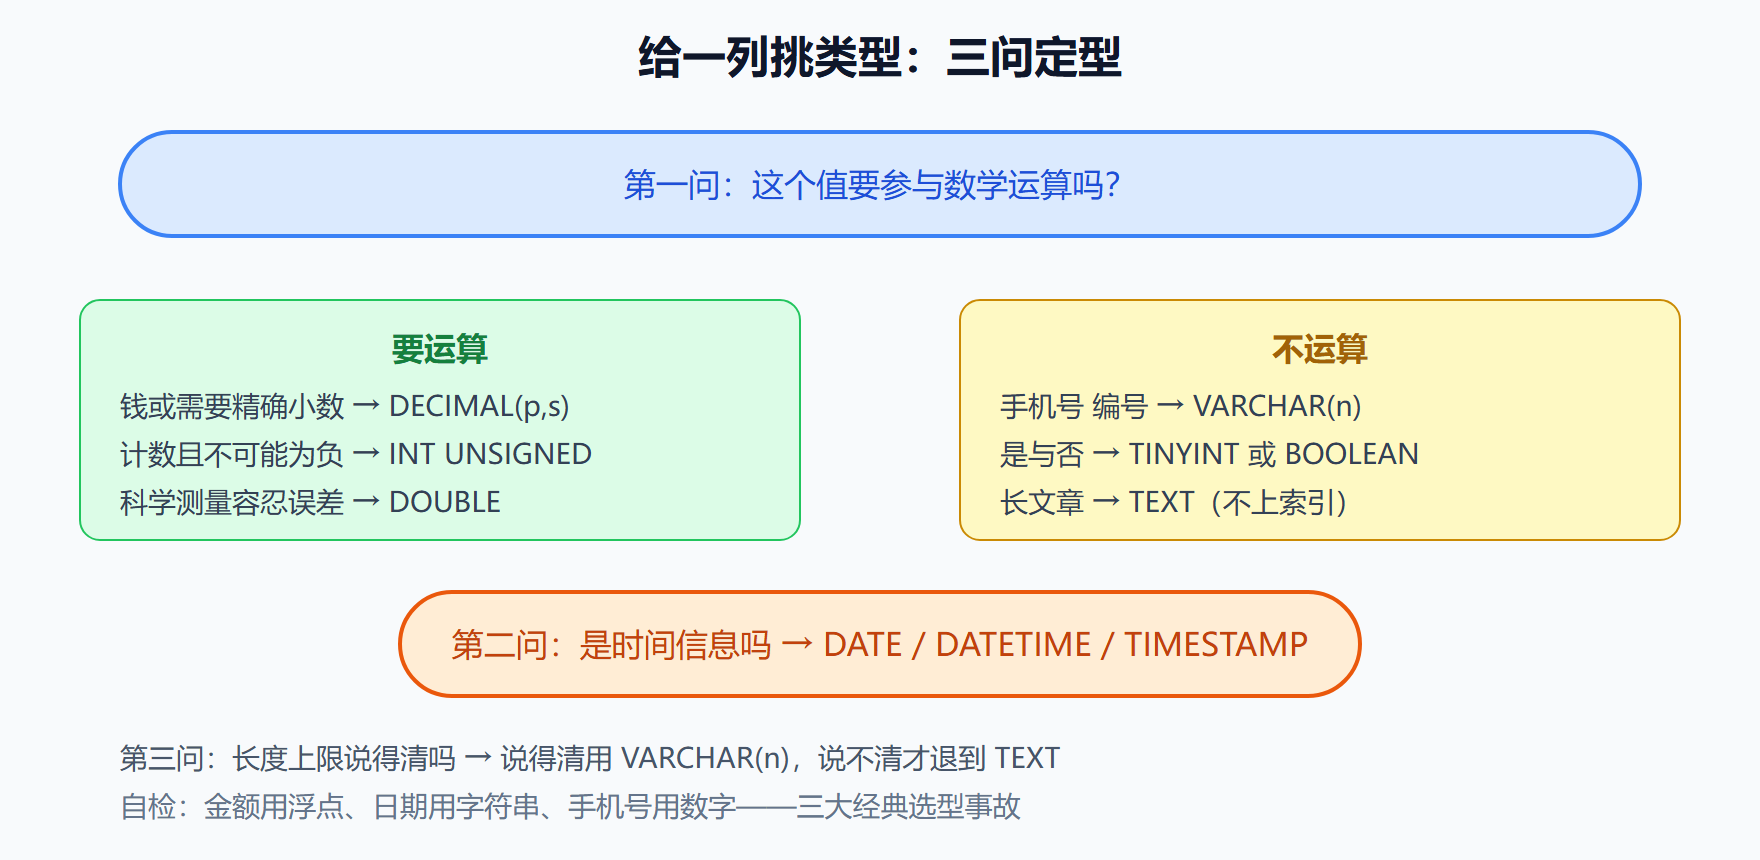
类型系统的全部要点可以压进一张对照表:
| 业务信息 | 该用什么 | 反面教材 | 后果 |
|---|---|---|---|
| 书名、昵称 | VARCHAR(n) | TEXT 起步 | TEXT 难建索引、排序慢;能定长上限就用 VARCHAR |
| 定价、金额 | DECIMAL(10,2) | FLOAT/DOUBLE | 浮点有二进制舍入误差,0.1 加 0.2 不等于 0.3,对账必翻车 |
| 库存、数量 | INT UNSIGNED | INT | 负库存本就不该存在,UNSIGNED 直接挡住 |
| 出版日期 | DATE | VARCHAR 存"2023年5月" | 字符串日期没法比大小、没法算间隔 |
| 是否上架 | TINYINT(1) 或 BOOLEAN | CHAR 存"是/否" | 布尔语义清晰,索引友好 |
| 手机号 | VARCHAR(11) | BIGINT | 号码可能带前导零且永不参与运算,本质是字符串 |
这张表里最值得展开的是金额必须用 DECIMAL。FLOAT 与 DOUBLE 是二进制浮点,十进制的 0.1 在二进制里是无限循环小数,存储必然舍入。做一次实验:
-- 浮点误差演示:两个看似相等的结果差了一个极小值 SELECT 0.1 + 0.2 AS float_sum, -- 浮点加法 0.1 + 0.2 = 0.3 AS float_equal, -- 浮点比较:竟然不相等 CAST(0.1 AS DECIMAL(10,1)) + CAST(0.2 AS DECIMAL(10,1)) AS dec_sum, CAST(0.1 AS DECIMAL(10,1)) + CAST(0.2 AS DECIMAL(10,1)) = 0.3 AS dec_equal;
+-----------+-------------+---------+----------+ | float_sum | float_equal | dec_sum | dec_equal | +-----------+-------------+---------+----------+ | 0.30000000000000004 | 1 | 1 | +-----------+-------------+---------+----------+
float_equal 一列输出 0(假):0.1 + 0.2 在浮点世界里比 0.3 大了约百万亿分之四。单看微不足道,但订单金额按分对账时,误差累积到几分钱就是客诉与资损。DECIMAL(p, s) 中 p 是总位数、s 是小数位数,DECIMAL(10,2) 精确表示十位整数加两位小数,账务系统的标配。
日期类型同样有层次:DATE 只有日期,DATETIME 日期加时间(与时区无关),TIMESTAMP 日期加时间且随会话时区换算(存储为 UTC)。订单的创建时间如果面向全球用户展示,TIMESTAMP 更合适;出生日期这种纯日期信息用 DATE 足够。
图 1-4 数据类型选型决策图
把 books 表建出来
类型规则在手,书的表结构水到渠成:
-- 图书表:全书最核心的表,第2章起所有章节都在它上面做实验 CREATE TABLE books ( id INT UNSIGNED PRIMARY KEY AUTO_INCREMENT, title VARCHAR(120) NOT NULL, -- 书名:有上限的字符串 category_id INT UNSIGNED NOT NULL, -- 所属分类,关联 categories price DECIMAL(10,2) NOT NULL DEFAULT 0.00, -- 定价:精确小数 stock INT UNSIGNED NOT NULL DEFAULT 0, -- 库存:非负整数 published_at DATE NULL, -- 出版日期:可能未定 CONSTRAINT fk_book_cat FOREIGN KEY (category_id) REFERENCES categories (id) );
Query OK, 0 rows affected (0.09 sec)
注意三处细节。其一,price 带 DEFAULT 0.00,插入时漏给价格也不会报错,而是落到默认值——默认值是"兜底"不是"逃避校验",该 NOT NULL 的列照样 NOT NULL。其二,published_at 允许 NULL,因为"尚未出版"是真实存在的业务状态。其三,外键约束 fk_book_cat 声明"category_id 必须是 categories 里真实存在的 id",往 books 插一个不存在的分类号会被数据库当场拒绝。外键是数据准确性的最后防线,代价是写入时多一次检查——第 5 章讨论拆表时会重新权衡这笔账。
改表结构用 ALTER,试一次再加回去:
-- ALTER:给 books 加一列"作者" ALTER TABLE books ADD COLUMN author VARCHAR(80) NULL AFTER title; -- 看一眼新结构(节选) DESCRIBE books;
+--------------+-----------------------+------+-----+ | Field | Type | Null | Key | +--------------+-----------------------+------+-----+ | id | int unsigned | NO | PRI | | title | varchar(120) | NO | | | author | varchar(80) | YES | | | category_id | int unsigned | NO | MUL | +--------------+-----------------------+------+-----+
⚠️ 常见坑:在大表上 ALTER 可能锁表很久,几千万行的表加一列足以让线上请求排队超时。生产环境的结构变更要走"影子表 + 切换"或数据库自带的在线 DDL,这是第 10 章结构优化的话题。
本节要点回顾
- 一类实体一张表:大宽表是查询拼出来的结果,不是存储的形态,拆表的理论依据见第 5 章范式;
- 金额必须 DECIMAL:浮点的二进制舍入误差在对账场景是事故,VARCHAR 存日期则是把自己关在时间计算门外;
- UNSIGNED 表达业务约束:库存、数量这类天然非负的字段,用类型把负数挡在门外;
- 默认值兜底、NOT NULL 立规、外键护关联:三者各管一段校验,互相不能替代;
- ALTER 能改结构但要敬畏锁表:大表变更前先想清楚执行计划与窗口期。
练习场搭好了,表还空着。下一章开始灌数据:INSERT 的四种姿势、UPDATE 与 DELETE 的安全操作,把阶梯的第二级踩实。